
- 準備:文字のバイグラムモデル
- 問題:確率がゼロになる
- ラプラス平滑化(回数に基づく対処)
- L2正則化(ニューラルネットワークでの同等物)
- 正則化の種類
- 実際にはどう選ぶか
- なぜL1はスパース性を生むのか
Andrej KarpathyのZero to Heroシリーズに取り組んでいます。具体的には、文字単位の言語モデルをゼロからつくるmakemoreの講義です。この講義では、ラプラス平滑化とL2正則化が、ほとんど余談として簡単に紹介されます。コードを動かすにはそれで十分ですが、正則化とは実際には何なのかを理解したくなりました。
修士課程で機械学習を学んだものの、身についたのは表面的なイメージでした。「正則化は過学習を防ぐ。ペナルティ項を加える。迷ったらL2」というものです。でも、L2がなぜ重みが大きくなりすぎるのを防ぐのか、なぜL1は一部の重みをちょうどゼロにまで押しやり、L2はそうしないのかは、なぜそうなるのかを説明できませんでした。この記事は、そのすき間を埋めるために自分で掘り下げた記録です。
準備:文字のバイグラムモデル
最も単純な形のmakemoreモデルはバイグラムモデルです。1つの文字が与えられたら、次に来る可能性が最も高い文字を予測します。学習させるには、学習データの中で文字のペアがそれぞれ何回現れるかを数えます。たとえば、tの後にhが来る回数や、qの後にuが来る回数です。その回数を27×27の行列N(特別な開始・終了トークンを含め、文字ごとに1行・1列)に入れます。各行を正規化すると、確率分布が得られます。
P = N.float()
P = P / P.sum(1, keepdim=True) # each row sums to 1するとP[i][j]は、文字iの後に文字jが来る確率になります。単純で解釈しやすいのですが、問題が1つあります。
問題:確率がゼロになる
ある文字のペアが学習データに一度も現れなかった場合、Nの中のその回数はゼロになり、P[i][j] = 0になります。これで2つのことがうまくいかなくなります。
- 過信。 たまたま学習データに出てこなかっただけなのに、モデルはある遷移が絶対に起こらないと確信してしまいます。これが過学習につながります。モデルは学習データを丸暗記しているだけなのです。
- 損失が発散する。 損失は負の対数尤度
-log(P[i][j])として計算します。P[i][j] = 0のときlog(0)は負の無限大になり、モデルは学習できません。
ラプラス平滑化(回数に基づく対処)
回数のレベルでの対処は単純です。正規化する前にすべての回数に1を足し、どのバイグラムも少なくとも1回は見たことにするのです。
# Before
P = N.float()
P = P / P.sum(1, keepdim=True)

# After (Laplace smoothing)
P = (N+1).float()
P = P / P.sum(1, keepdim=True)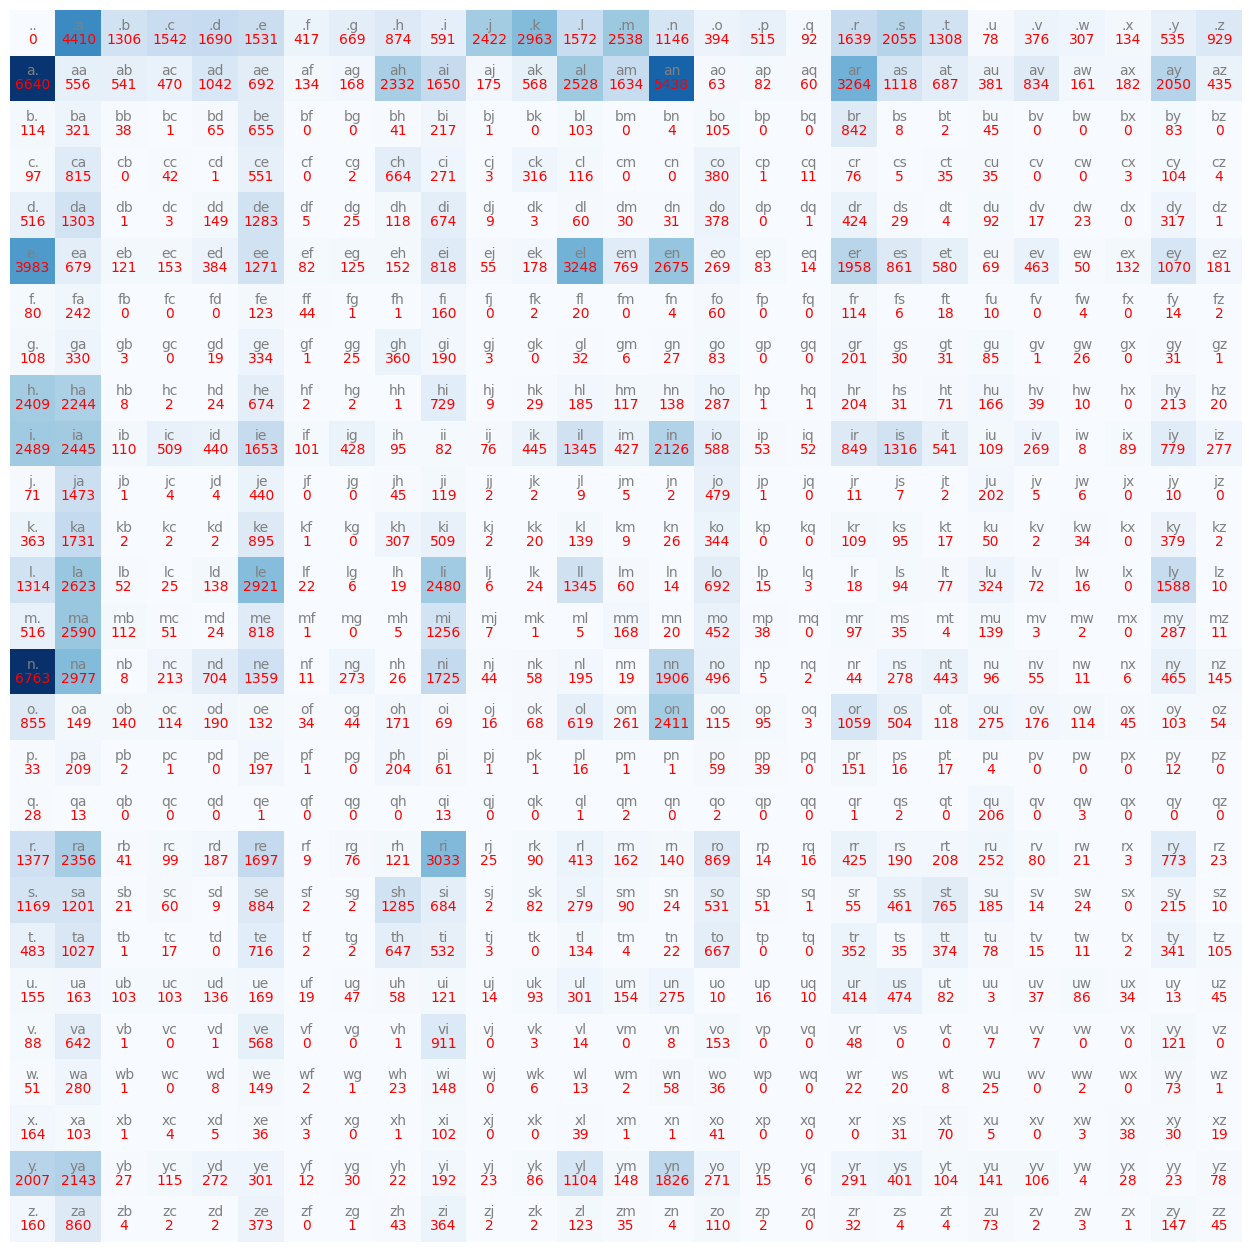
これで、どの文字のペアにも、小さいながらゼロではない確率が割り当てられます。+1は平滑化の強さです。+0.1にすると平滑化は弱くなり、+10にすると一様分布に近づきます。
回数に基づくモデルでは、これでうまくいきます。ところが、勾配降下法で学習するニューラルネットワークに移ると、足し算をする回数の行列がありません。同じ考え方を、損失関数の言葉で表す必要があります。
L2正則化(ニューラルネットワークでの同等物)
ニューラルネットワーク版では、モデルは重み行列Wを学習します。生の予測値(ロジット)はlogits = xenc @ Wで、xencはone-hotエンコードされた入力文字です。ロジットはソフトマックスを通って確率になります。
正則化がなければ、損失は負の対数尤度そのものです。
xenc = F.one_hot(torch.tensor(xs), num_classes=27).float()
logits = xenc @ W
counts = logits.exp()
probs = counts / counts.sum(1, keepdim=True)

loss = -probs[torch.arange(len(xs)), ys].log().mean()
L2正則化を加えると、ペナルティ項が付け足されます。
loss = -probs[torch.arange(len(xs)), ys].log().mean() + 0.01*(W**2).mean()それぞれの部分の役割は次のとおりです。
仕組みとしては: ペナルティはWのすべての重みを2乗し、その平均をとって、小さな定数(0.01)を掛けます。その値が損失に加えられます。
拮抗する2つの圧力: 勾配降下法は損失の合計を最小化するので、ネットワークには互いに引っ張り合う2つの目的ができます。
- 予測を正確にする:負の対数尤度を最小化する。
- 重みを小さく保つ:
0.01*(W**2).mean()を最小化する。
大きな重みが過学習を招く理由: ペナルティがなければ、ネットワークが重みを非常に大きな正や負の値に押しやるのを止めるものは何もありません。そうなると予測確率は限りなく1.0や0.0に近づきます。モデルは学習データについて極端に自信を持つようになり、新しいデータにはうまく汎化できなくなります。
平滑化の効果: 重みをゼロの方向へ押しやると、ロジット(xenc @ W)もゼロに近い値にとどまります。ゼロに近いロジットをソフトマックスに通すと、ほぼ一様な分布、つまり27文字の語彙なら1文字あたり約になります。これは、ラプラス平滑化で回数に+1を足すこととまさに同じ働きです。どの遷移にもほぼゼロの確率が割り当てられることはなく、その効果の強さを0.01という定数が決めています。
L2正則化は、回数に基づくモデルでラプラス平滑化が解決したのと同じ問題に対する、ニューラルネットワークの解決策なのです。
正則化の種類
L2が最も一般的な形ですが、ほかにも知っておく価値のあるものがあります。
L2正則化(リッジ / 重み減衰)
数式: alpha*(W**2).mean()
効果: すべての重みをゼロの方向へ縮めますが、ちょうどゼロにすることはほとんどありません。2乗すると大きな値が増幅されるので、ペナルティは大きな重みには厳しく、小さな重みには甘く働きます。重みの重要度は、少数の大きな値に集中するのではなく、多くの小さな値に分散されます。
使いどころ: 標準の選択肢です。迷ったらL2を使います。
L1正則化(ラッソ)
数式: alpha*(W.abs().mean())
効果: これも重みをゼロの方向へ縮めますが、その多くを積極的にちょうどゼロにします。ペナルティが2次ではなく1次なので、小さな重みも大きな重みと同じ割合で厳しく罰せられ、ゼロへ引っ張る力が弱まることがありません。その結果、多くの重みが完全に消えたスパースなモデルになります。
使いどころ: 特徴選択をするときです。何千もの入力(遺伝子発現、アンケートの回答など)があり、実際に予測に役立つのはほんの一握りという場合、L1は役に立たない入力をゼロにし、より小さく解釈しやすいモデルを残してくれます。
Elastic Net
数式: alpha*(W.abs().mean()) + beta*(W**2).mean()
効果: L1とL2を組み合わせたものです。スパース性を促しつつ、特徴量どうしに相関があるときにはL2のなめらかなふるまいを保ちます。L1だけだと、2つの特徴量がほぼ同じ場合に不安定になることがあり、一方を恣意的にゼロにしてもう一方を残してしまいます。Elastic Netは、これをもっとうまく扱えます。
使いどころ: 強く相関した入力があり、スパースな出力がほしいのに、L1だけでは予測しにくいふるまいをするときです。その代わり、調整するハイパーパラメータが1つではなく2つ(alphaとbeta)になります。
実際にはどう選ぶか
- まずはL2から。 Transformer、ResNet、LLMといった現代のディープラーニングでは、L2の重み減衰が標準で、オプティマイザに直接組み込まれていることもよくあります(
AdamWを参照)。 - 解釈しやすさが大事ならL1に切り替える。 表形式のデータでデータサイエンスを行い、どの変数が実際に結果を左右しているのかを明らかにしたいとき、L1はそれを自動的にやってくれます。
- 埋め込みにはL1を避ける。 言語モデルでは、埋め込みのどの次元も意味のかけらを担っています。それをゼロにしてしまうL1の性質は、利点ではなく欠点になります。L2に、DropoutやLayer Normalizationといったアーキテクチャ上の正則化を組み合わせるのがよいでしょう。
なぜL1はスパース性を生むのか
L1は重みをちょうどゼロにまで押しやるのに、L2は小さくするだけなのはなぜか。これは、それまで明快に説明されたのを見たことがない点でした。答えは、ゼロ付近でのペナルティの形にあります。
オプティマイザが最小化しているのは次の値です。
Total Loss = Prediction Error + Penalty
すべてがゼロにはならない理由: すべての重みが0.0になればペナルティはゼロになりますが、ネットワークはどの予測でもでたらめな推測をすることになります。予測誤差が非常に大きくなるので、損失の合計は増えてしまいます。実際に役に立っている重みが、ゼロにされることはありません。
重みごとの損得勘定: ネットワークはどの重みについても、暗黙のうちにこう問いかけています。「この重みを残すことで減る予測誤差は、払うペナルティより大きいか」
- 役に立つ重み(たとえば
qとuをつなぐ重み):取り除くと予測誤差が跳ね上がります。ネットワークはペナルティを払ってでも残します。 - 役に立たない重み(たとえば
qとxをつなぐ重み):あってもなくても精度にはほとんど影響しません。ネットワークは、この重みは割に合わないと判断し、0.0に落とします。
L1はゼロに届き、L2は届かない理由:
L2では、ペナルティは重みの2乗に比例します。重みが小さくなるにつれ、ペナルティは2次関数的に小さくなり、0.001の重みにかかるペナルティはわずか0.000001です。さらに小さくしようとする圧力はほとんど消えてしまうので、L2が完全なゼロに届くことはまずありません。
L1では、ペナルティは重みの絶対値に比例します。0.001の重みにも、0.001のペナルティがかかったままです。重みがどれだけ小さくなっても、ゼロへ引っ張る力は弱まりません。役に立たない重みは、ちょうど0.0まで引きずられていきます。役に立つ重みは、それがもたらす予測精度がペナルティを上回るところで釣り合って落ち着きます。
ゼロ付近でのペナルティが1次か2次か。この非対称性こそが、L1がスパースなモデルを生み、L2がそうならない理由のすべてです。