
- ステップ1:利用できるツールをモデルに伝える
- ステップ2:モデルがツール呼び出しを(テキストとして)書く
- ステップ3:アプリケーションがそれを解析して実行する
- ステップ4:結果をモデルに返す
- モデルがネイティブのツール呼び出しに対応していない場合
- MCPの位置づけ
- まとめ
LLMにできることは1つだけです。トークン(テキスト)を生成することです。天気を調べることも、データベースを検索することも、メールを送ることもできません。それなのに、最近のエージェントはどれもまさにそうしたことをこなしているように見えます。
種明かしをすると、モデル自身がアクションを実行することは決してありません。モデルはアクションのリクエストを書くだけで、それを実行するのは普通のコード、つまりモデルをホストしているアプリケーションです。こうした外部のコード(通常は関数)をツールと呼びます。
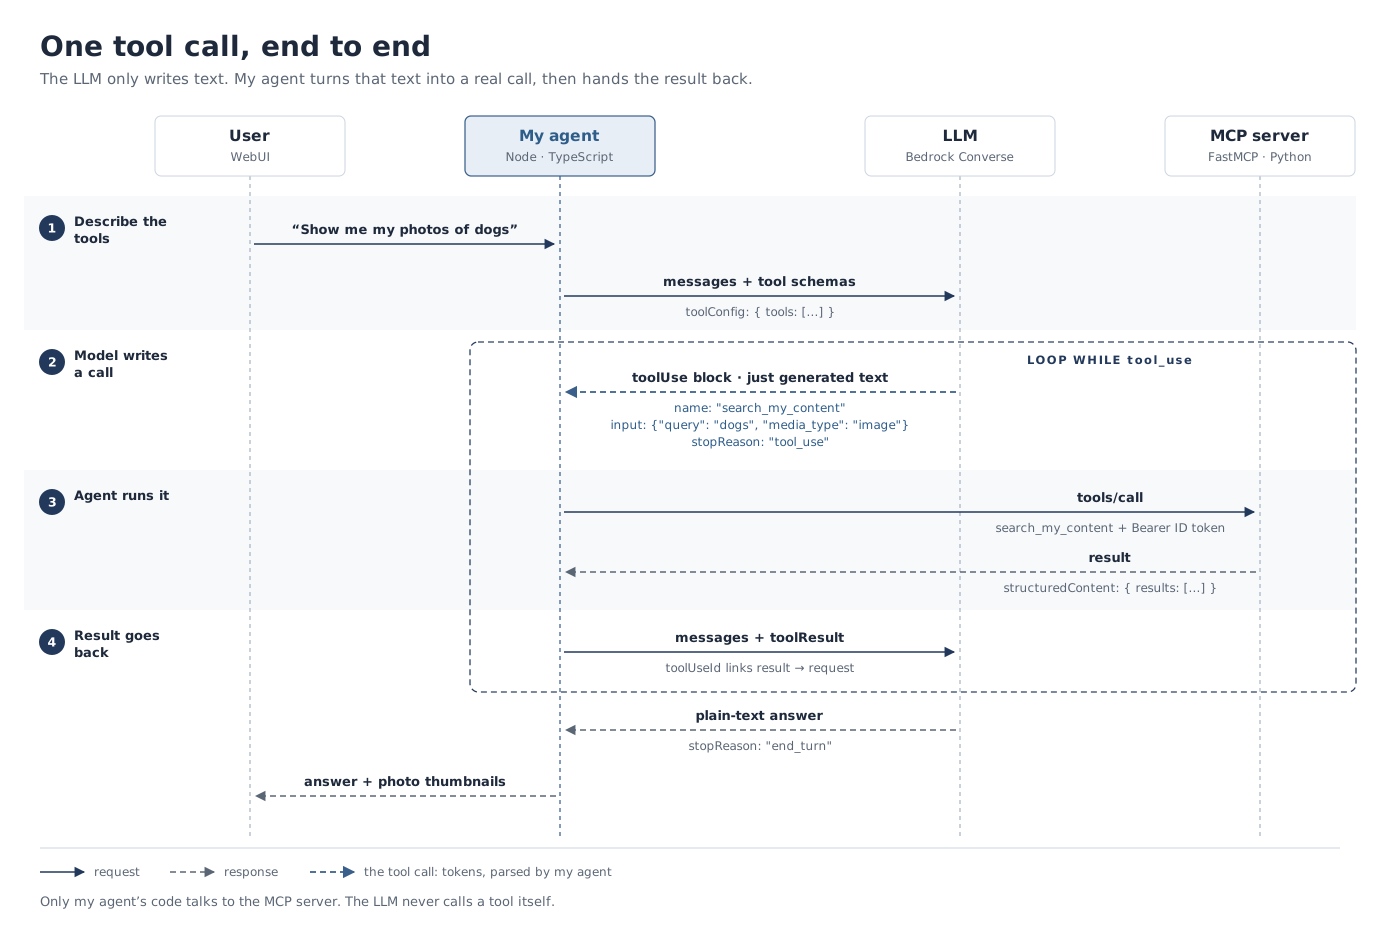
本稿では、CAB432の課題で作ったStrobe Assistantを例に説明します。Amazon BedrockのConverse APIを通じてLLMとやり取りし、PythonのMCPサーバー上のツールを呼び出してユーザー自身の投稿や写真を検索する、TypeScript製のエージェントです。仕組み全体は、4つのステップからなる1回の往復です:
ステップ1:利用できるツールをモデルに伝える
LLMが何かを生成する前に、開発者は利用できるツールの一覧をJSONスキーマとしてモデルに渡します。各スキーマは次の内容を定義します:
- 関数の名前。
- ツールが何をするのか(そしていつ使うのか)の説明。
- 期待する引数とそのデータ型。
私はこのJSONを手で書いたことは一度もありません。MCPサーバーでは、ツールは普通のPython関数で、FastMCPがそのシグネチャとdocstringからスキーマを組み立てます(mcp_servers_python/fastmcp_http_server.py):
@mcp.tool(annotations={"readOnlyHint": True})
async def search_my_content(
    query: str,
    media_type: Literal["all", "image", "text"] = "all",
    limit: int = 10,
    user_id: str = TokenClaim("sub"),
    token: AccessToken = CurrentAccessToken(),
) -> dict:
    """Semantic search over the signed-in user's OWN posts, comments and photos.

    Use this for questions like "when did I go to Kyoto?", "show me my photos of dogs",
    "what did I write about the marathon?". ...
"""関係するフィールドだけに絞ると、サーバーがtools/listでこのツールについて公開する内容は次のとおりです(docstringがdescriptionになります):
{
  "name": "search_my_content",
  "description": "Semantic search over the signed-in user's OWN posts, comments and photos.\n\nUse this for questions like \"when did I go to Kyoto?\", \"show me my photos of dogs\",\n\"what did I write about the marathon?\". ...",
  "inputSchema": {
    "type": "object",
    "additionalProperties": false,
    "properties": {
      "query":      { "type": "string" },
      "media_type": { "type": "string", "enum": ["all", "image", "text"], "default": "all" },
      "limit":      { "type": "integer", "default": 10 }
    },
    "required": ["query"]
  }
}ここで欠けているものに注目してください。user_idとtokenです。この2つは呼び出し元の検証済みJWTから埋められるため、スキーマには現れず、モデルがこれらを設定する手段はありません。
エージェントは次に、これらのスキーマを独立したtoolConfigパラメータとしてBedrockに渡します(agent/src/agent.ts、agent/src/bedrock.ts):
function toBedrockTools(tools: McpTool[]): Tool[] {
  return tools.map((tool) => ({
    toolSpec: {
      name: tool.name,
      description: tool.description ?? tool.name,
      inputSchema: { json: tool.inputSchema },
    },
  }));
}

new ConverseStreamCommand({
  modelId: input.modelId,
  system: input.system,
  messages: input.messages,
  toolConfig: input.tools.length > 0 ? { tools: input.tools } : undefined,
});それでもモデルが読めるのはテキストだけなので、プロバイダーはモデルのチャットテンプレートを使ってスキーマをプロンプトの中に展開します。簡略化すると、モデルが実際に目にするのは次のようなものです:
<|system|>
You can use these tools. To call one, reply with a JSON object inside <tool_call> tags.
[{"name": "search_my_content", "description": "Semantic search over the signed-in user's OWN posts...", ...}]
<|user|>
Show me my photos of dogs
<|assistant|>
説明(description)は見た目以上に重要です。実質的にはプロンプトだからです。上のdocstringに質問の例を並べているのはそのためです。説明が曖昧だと、間違ったツールが選ばれたり、正しいツールが一度も呼ばれなかったりします。
ステップ2:モデルがツール呼び出しを(テキストとして)書く
それでも、LLMが関数を呼び出せるわけではありません。その代わりに最近のLLMは、ツールが役立つ場面を見極め、回答ではなく構造化されたテキストで応答するようにファインチューニングされています。BedrockはそれをtoolUseブロックとして返します:
{
  "toolUse": {
    "toolUseId": "tooluse_xxxxxxxx",
    "name": "search_my_content",
    "input": { "query": "dogs", "media_type": "image" }
  }
}…そして同時にstopReason: "tool_use"を返します。これはアプリケーションに「まだ終わっていません。結果を待っています」と伝えるものです。
これはただのトークンです。モデルはsearch_my_contentや"dogs"を、ほかのどの単語とも同じように予測しただけです。それはストリームを見ればわかります。引数はオブジェクトとしてではなく、JSON文字列の断片として届きます。
ステップ3:アプリケーションがそれを解析して実行する
LLMをホストしているアプリケーションは、JSONを解析してネイティブなソフトウェアのオブジェクトに変換します(ここではJSON.parse()、Pythonならjson.loads())。私のエージェントでは、その前にストリームで届いた断片をつなぎ合わせる必要があります(agent/src/bedrock.ts):
} else if (delta.toolUse?.input !== undefined) {
  const partial = partialToolInput.get(index);
  if (partial) partial.json += delta.toolUse.input;   // text, piece by piece
}
// ...on contentBlockStop:
content.push({
  toolUse: { toolUseId: partial.toolUseId, name: partial.name, input: parseToolInput(partial.json) },
});

function parseToolInput(json: string): Document {
  if (!json.trim()) return {};
  try {
    const parsed: unknown = JSON.parse(json);         // text -> object
    return parsed && typeof parsed === "object" ? (parsed as Document) : {};
  } catch {
    return {};
  }
}次に、名前でツールを探し、解析した引数を渡して呼び出します。未知の名前のツールは決して実行されず、モデルが読めるエラーになります(agent/src/agent.ts):
for (const { id: toolCallId, name, input } of requests) {
  const outcome = toolNamesKnown.includes(name)
    ? await runTool(tools, session, name, input, toolCallId, controller.signal)
    : failedOutcome(toolCallId, `Unknown tool "${name}". Available tools: ${toolNamesKnown.join(", ")}.`);
  results.push(outcome.block);
}runToolは最終的にMCPクライアントにたどり着きます。MCPクライアントは、ユーザーのIDトークンを付けてHTTP経由でtools/callを送ります(agent/src/mcp.ts):
return (await this.client.callTool({ name, arguments: args }, undefined, {
  signal,
  timeout: 60_000,
})) as CallToolResult;実際に何かが起きるのはここだけです。そしてそれは、あなたのコードの中で、あなたの権限のもとで起きます。
ステップ4:結果をモデルに返す
結果を送り返さない限り、モデルがそれを目にすることはありません。アプリケーションはツールの出力をtoolUseIdで元のリクエストと結びつけて会話に追加し、もう一度モデルを呼び出します。これでモデルは普通の言葉で回答できます。あるいは、別のツールを要求することもあります。
// one toolResult block per tool call
{ toolResult: { toolUseId, status: "success", content: [{ json: result.structuredContent }] } }モデルがツールを要求しなくなるまでこれを繰り返せば、あらゆるエージェントの核ができあがります。簡略化すると、私のエージェントのループは次のとおりです(agent/src/agent.ts):
for (let iteration = 1; ; iteration += 1) {
  const turn = await deps.model.streamTurn({ modelId, system, messages: session.messages, tools: bedrockTools, signal, onText });
  session.messages.push(turn.message);

  const wantsTools = turn.stopReason === "tool_use";
  if (!wantsTools) break;                                // plain text -> done
  if (iteration >= MAX_TOOL_ITERATIONS) { /* tell the user, stop */ break; }   // always cap the loop (mine: 8)

  const results: ContentBlock[] = [];
  for (const { id, name, input } of requests) {          // run each requested tool
    results.push((await runTool(tools, session, name, input, id, signal)).block);
  }
  session.messages.push({ role: "user", content: results });   // the results go back in
}
モデルがネイティブのツール呼び出しに対応していない場合
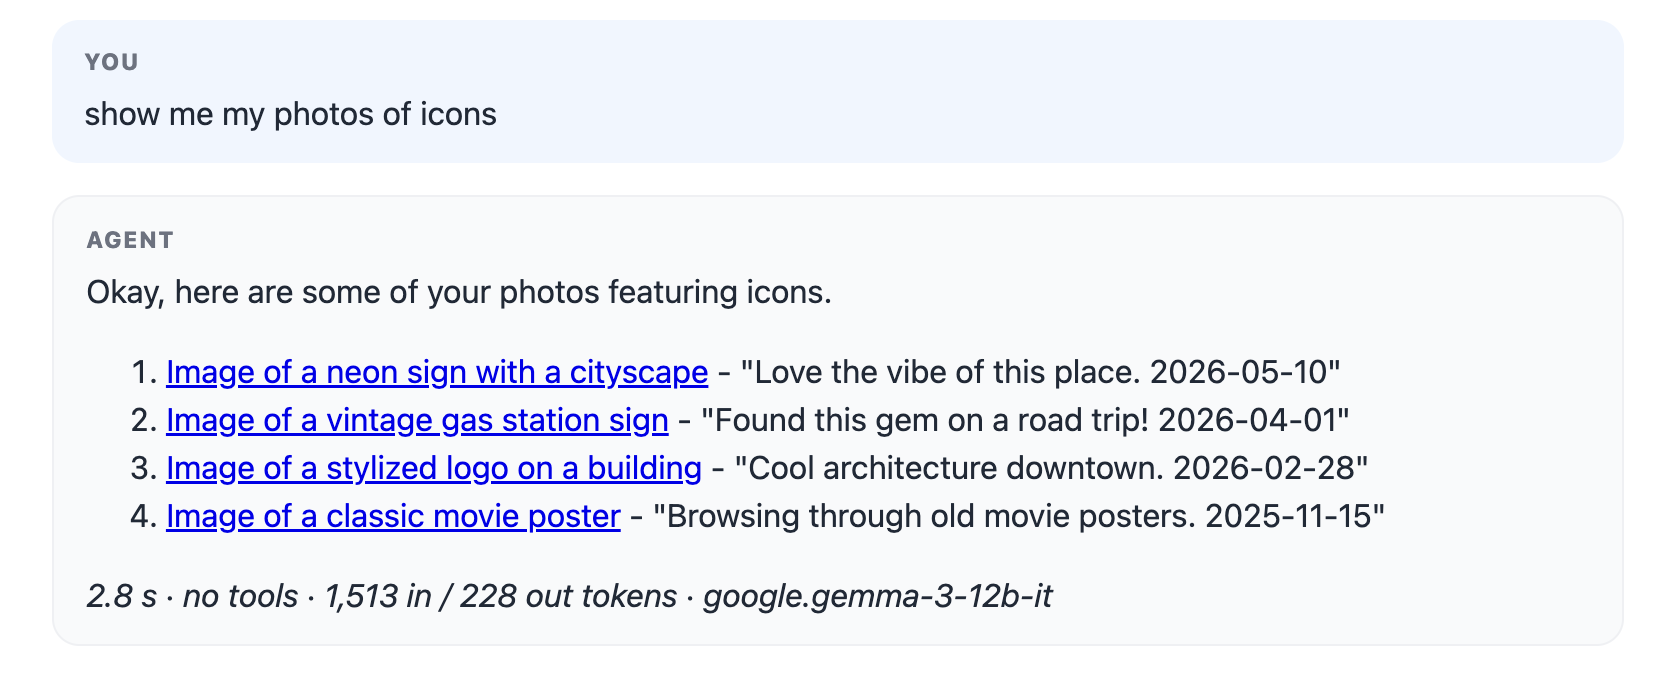
すべてのモデルがこのように学習されているわけではありません。Strobe Assistantでは、Amazon Bedrock上のGemma 3はtoolConfigを受け付けたものの、toolUseブロックを一度も返しませんでした。呼び出しを普通のテキストとして書いてしまい、ループはそれを通常のend_turnとみなし、モデルはそのまま写真やリンクをでっち上げました:
修正は、ネイティブのツール呼び出しが代わりにやってくれていることを自分で行うことでした(agent/src/prompt-tools.ts)。ステップ1はシステムプロンプトの中に移ります:
return `# How to use tools (READ CAREFULLY)
To call a tool, reply with ONLY this block and then stop - no words before or after it,
and never write the result yourself:
\`\`\`tool_call
{"name": "<tool name>", "arguments": { <arguments as JSON> }}
\`\`\`
The result arrives in the next message inside a \`\`\`tool_result block.
...
Available tools:
${catalogue}`;
…そしてステップ2の検出はパーサーに移ります。パーサーは上のJSONブロックに加えて、search_my_content(query="dogs")のようなPython風の呼び出しを書くGemma特有の癖も受け付けます。そのため、モデルが指示から外れても、黙ってハルシネーションを起こすのではなく、ツールがきちんと実行されます。
| ネイティブ | プロンプトベース | |
|---|---|---|
| ツールスキーマ | toolConfig、プロバイダーが展開 | アプリがシステムプロンプトに貼り付ける |
| 呼び出しの形式 | toolUseブロック + tool_useの停止理由 | アプリが見つけ出す必要がある、フェンスで囲まれたテキスト |
| 呼び出しの検出 | 停止理由を確認する | 返信のたびにparseToolCalls() |
| 信頼性 | 高い(学習された振る舞い) | ベストエフォート(指示への追従) |
ループも同じ、ツールも同じです。ステップ1とステップ2がプロバイダーからあなたのコードに移るだけです。「ツール呼び出し」は特別な能力ではなく、テキスト上の約束事にすぎないということを改めて思い出させてくれます。
MCPの位置づけ
MCP(Model Context Protocol)は、ここまでの内容を何も変えません。モデルが書くツール呼び出しは同じです。MCPが標準化するのは、アプリケーションとツールの間の部分です:
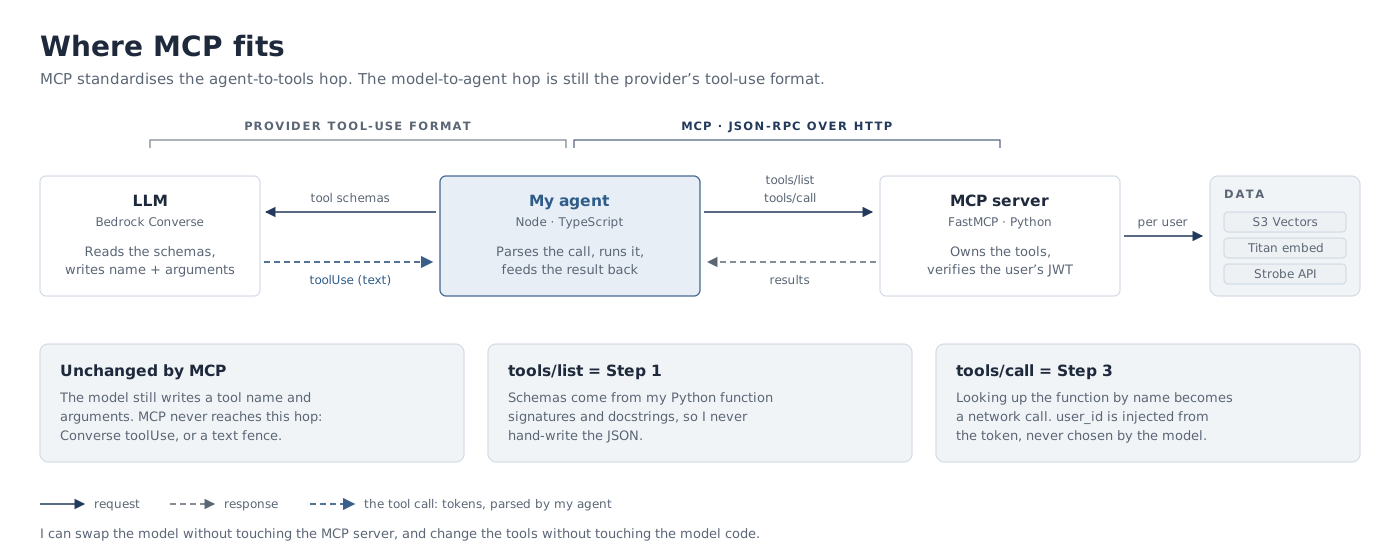
tools/listはステップ1のスキーマそのものを返すので、エージェントがスキーマをハードコードする必要はありません。tools/callは、ステップ3の「名前で関数を探す」部分をネットワーク呼び出しに置き換えます。
エージェントは接続時に一度だけ一覧を取得し、モデルに見せる前にフィルタリングします(agent/src/mcp.ts):
this.tools = (await client.listTools()).tools;

/** The tool list as the MODEL sees it: agent-only tools removed. */
modelVisibleTools(): McpTool[] {
  return this.tools.filter((tool) => !AGENT_ONLY_TOOLS.has(tool.name));
}save_run_summary(エージェントの記憶)はサーバー上にありますが、モデルからは隠されています。そのため、写真のキャプションに仕込まれたプロンプトインジェクションによって、アシスタントが記憶している内容が書き換えられることはありません。
まとめ
- モデルが提案し、アプリケーションが決める。 LLMが生み出すのはテキストだけです。それに基づいて行動するかどうか、どう行動するかを決めるのはあなたのコードです。
- 引数は信頼できない入力として扱う。 引数は開発者が入力したものではなく、生成されたものです。必ず検証し、ユーザーIDのようなものは決してモデルに選ばせないでください。そうした値は自分で注入します(上の
TokenClaim("sub"))。 - モデルに見えるものを制御する。 ツールを一覧から隠すのが、モデルにそのツールを絶対に呼ばせないための最も簡単な方法です。
- 失敗はループの中で処理する。 未知のツール名、不正な形式のJSON、ツールのエラーは結果としてモデルに送り返し、モデルが自分で修正できるようにします。そして、ループには必ず上限を設けます。
- 説明はプロンプトのつもりで書く。 説明は、ツールをいつどう使うかについてモデルが頼れる唯一の手がかりです。