
畳み込みニューラルネットワーク(CNN)は、画像の中から空間的なパターンを見つけるための標準的なアーキテクチャです。ところが、カーネル、フィルタ、チャネル、特徴マップといった周辺の用語は、かなりあいまいに使われがちです。この記事では、それぞれの用語が正確には何を意味するのか、そして畳み込み層が入力画像を実際にどう出力に変えるのかを、すべて手計算で確かめた数値例とともに見ていきます。シリーズのCNNの受容野:なぜ大きなカーネルより深さなのかでは、ここでの考え方をもとに受容野を説明します。小さなフィルタを積み重ねることで、大きなカーネルを一度も使わずに、CNNが画像の広い範囲を「見渡せる」のはなぜか、という話です。
カーネルとフィルタ
この2つの言葉はよく同じ意味で使われますが、指しているものは違います。
- カーネルは、学習される重みを並べた1枚の2次元グリッドです。形は
H×Wで、チャネルはちょうど1つです。 - フィルタは、1つの層で適用されるカーネル一式です(入力チャネルごとに1つのカーネル)。したがって、3チャネル(RGB)の入力に適用するフィルタは、チャネルごとに1つずつ、3つのカーネルでできています。
フィルタは、学習によって得られる1つのパターン検出器です。その役割は、ある特定のパターンが画像のどこに現れるかを見つけることです。実際の入力画像には、検出する価値のあるさまざまなパターン(いろいろな角度のエッジ、色のグラデーション、テクスチャ)が含まれているので、畳み込み層は多くのフィルタを並列に適用し、それぞれが別々のパターンを専門に担当します。
畳み込みの仕組み
フィルタは入力の空間方向にスライドしていき、各位置で、読み取る入力チャネルがいくつあっても、ちょうど1つの出力値を生成します。下の図は、3チャネル・6×6の入力に3×3×3のフィルタ(チャネルごとに3×3のカーネルが1つ)を適用し、1チャネル・4×4の出力を得る様子を示しています。
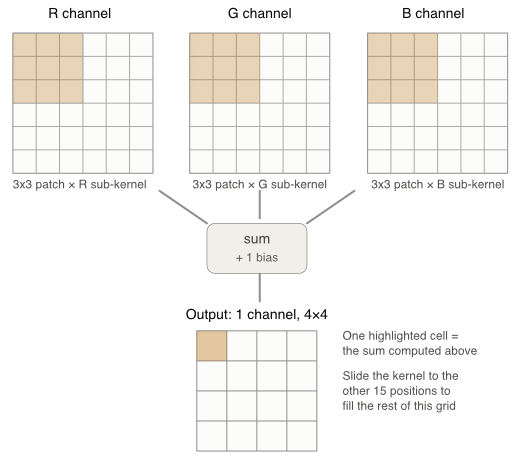
図ではチャネルを視覚的に分けていますが、計算上は分かれていません。そこで、いくつかの点をはっきりさせておきます。
- 畳み込みでは、各チャネルの
k×kのパッチを、そのチャネル専用のサブカーネルと要素ごとに掛け合わせ、得られた積を1つのチャネルの中だけでなく、すべてのチャネルにわたって合計します。3×3×3のフィルタなら、27個の積を合計して1つのスカラーにします。 - 合計した後、そのスカラーにバイアスを加えます。
- 1つのフィルタが持つバイアスはちょうど1つなので、そのフィルタの出力のすべてのマスに同じバイアスの値が加えられます。図では、4×4の出力の16か所すべてで同じバイアスが使われています。
- 入力チャネルの数は、層に何を入力するかで決まります(RGBなら3、グレースケールなら1、あるいは前の層が出力したチャネル数)。出力チャネルの数はハイパーパラメータです。各フィルタがちょうど1つの出力チャネルを生成するので、出力チャネル数は、適用すると決めたフィルタの数そのものです。
計算例
上の図は仕組みをつかむのには役立ちますが、正しさを確かめるには、手で検算できる小さな例のほうが簡単です。3×3×3の入力と、3×2×2のフィルタ1つ(チャネルごとに2×2のカーネルが1つ)を考えます。
3×3の入力の上を2×2のカーネルがスライドすると、有効な位置は4つなので、(バイアスを加える前の)出力は2×2のグリッドになります。各位置について、各チャネルの2×2のパッチをサブカーネルと要素ごとに掛け合わせ、3つのチャネルすべてにわたって合計していきます。
- sum_top_left = + + = 0.08
- sum_top_right = + + = 0.05
- sum_bottom_left = + + = 0
- sum_bottom_right = + + = 0.17
(は、2×2のパッチ全体で要素ごとに掛けて合計することを表します)したがって、
となり、このフィルタの1つのバイアスをすべてのマスに加えた最終的な出力はです。
特徴マップ
1つのフィルタを入力の有効な位置すべてにスライドさせた出力が、特徴マップです。上の例の2×2の値のグリッドや、図の4×4のグリッドがそれにあたります。各マスには、その位置でフィルタのパターンがどれだけ強く一致したかが記録されます。つまり特徴マップとは、基本的に「このパターンが画像のどこに現れるか」を示す空間的な地図です。
いくつか正確にしておきたい点があります。
N個のフィルタを持つ層はN枚の特徴マップを生成し、それらが積み重なって、次の層へのNチャネルの入力になります。層の出力チャネル数が常にフィルタの数と等しいのは、このためです。- 厳密には、特徴マップは畳み込みにバイアスを加えた生の出力で、非線形関数を適用する前のものです。ReLUのような非線形関数を要素ごとに適用した結果は、活性化マップと呼ばれることもあります。実際には、論文でもツールでもこの2つの用語はよく同じ意味で使われますが、区別するなら、特徴マップ =
conv(input) + bias、活性化マップ =activation(feature map)です。 - 初期の層の特徴マップは、単純で汎用的なパターン(エッジ、色のかたまり、角)に反応する傾向があります。各層のフィルタは生のピクセルではなく前の層の特徴マップに対して働くので、深い層の特徴マップほど、より複雑で複合的なパターン(テクスチャ、物体の一部、物体全体)に反応するようになります。ある領域で「これは目のように見える」ことを強く示す特徴マップが、ほかの特徴マップと組み合わさって、「これは顔のように見える」ことを示す根拠になるのです。
NLPの視点から見たCNN
言語モデルは、単語を埋め込みで表します。埋め込みは通常、各次元が単語の意味の何らかの側面をとらえた多次元ベクトルです。画像にも似た問題があります。1つのピクセルの輝度だけでは、それ単体で意味のあることはほとんどわからないので、ある位置にあるパターン(エッジ、色、テクスチャなど)を表すには複数の値が必要です。CNNはこれを同じやり方で解決しています。空間上のどの位置でも、層のすべてのチャネルにわたる値の並びが1本のベクトルになり、各チャネルが学習された1つのパターンを表します。フィルタと層を増やしていくと、そのベクトルはより複雑なパターンの組み合わせを表せるようになります。
| 特徴 | CNN | NLP |
|---|---|---|
| 最小単位 | 空間上の1つの位置 | 1つのトークン |
| ベクトル | その位置における、すべてのフィルタ/チャネルの値 | そのトークンの埋め込みの値 |
| 表しているもの | 視覚的なプロファイル(どのパターンがあるか) | 意味的なプロファイル(文脈の中でトークンが何を意味するか) |
| 文脈による変化 | 深い層が特徴を組み合わせて、複雑な物体を表す | 深い層が単語を組み合わせて、複雑な概念を表す |
いくつかの違い
このたとえは役に立ちますが、1つ重要な点で成り立たなくなります。単語の埋め込みは固定のルックアップテーブルから始まるのに対し、CNNの特徴ベクトルは引いてくるものではなく、計算されるものです。
単語の埋め込みテーブルは、語彙の項目ごとに固定の行が1つある巨大な行列です。「cat」は常に4592行目、「dog」は常に891行目、といった具合です。モデルが「cat」というトークンを見たときは、4592行目を取り出すだけです。ベクトルそのものを得るのに計算は要らず、計算が関わるのはその後の処理だけです。
CNNには、これに相当するテーブルがありません。空間上のあらゆる位置の特徴ベクトルは、入力の上でフィルタを動かすことでその場で計算されます。しかも、その計算が参照できるのは、小さな局所的な近傍、つまり受容野だけです。その近傍が広がるのは、畳み込み層を積み重ねたときだけで、層を重ねるごとに少しずつ広がっていきます(この広がりについてはCNNの受容野:なぜ大きなカーネルより深さなのかで取り上げています)。ネットワークが直接引いてこられる「ピクセルパターン4592番」のようなものはなく、どの画像も、その中のどの位置も、同じ共有のフィルタを通して、そのつど新たに解釈しなければなりません。
参考資料
- CNN Explainer — CNN全体をインタラクティブに可視化したもので、フィルタと特徴マップがどう組み合わさるのかをつかむのに役立ちます。
- Understanding Convolutional Neural Networks (CNN) — LearnOpenCV