
このシリーズの第1部CNNの基礎:カーネル、畳み込み、特徴マップでは、1つの畳み込み層が入力をどう特徴マップに変えるのかを扱い、CNNのある位置の特徴ベクトルが参照できるのは、画像全体ではなく小さな局所的な近傍、つまり受容野だけだと述べました。この記事は、その近傍についての話です。受容野はどう定義されるのか、ネットワークが深くなるにつれてどう広がるのか、そしてその広がりこそが、CNNのアーキテクチャが少数の大きなフィルタよりも多数の小さなフィルタを好む本当の理由であることを見ていきます。
受容野とは何か
あるニューロン(言い換えれば、特徴マップ上のある空間位置)の受容野とは、そのニューロンの値に影響を与えうる、元の入力画像の領域のことです。
これは畳み込みの仕組みからそのまま導かれます。1つの3×3のフィルタは、与えられたものの3×3のパッチしか読みません。したがって、ネットワークの最初の畳み込み層のニューロンは、定義上、入力画像に対して3×3の受容野を持ちます。そのパッチの外にあるものを「見る」手段がまったくないのです。
受容野は深さとともに広がる
個々の層のカーネルは小さいままでも、層を積み重ねると受容野は広がります。2番目の畳み込み層のニューロンを考えてみましょう。このニューロンが見ているのは、1番目の層が出力した特徴マップの3×3のパッチです。ところが、そのパッチの9つの位置はそれぞれ、元の画像の3×3のパッチから計算されたものです。その9つの元のパッチは重なり合い、全体として3×3より広い範囲にわたります。そのため、2番目の層のニューロンは、自分のカーネルの大きさから想像されるよりも広い、元の入力の領域に間接的に依存しているのです。
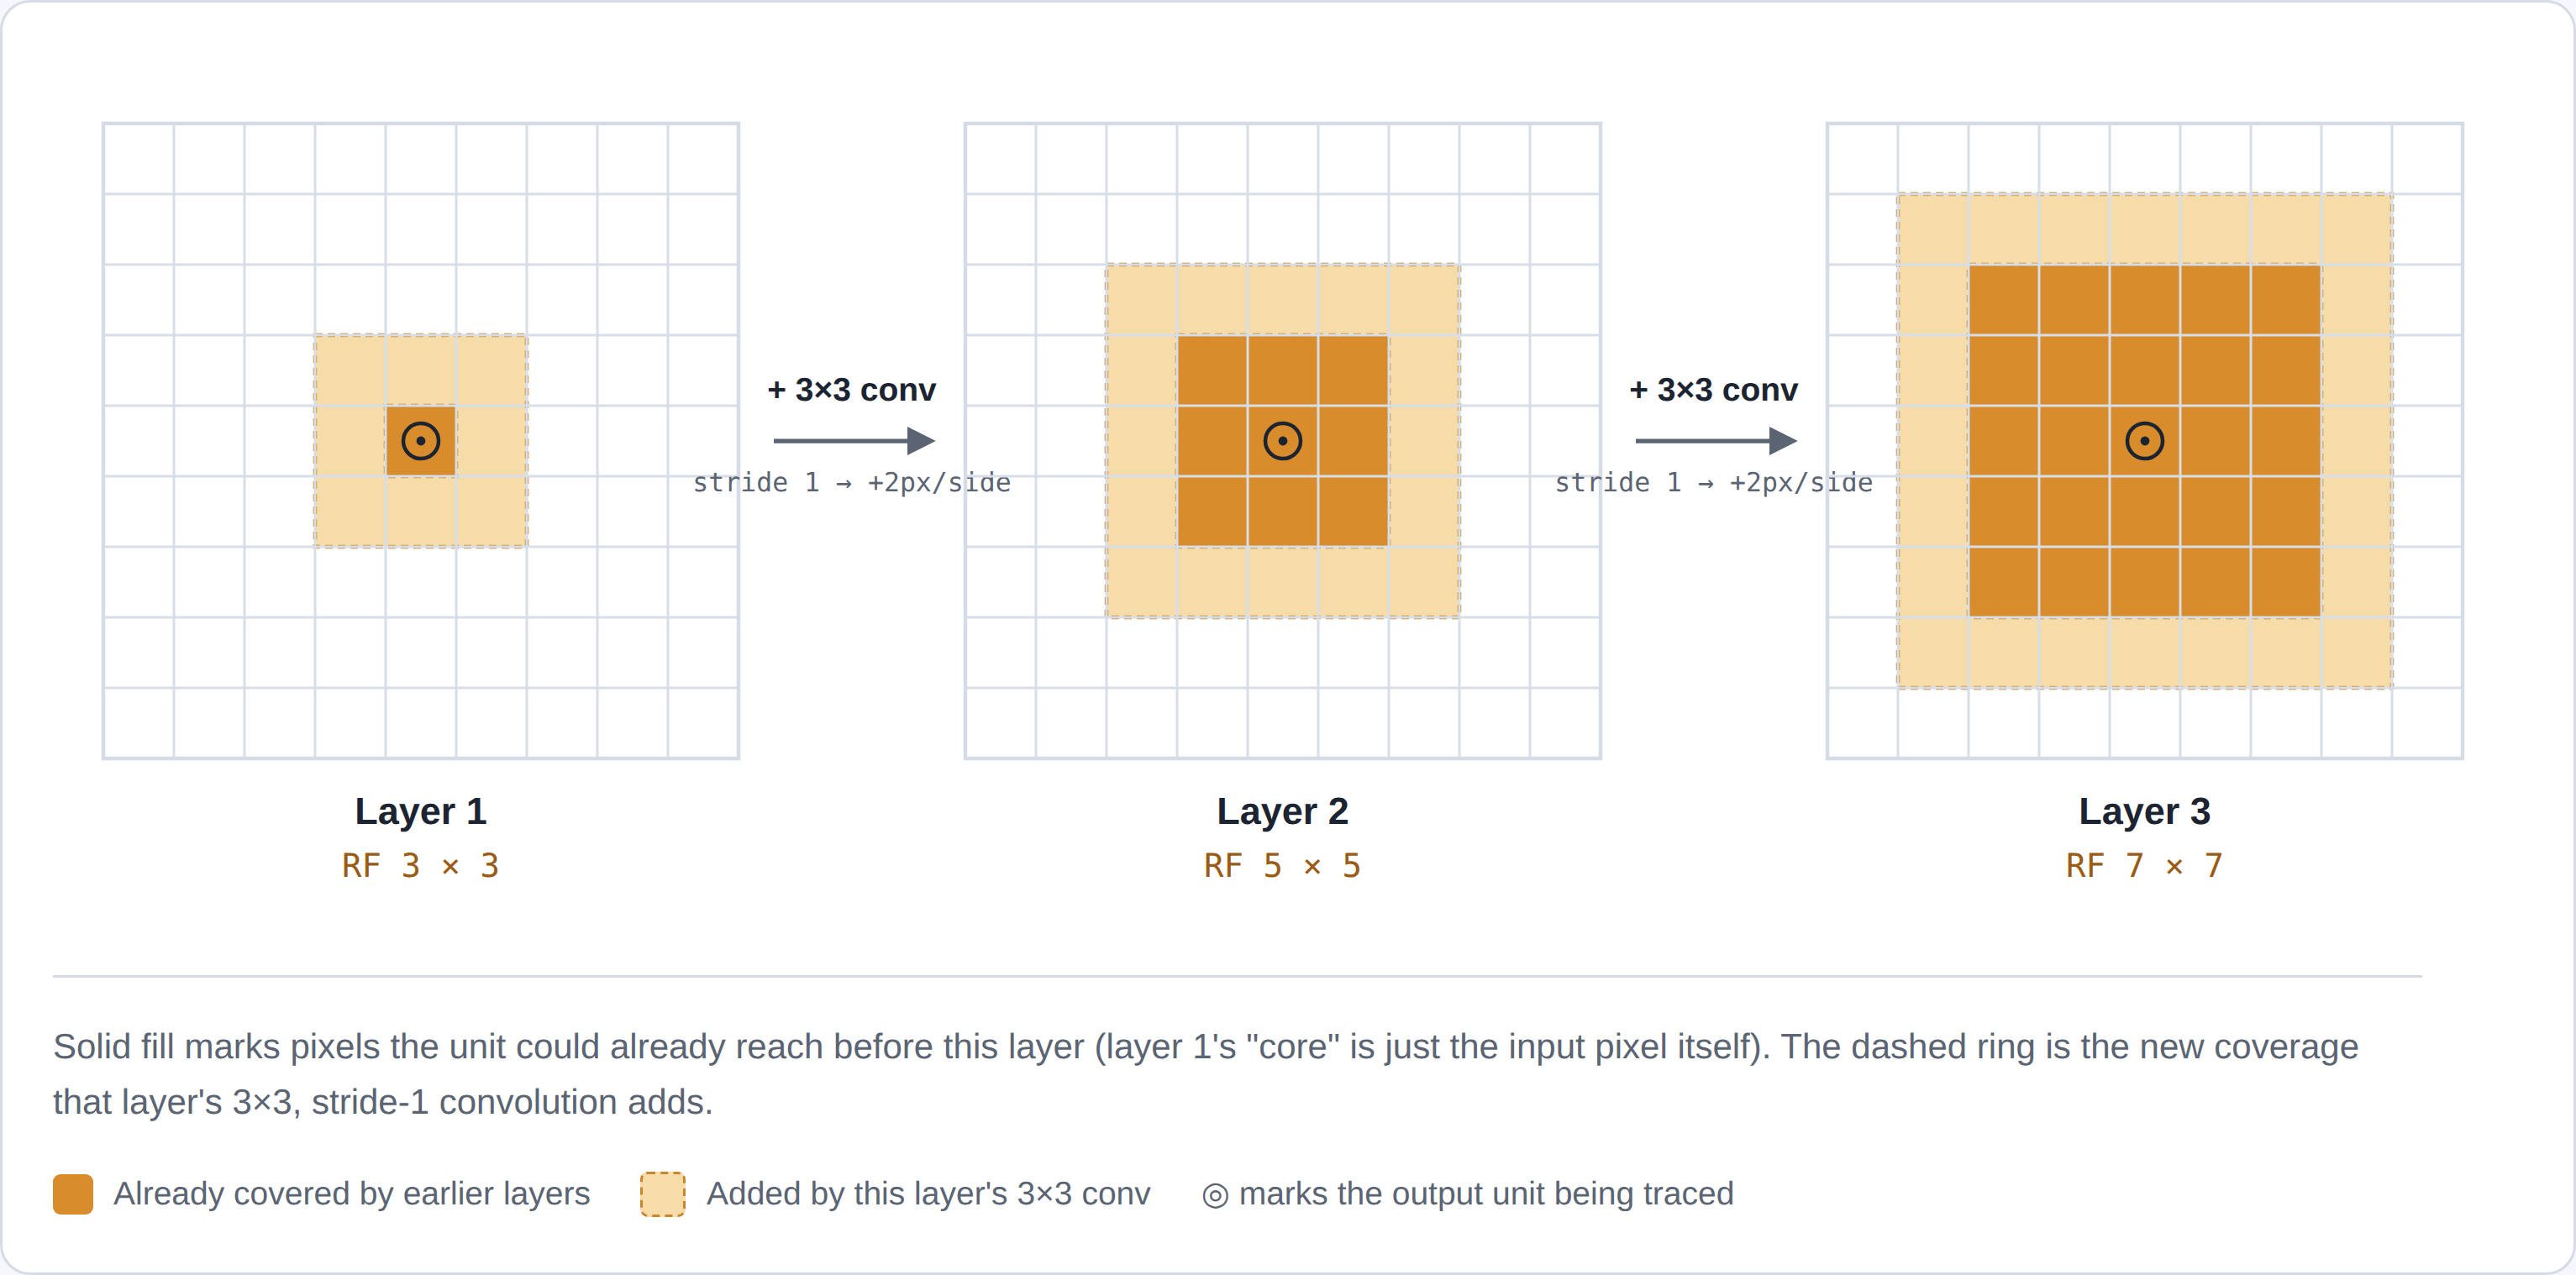
ストライド1のk×kカーネルを積み重ねる場合、これは単純な漸化式に一般化できます。各層は受容野にk − 1ピクセルを加えます。
3×3のカーネルなら1層あたり+2ピクセルで、第1層 → 3×3、第2層 → 5×5、第3層 → 7×7と続きます。まさに図のとおりです。深いCNNが、全体を通して小さな3×3のフィルタだけで大規模な構造(顔全体や車)を認識できるのはこのためです。物理的に大きなカーネルを必要とせずに、深さが実質的な視野を積み上げていくのです。
ストライドとプーリングへの一般化
上の式は、すべての層がストライド1であることを前提にしていますが、いつもそうとは限りません。特にプーリング層は、通常ストライド2です。一般的な形では、受容野に加えて2つ目の量を追跡します。ジャンプ(ストライド積と呼ばれることもあります。用語はAraujoらによるこのテーマの解説から借りています)で、隣り合う2つの出力位置が、入力上で何ピクセル離れているかを表します。
ここでjump_0 = 1です(生の入力で隣り合うピクセルは、当然ながら1ピクセル離れています)。すべての層がストライド1ならjumpは1のままで、この式は上の単純な式に戻ります。しかしストライド2の層、たとえば2×2のマックスプーリングはジャンプを2倍にします。つまり、それ以降のすべての層は、カーネルの大きさあたり2倍の速さで受容野を広げることになります。具体的には、3×3・ストライド1の畳み込み(RF 3、jump 1)、続いて2×2・ストライド2のマックスプーリング(RF 3 + (2−1)×1 = 4、jump 2)、さらに3×3・ストライド1の畳み込み(RF 4 + (3−1)×2 = 8、jump 2)と重ねると、3層で8×8の受容野に届きます。プーリングは受容野を手早く広げる安上がりな方法で、畳み込みブロックの間によく登場する理由の1つがこれです。
1つの大きなカーネルより深さが勝る理由
CNNのアーキテクチャが、同じ範囲を巨大なカーネル1層で直接カバーするのではなく、小さなフィルタで深くしていく理由の1つが、受容野の大きさです。どちらも7×7の受容野を生む、7×7のカーネル1つと、3×3の層を3つ重ねたものを比べてみます。
- 7×7のカーネルには、入力チャネルあたり
7×7 = 49個の重みがあります。 - 3×3の層を3つ重ねると、チャネルあたり合計
3×(3×3) = 27個の重みで、ほぼ半分です。
同じ理由で、積み重ねたほうはFLOPsでも安く済みます。さらに、7×7のカーネルなら非線形関数(ReLUなど)は1回しか適用されないのに対し、3つの畳み込みの間に非線形関数が2つ多く入ります。非線形関数があるたびに、ネットワークは入力の単一の線形射影ではなく、より複雑で非線形な関数を学習できるようになります。つまり、積み重ねた層は、より少ないパラメータで、しかもより豊かな表現力をもって同じ受容野に届くのです。これはまさにSimonyanとZissermanがVGGNetの設計について示した論拠です(AlexNetのような初期のアーキテクチャが使っていた11×11や7×7の大きなカーネルではなく、小さな3×3の畳み込みを積み重ねる)。それ以来、これはCNNの設計における標準的な前提になっています。
実効受容野
ここまでの式が表しているのは、理論上の受容野です。つまり、あるニューロンの出力に原理的に影響を与えうる入力の領域全体です。実際には、その領域のすべてのピクセルが同じだけ重要なわけではありません。
Luoら(2016)は、理論上の受容野の中のピクセルに対するニューロンの実際の感度が一様ではなく、中心付近に集中し、端に向かっておおよそガウス分布のように下がっていくことを示しました。中心付近のピクセルは、端付近のピクセルよりもはるかに多くの中間計算の経路上にあります(各層で重なり合う多くのパッチを通って到達できます)。一方、端付近のピクセルには、位置をたどる細い1本の経路でしか到達できません。実際上の帰結として、出力に意味のある影響を与える領域、つまり実効受容野は理論上の受容野より小さく、ネットワークの深さに比例するのではなく、深さの平方根に比例して広がります。これで上の計算が無効になるわけではありません(理論上の受容野は、影響を与えうる範囲の厳密な上限であることに変わりはありません)。ただ、アーキテクチャがしばしばdilated convolutionやattentionといった手法を使って、理論上だけでなく実効的な視野を広げようとするのは、このためです。
まとめ
個々のフィルタは小さな局所的なパッチしか見ないにもかかわらずCNNが機能するのは、受容野のおかげです。層を積み重ねると、ニューロンが入力を実質的に見渡す範囲が広がります。それはパラメータの面では幾何級数的に安く、非線形性の面では幾何級数的に豊かで、しかも実効受容野の結果が示すように、最も重要な中心付近に集中したままです。1つの畳み込み層がどう出力を計算するかを説明したCNNの基礎:カーネル、畳み込み、特徴マップと合わせれば、CNNのアーキテクチャ図を読み、なぜそういう形になっているのかを理解するのに必要な直感は、ほぼそろいます。
参考資料
- Luo, W., Li, Y., Urtasun, R., & Zemel, R. (2016). Understanding the Effective Receptive Field in Deep Convolutional Neural Networks. Advances in Neural Information Processing Systems (NeurIPS) 29.
- Simonyan, K., & Zisserman, A. (2014). Very Deep Convolutional Networks for Large-Scale Image Recognition. arXiv:1409.1556.
- Araujo, A., Norris, W., & Sim, J. (2019). Computing Receptive Fields of Convolutional Neural Networks. Distill.