
背景
Strobeは、Instagramに似た写真共有型のソーシャルアプリです。ユーザーは家族や友人と写真を共有したり、短時間で消える「モーメント」を投稿したり、他のユーザーをフォローしたり、投稿に「いいね」やコメントをしたりできます。このアプリのバックエンドをAWSへ移行することが、QUTの情報技術修士課程(Master of IT)のクラウドコンピューティング科目(CAB432)における最初の課題でした。
課題には、あらゆる判断を左右する制約が課されていました。Reactのフロントエンドは変更できないため、APIの契約はまったく同じに保つ必要がありました。作業は授業用の共有AWSアカウント上で行い、使えるサービスは決められており、IAM実行ロールもあらかじめ権限範囲が定められていて変更できませんでした。さらに、デプロイしたAPIは自動採点システムによって10件のユーザーストーリーに沿ってテストされました。
概要: APIルート27本 · Lambda関数6つ · DynamoDBテーブル6つ · APIの契約変更0件 · ユーザーストーリー10件すべて合格
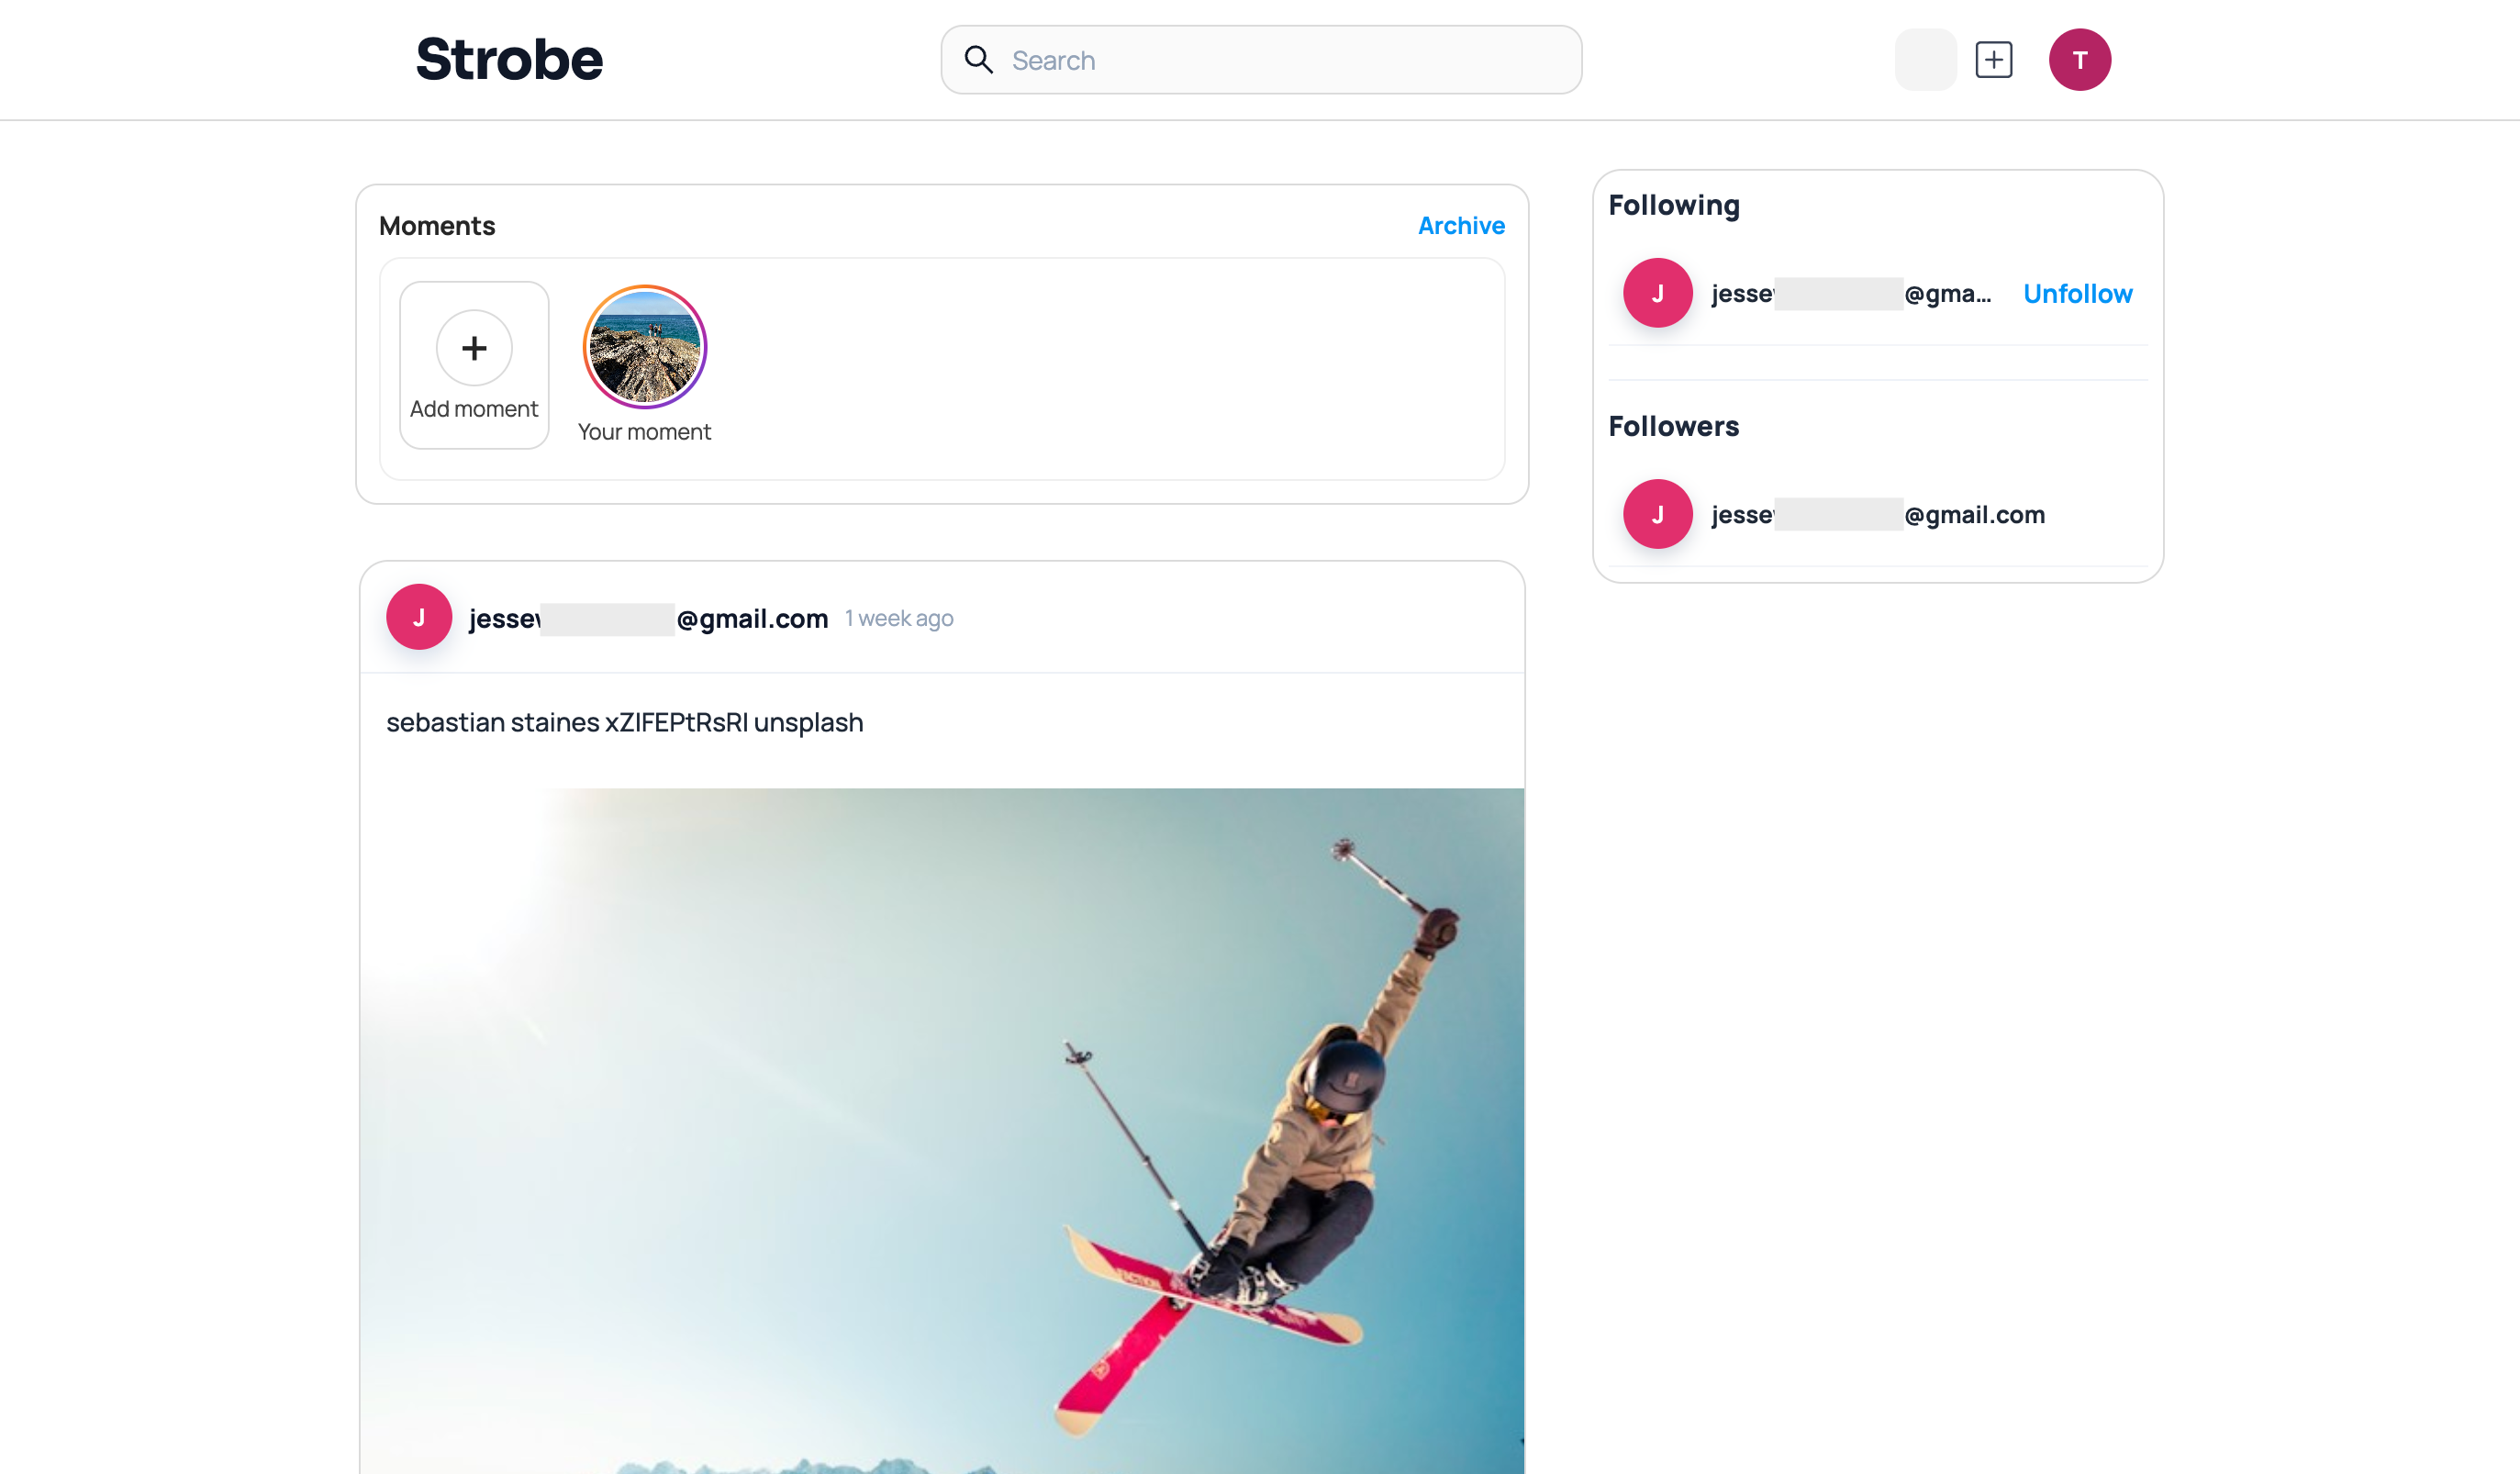
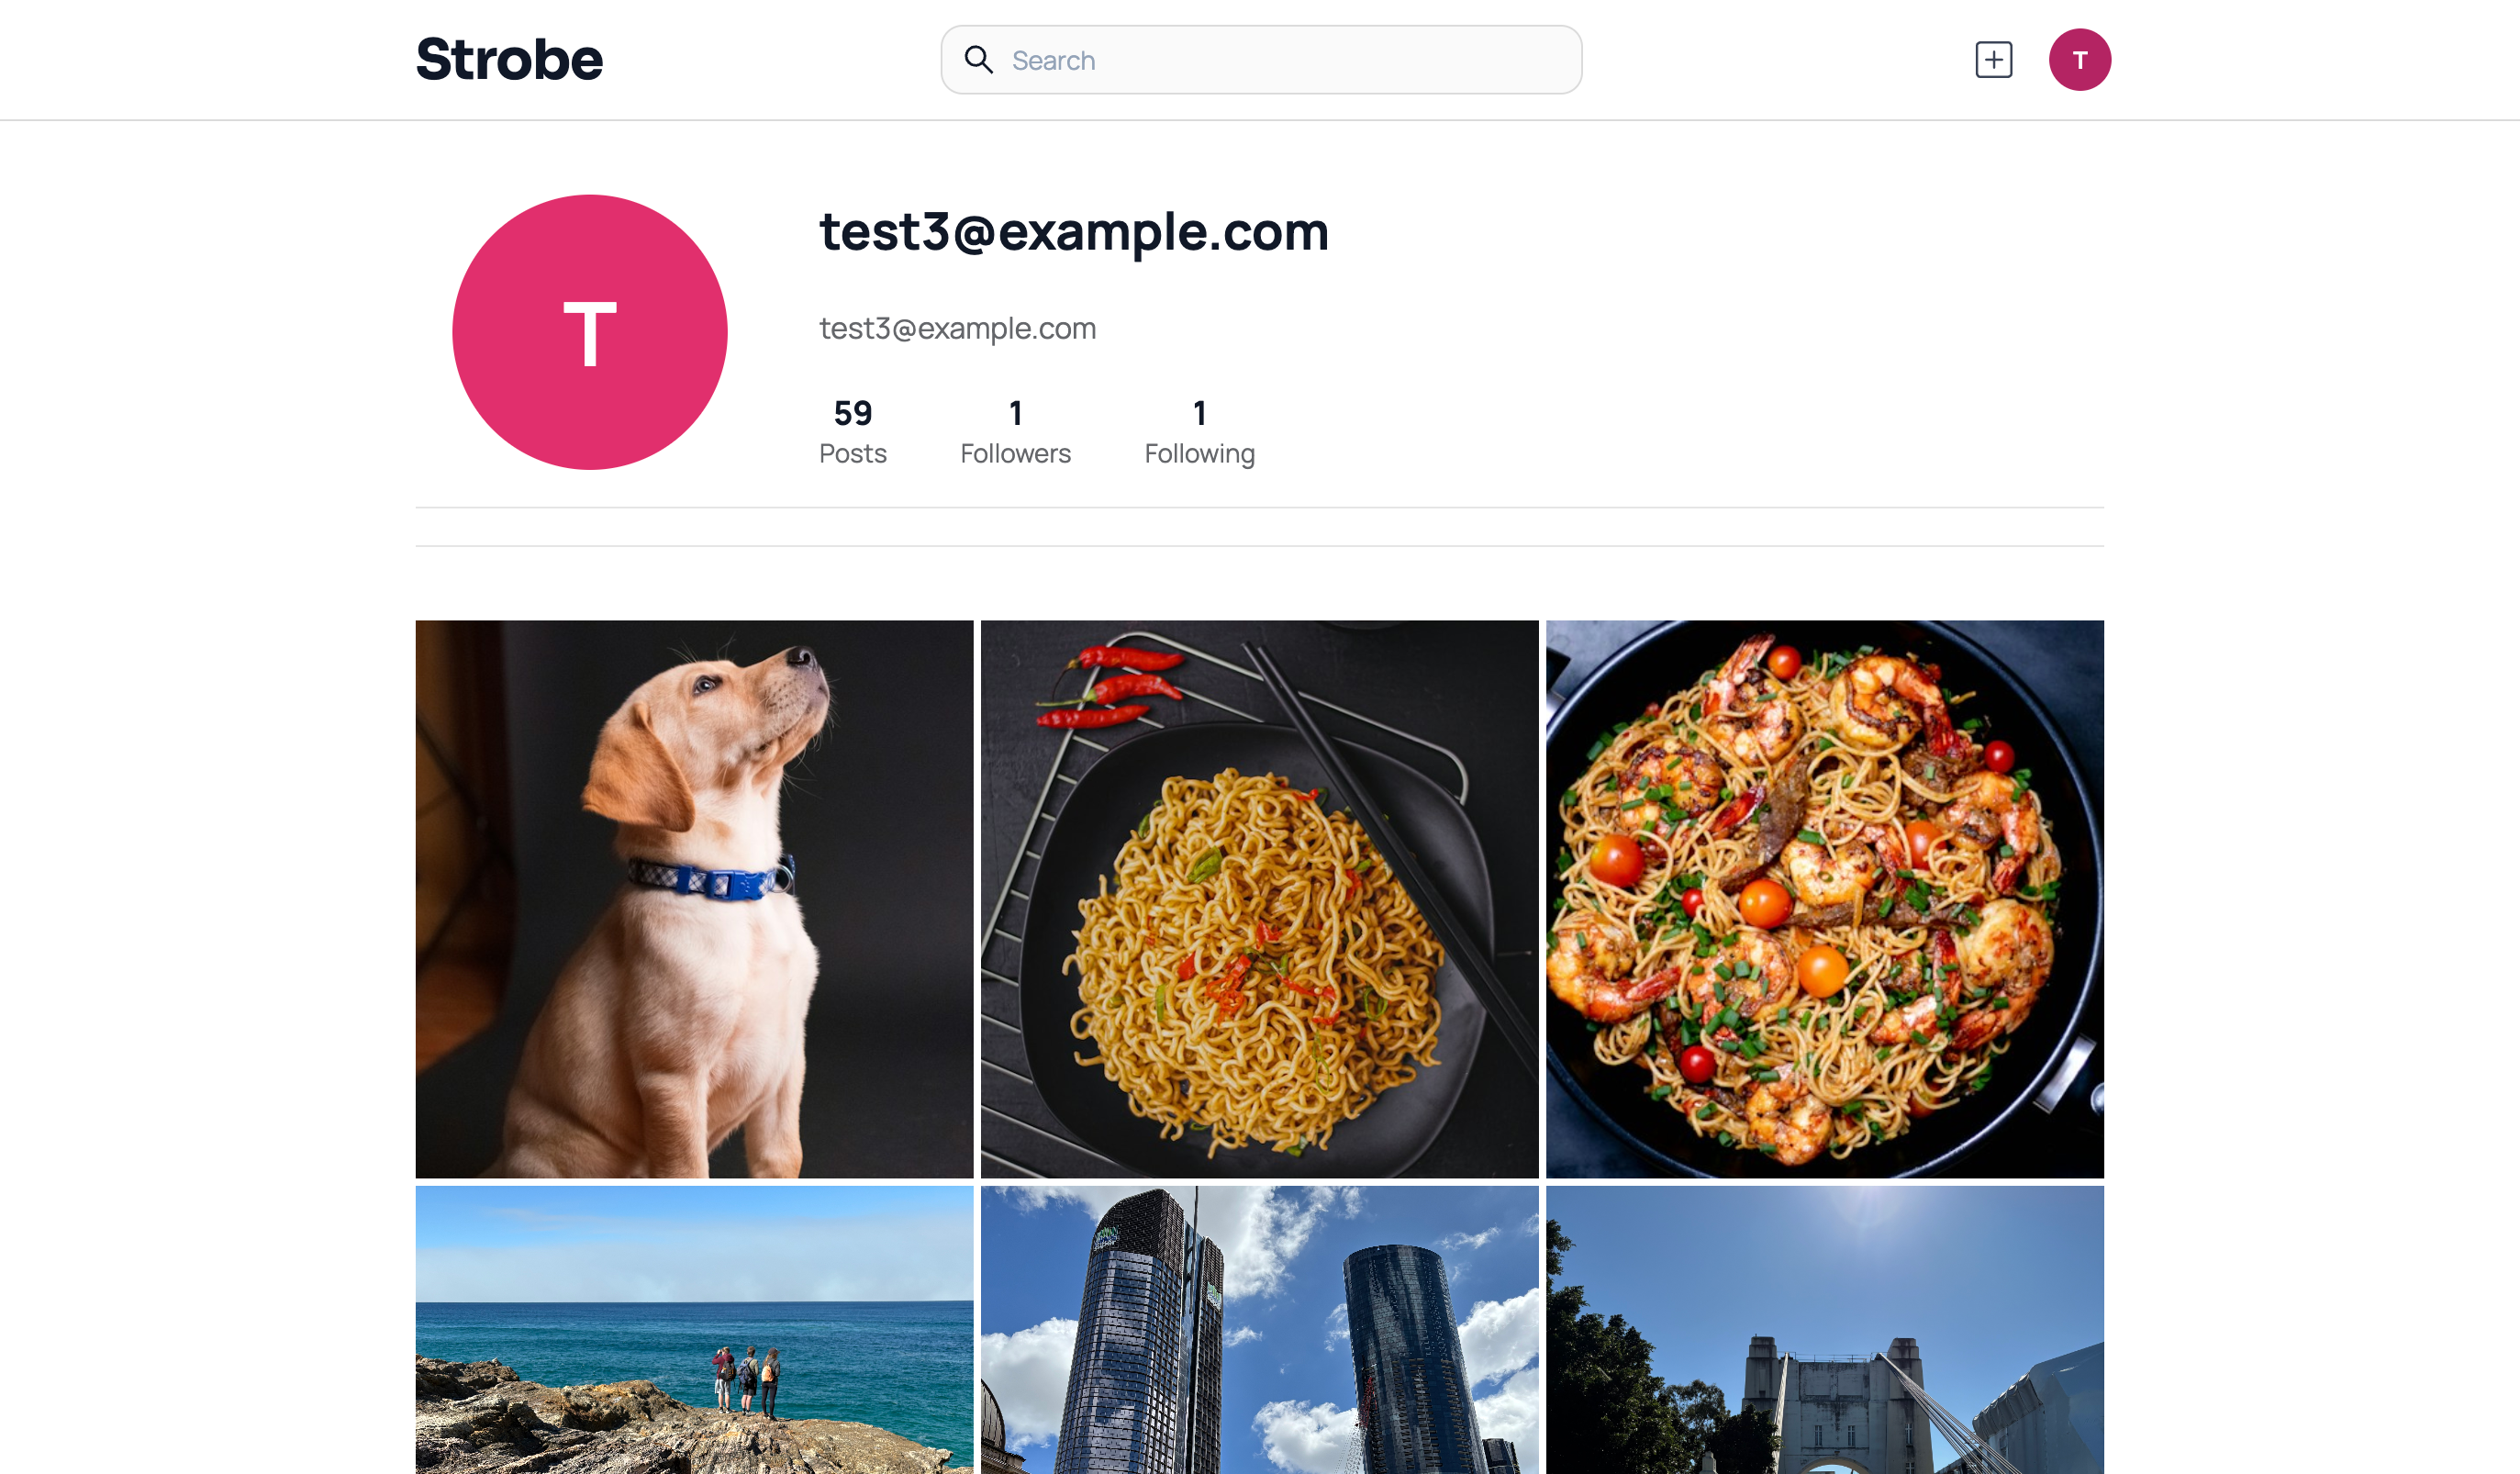
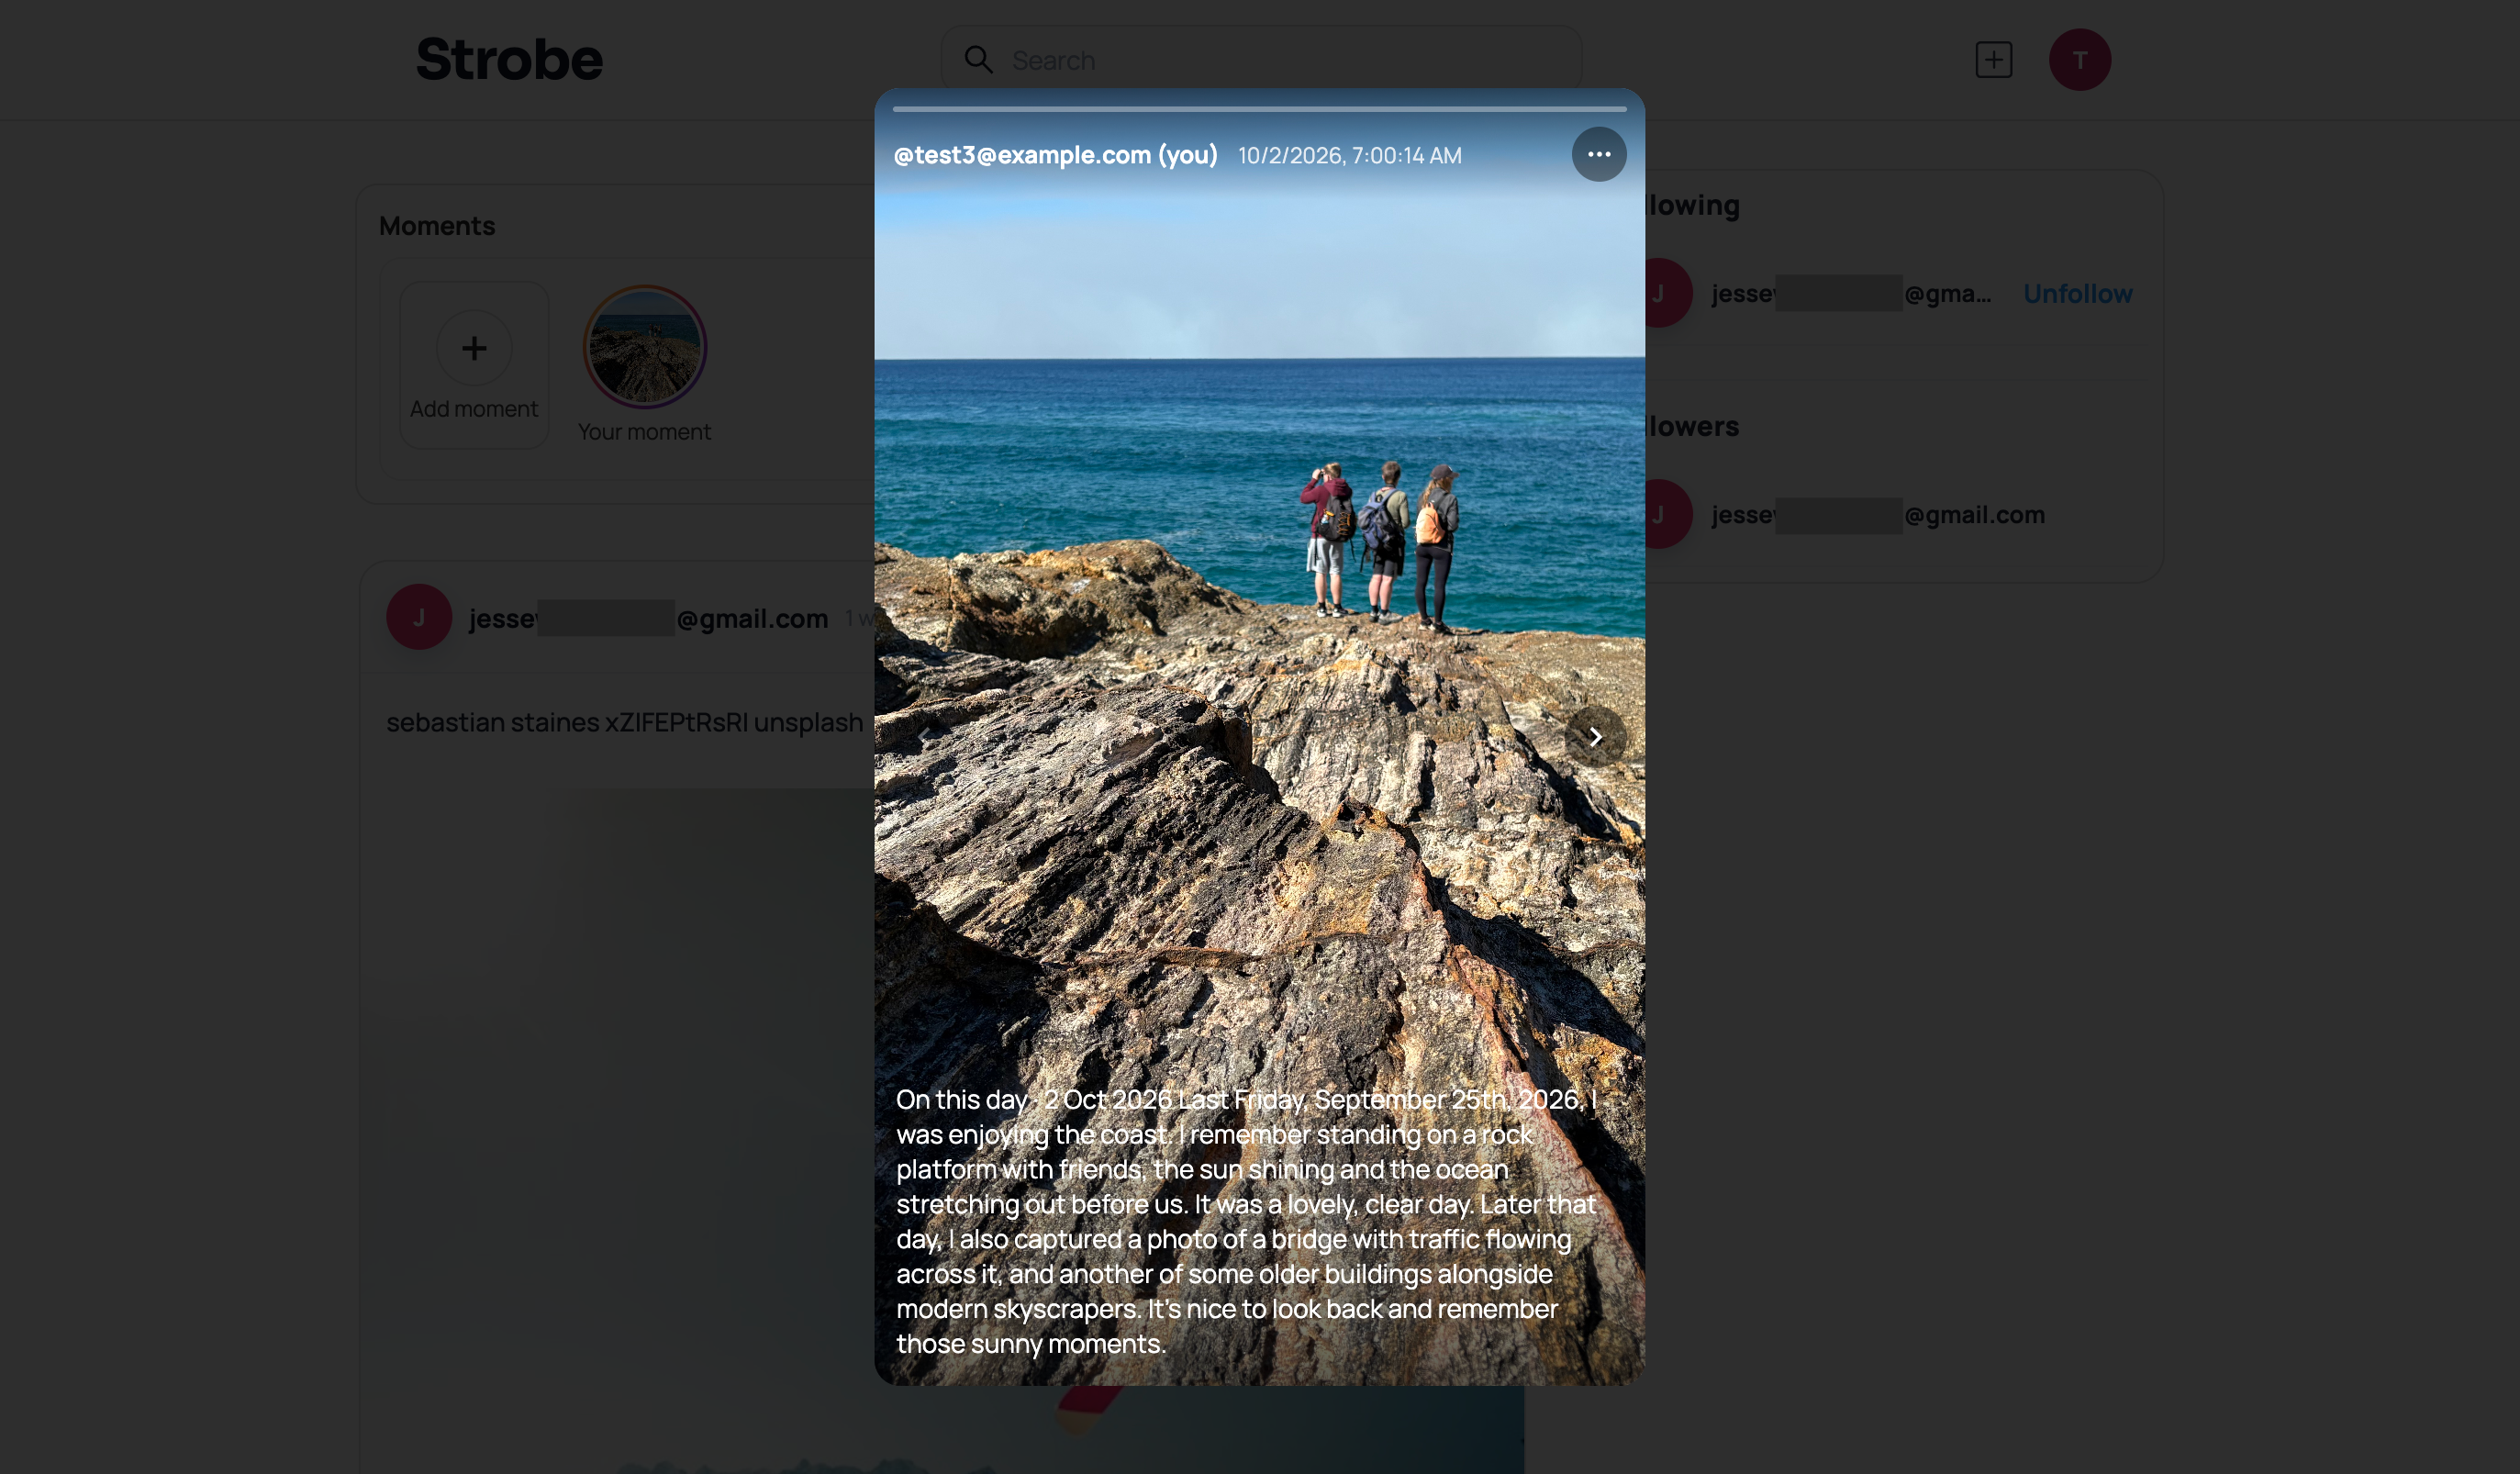
モノリス
アプリにはこれらの機能がすべて実装済みでしたが、バックエンドは1台のマシン上でUvicornによって動く単一のFastAPIモノリスでした。
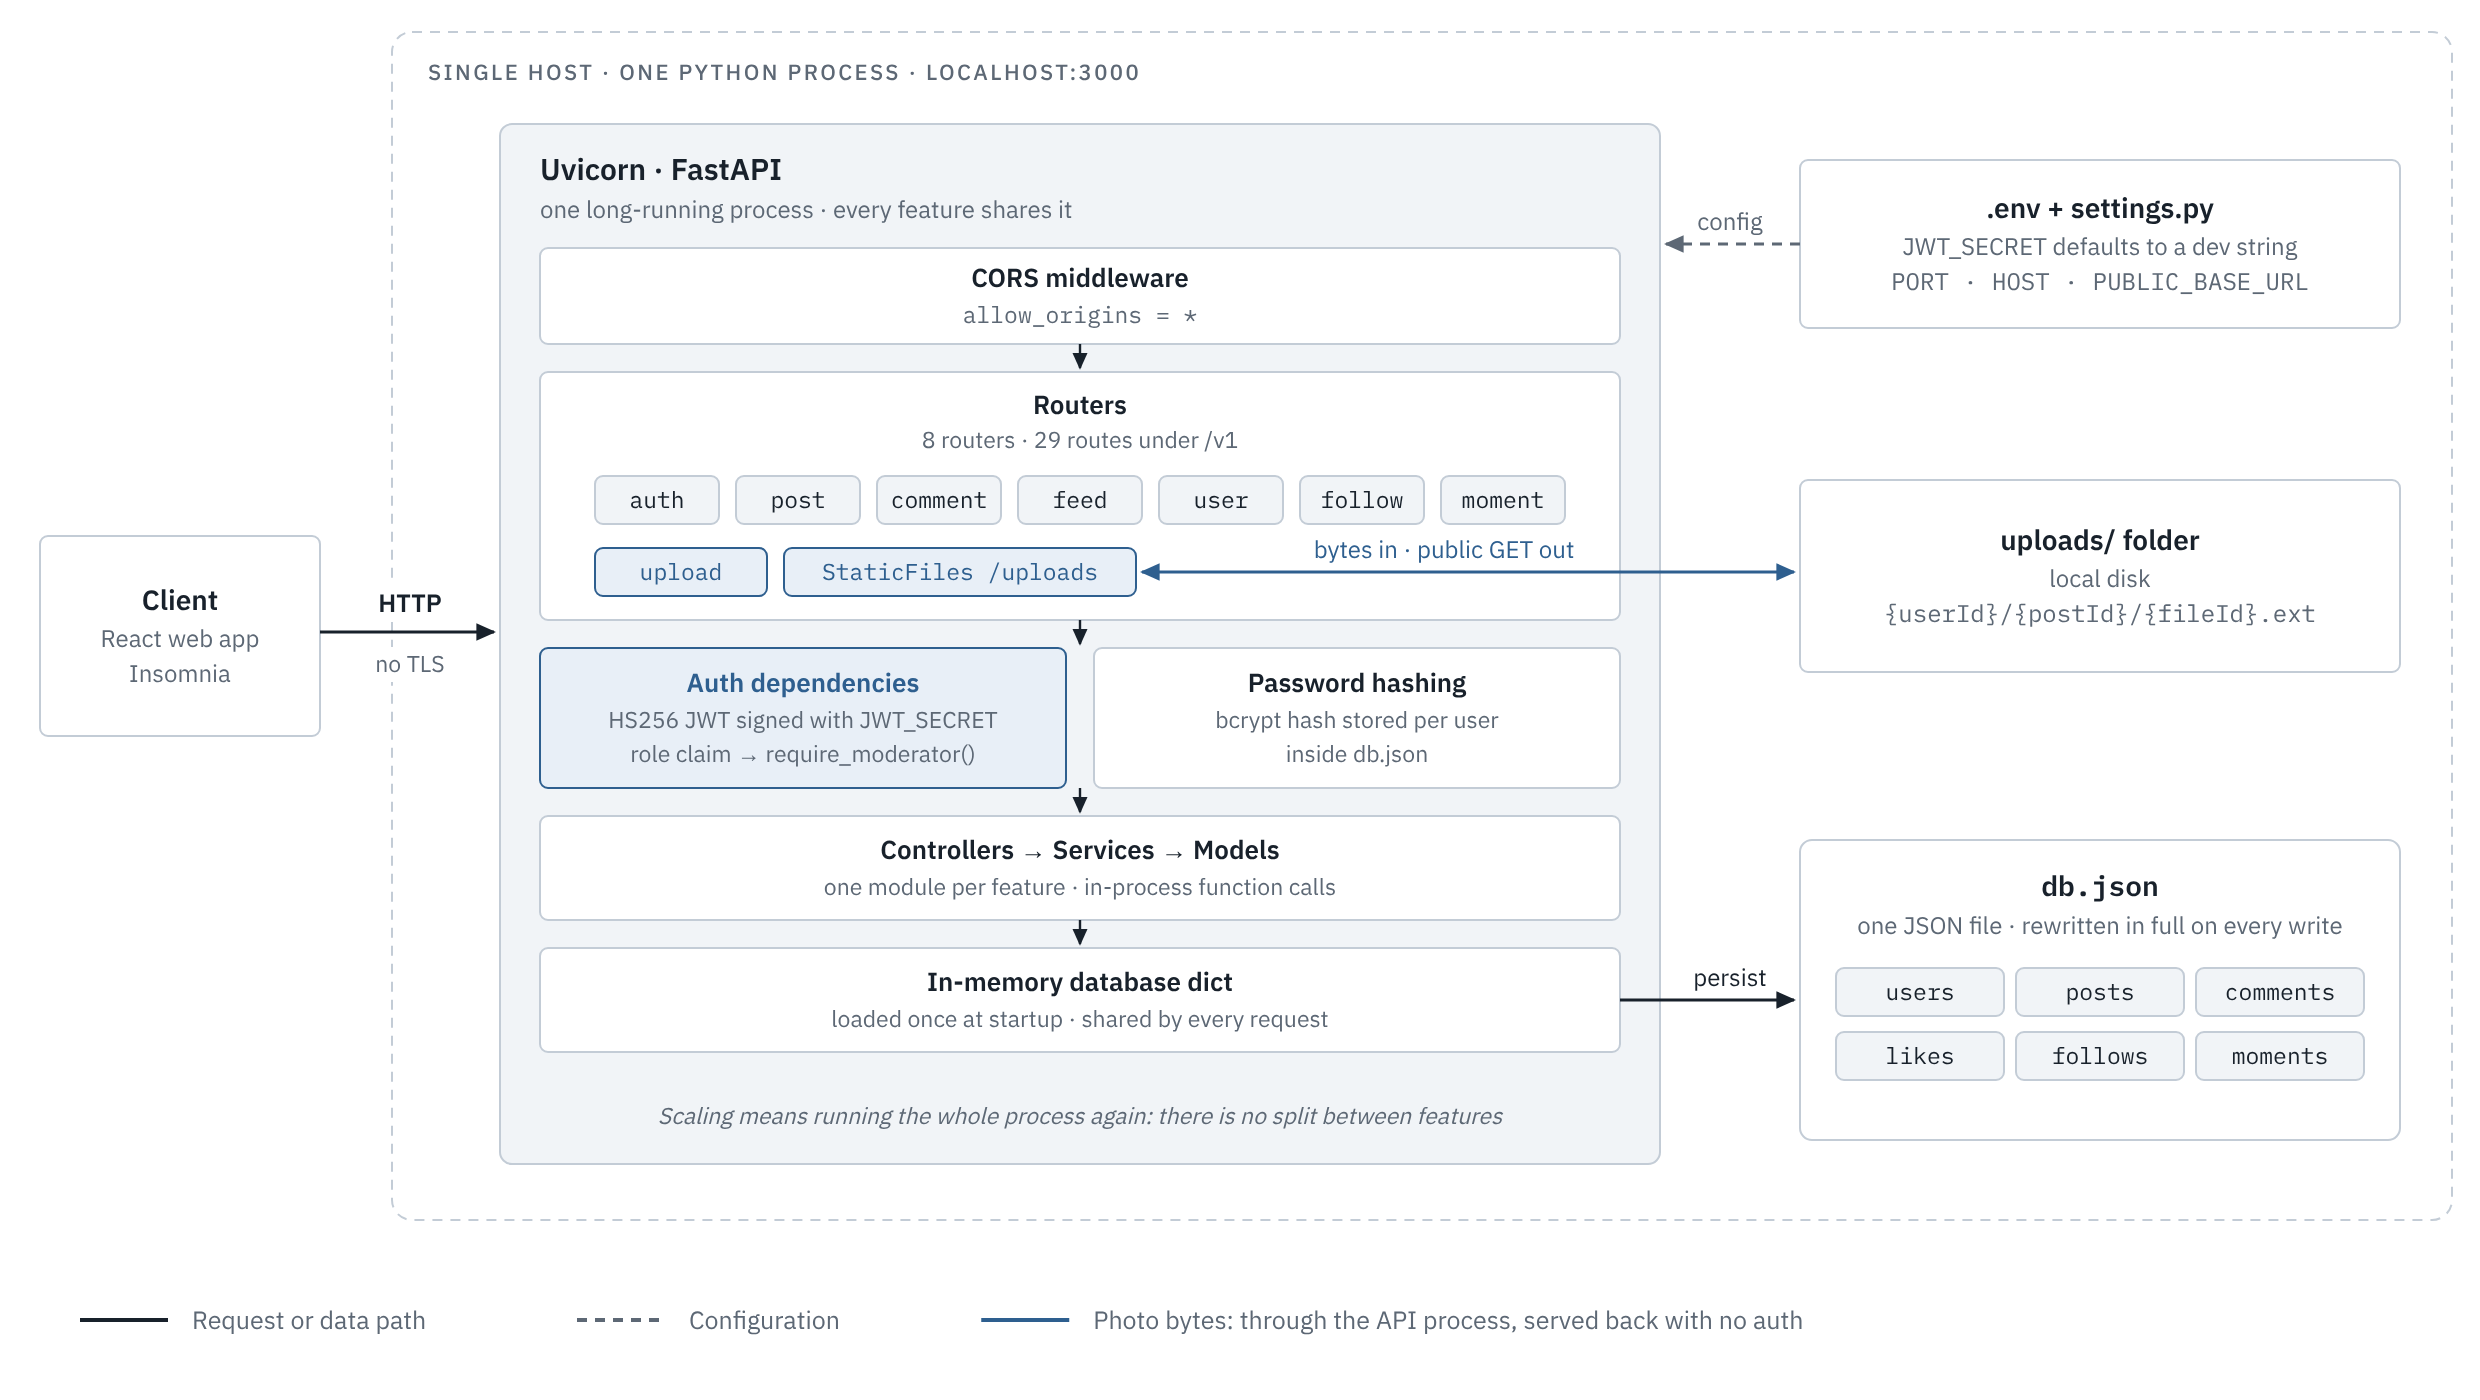
1つのPythonプロセスがすべてを担っていました。
- CORS
- ルーティング(ルーター8つ、ルート29本)
- 認証
- ビジネスロジック
- JSONファイルへのデータ保存
- ファイルのアップロードと配信
認証は自前で実装されていました。トークンは単一の静的なJWT_SECRET(HS256)で署名され、bcryptのパスワードハッシュは他のすべてのデータと同じJSONファイルに保存されていました。これは現実的なセキュリティリスクでした。1つのシークレットでトークンの署名と検証の両方を行うため、それを入手した人は誰でも、任意のsubやrole(モデレーターを含む)を持つ有効なトークンを偽造できてしまいます。また、db.jsonを入手した人は認証情報の全データを手に入れ、アプリケーションのデータを改ざんすることもできました。
def generate_token(user: dict) -> str:
	"""Generate a signed JWT for the authenticated user."""
	payload = {
		"sub": user["id"],
		"role": user["role"],
		"username": user["username"],
		"exp": datetime.now(timezone.utc) + timedelta(hours=TOKEN_EXPIRY_HOURS),
	}
	return jwt.encode(payload, settings.jwt_secret, algorithm="HS256")
// db.json
"users": [
{
"id": "d819f8dbxxxxxx",
"username": "xxx@example.org",
"email": "xxx@example.org",
"password": "$2b$10xxxxxx",
"role": "moderator",
"createdAt": "2024-11-22T22:07:49.851764Z",
"updatedAt": "2026-08-01T23:26:43.281541Z"
},
...
]データベース全体は起動時にインメモリの辞書へ読み込まれ、変更があるたびにdb.json全体が書き直されていました。これは非効率なうえ、同時書き込みに対するロックもなく、ファイルが失われた場合に復元できる地点もありませんでした。
写真はAPI経由でローカルのuploads/ディレクトリにアップロードされ、ログイン不要の公開パスから配信されていたため、画像のリンクはいつまでも有効なままでした。
開発者1人で使う分にはこれで問題ありませんでしたが、スケールさせる方法はプロセス全体のコピーをもう1つ動かすことしかなく、すべての機能が同じ障害要因を共有していました。
クラウドネイティブなアーキテクチャ設計
モノリスの構成要素をAWSサービスに対応づける
まず、元のバックエンドの主要な構成要素をそれぞれAWSのサービスに対応づけました。
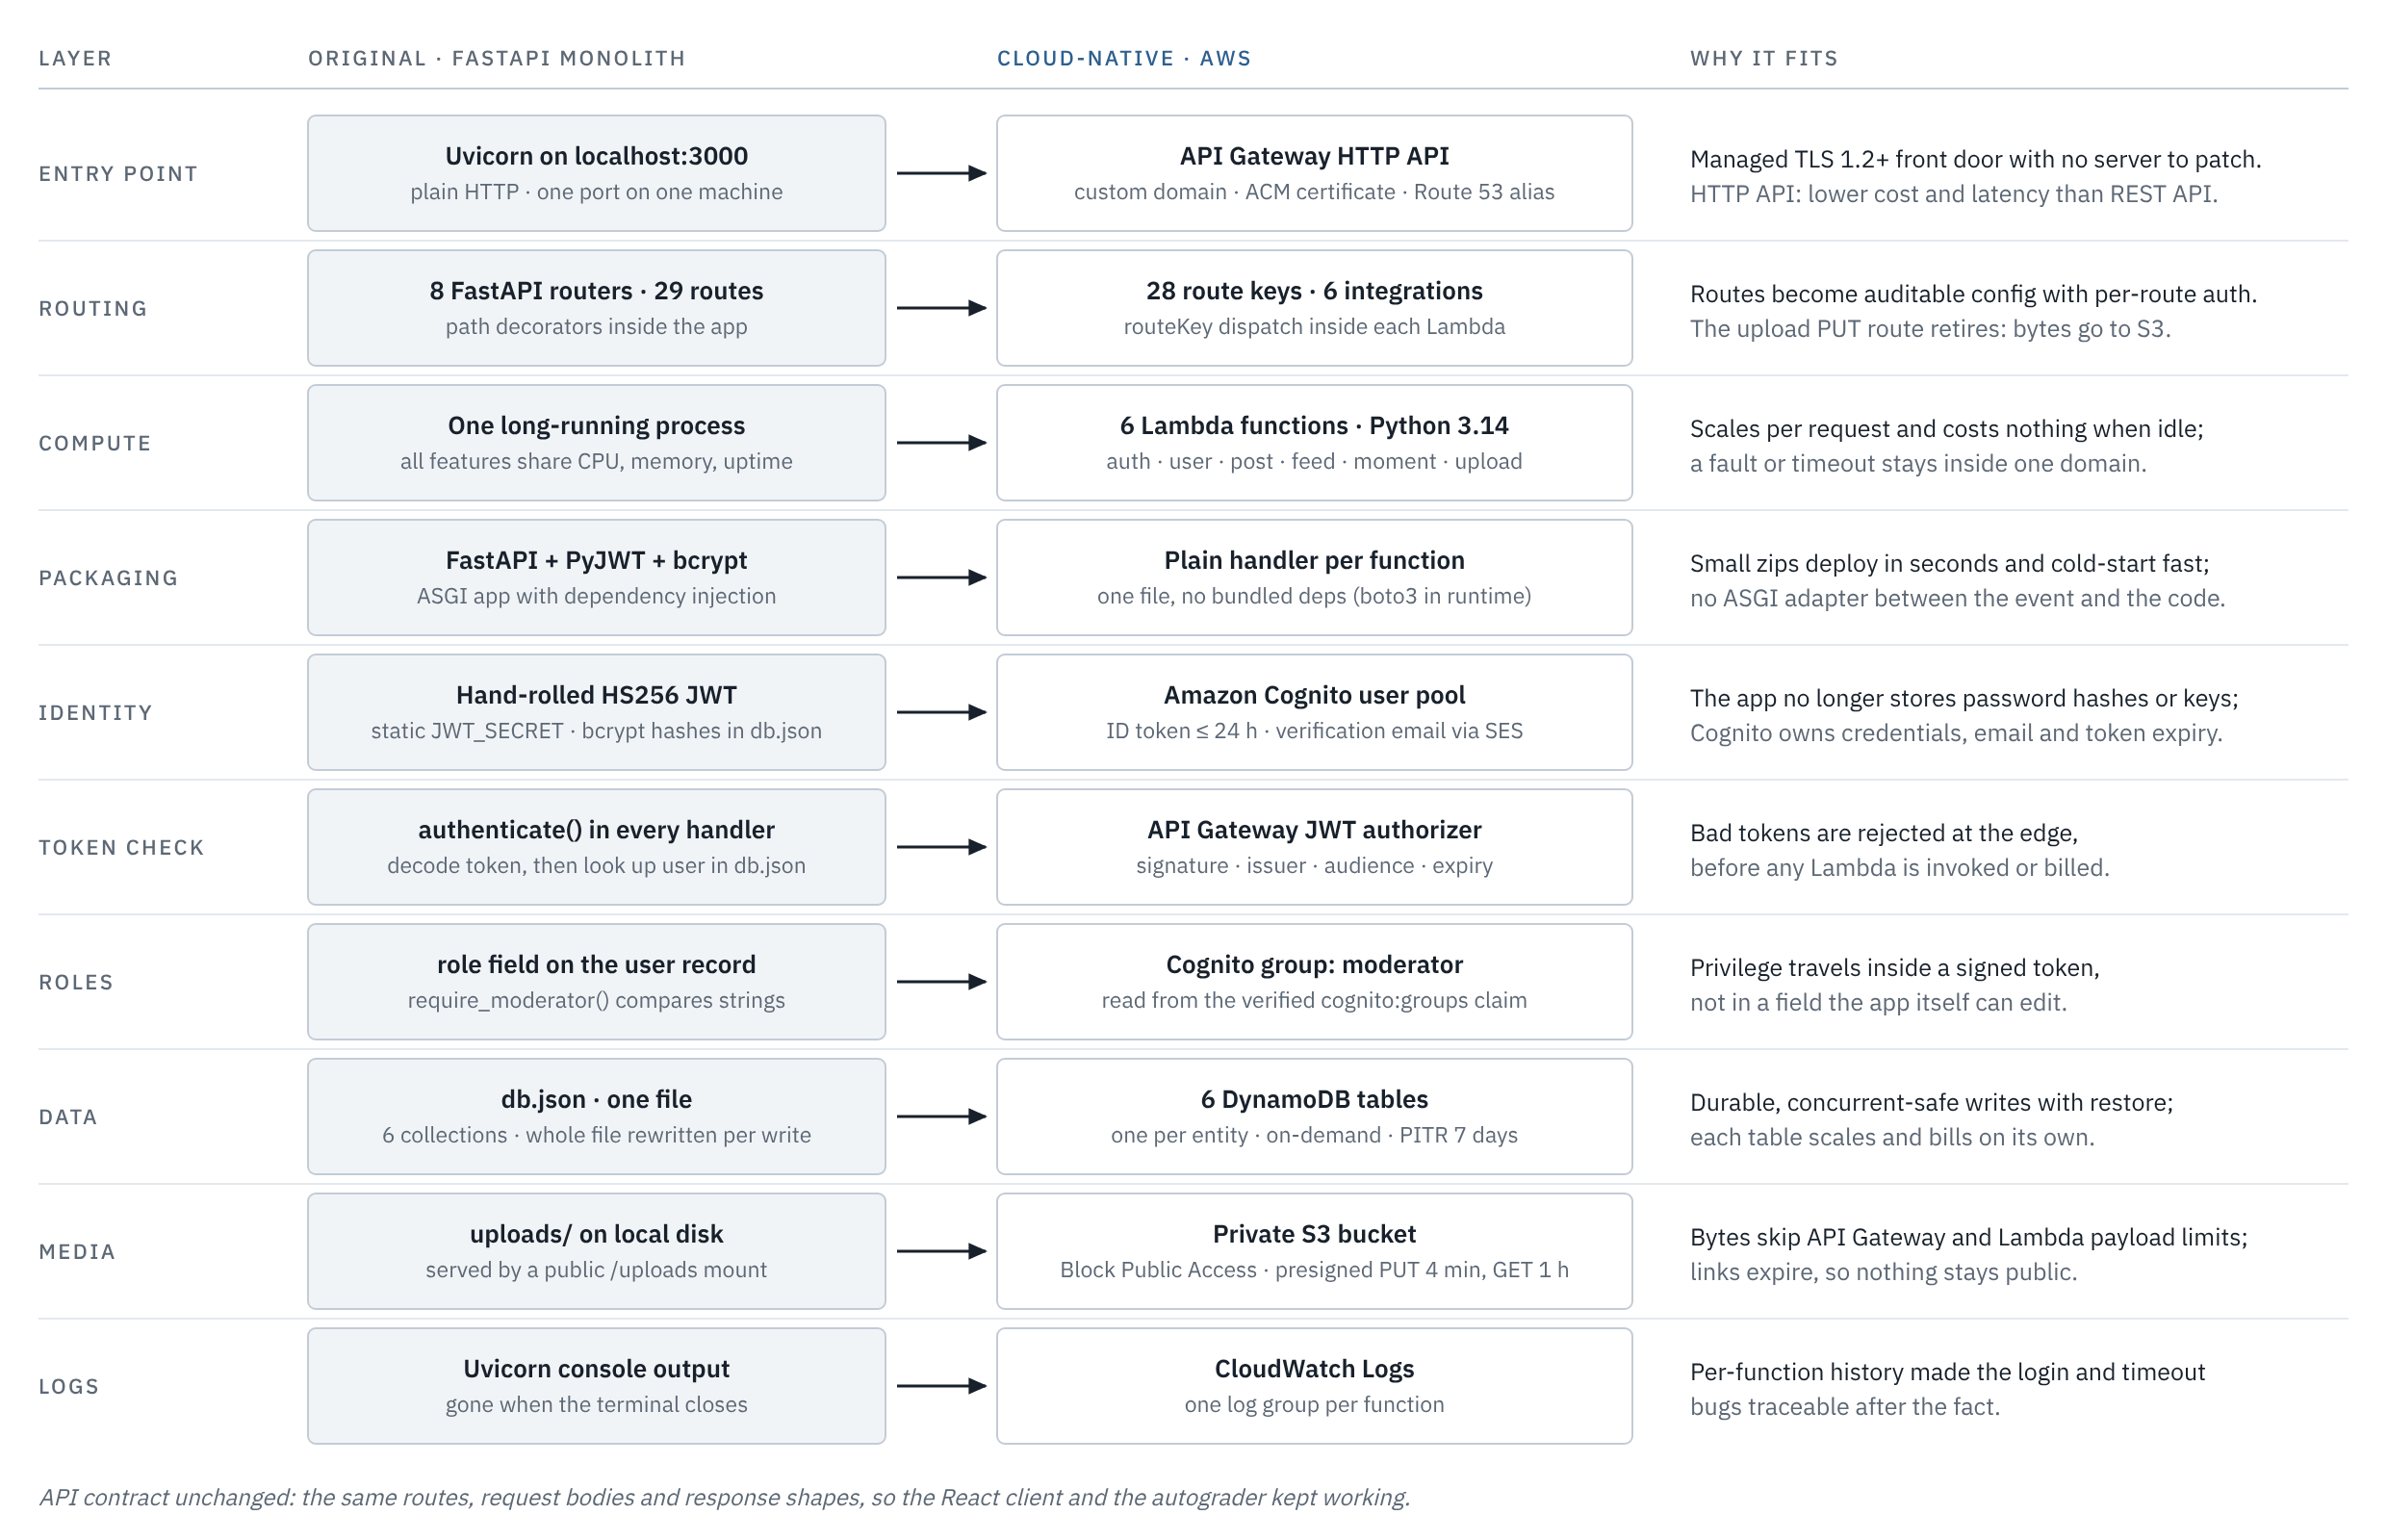
全体を通して守ったルールは1つです。APIの契約を変えないこと。これにより、手を加えていないReactクライアントがそのまま動き続けました。
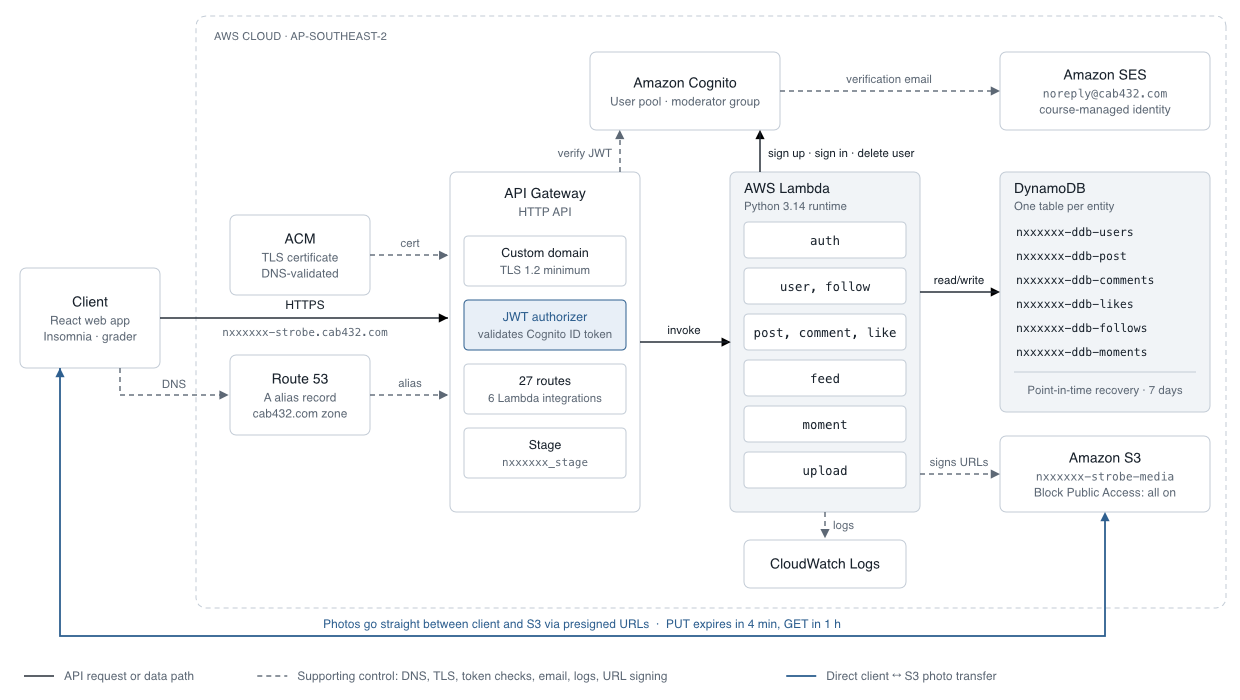
入口は、カスタムドメイン上のAPI Gateway HTTP APIに置き換え、ACM証明書とRoute 53のエイリアスレコードを組み合わせました。REST APIではなくHTTP APIを選んだのは、コストが低く、レイテンシの増加が小さく、JWTオーソライザーが組み込まれているためです。
単一のプロセスは6つのLambda関数に分割しました。これにより、各ドメインがリクエスト単位でスケールし、アイドル時のコストはゼロになり、障害も互いに独立します。ハンドラーは、ASGIアダプターの裏でFastAPIを動かすのではなく、依存関係を同梱しない素のPython関数として実装しました(boto3はランタイムに含まれています)。各デプロイパッケージは1ファイルだけなので、デプロイは数秒で終わり、コールドスタートも短く抑えられます。
ID管理、データ、メディア、ログは、それぞれの用途に特化したサービスへ移しました。
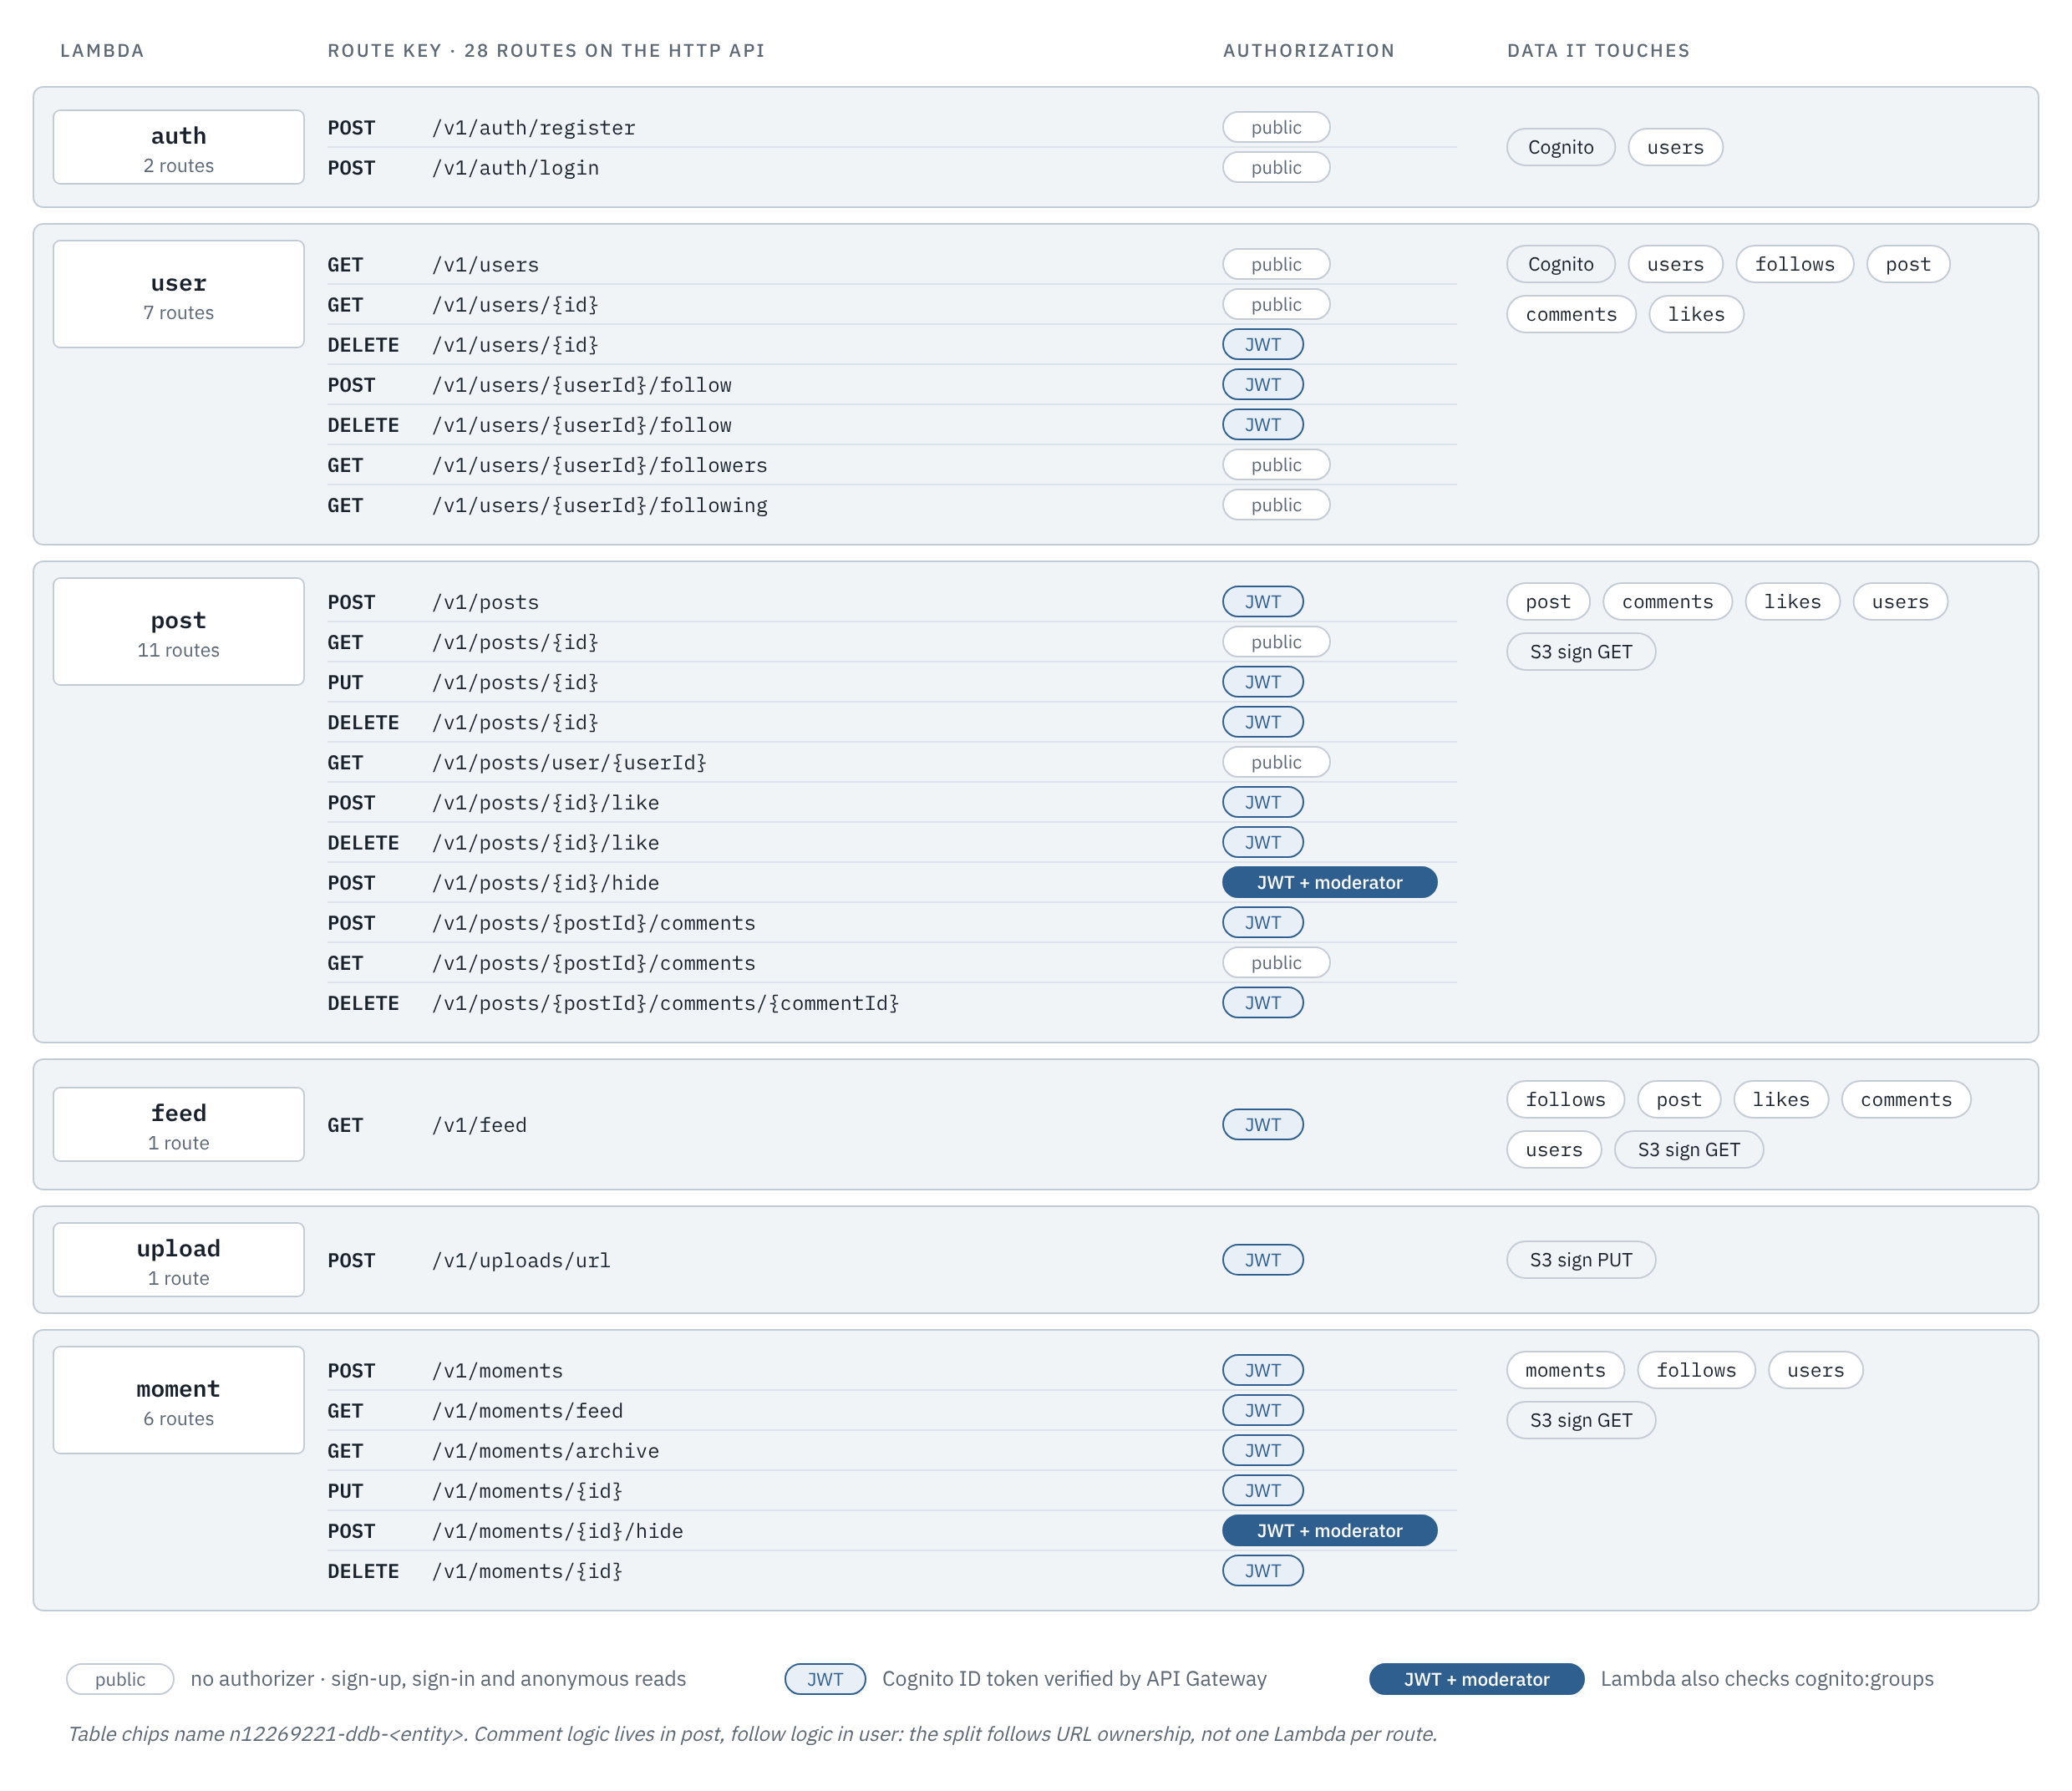
ルートからLambdaへ
HTTP APIには27本のルートがあり、6つのLambdaが処理しています。モノリスにあったアップロード用のPUTルートは、画像のバイトデータがS3へ直接送られるようになったため廃止しました。分割の基準はURLの所有関係です。コメントのルートは/v1/posts/...配下にあるのでpostに、フォローのルートは/v1/users/...配下にあるのでuserに置いています。これにより、巨大なLambda 1つになることも、極小のLambda 27個になることも避けられます。認可はルートごとに設定しており、9本は公開、17本はCognitoのトークンが必要、さらにモデレーター向けの2つの操作ではLambda内でcognito:groupsクレームも確認しています。
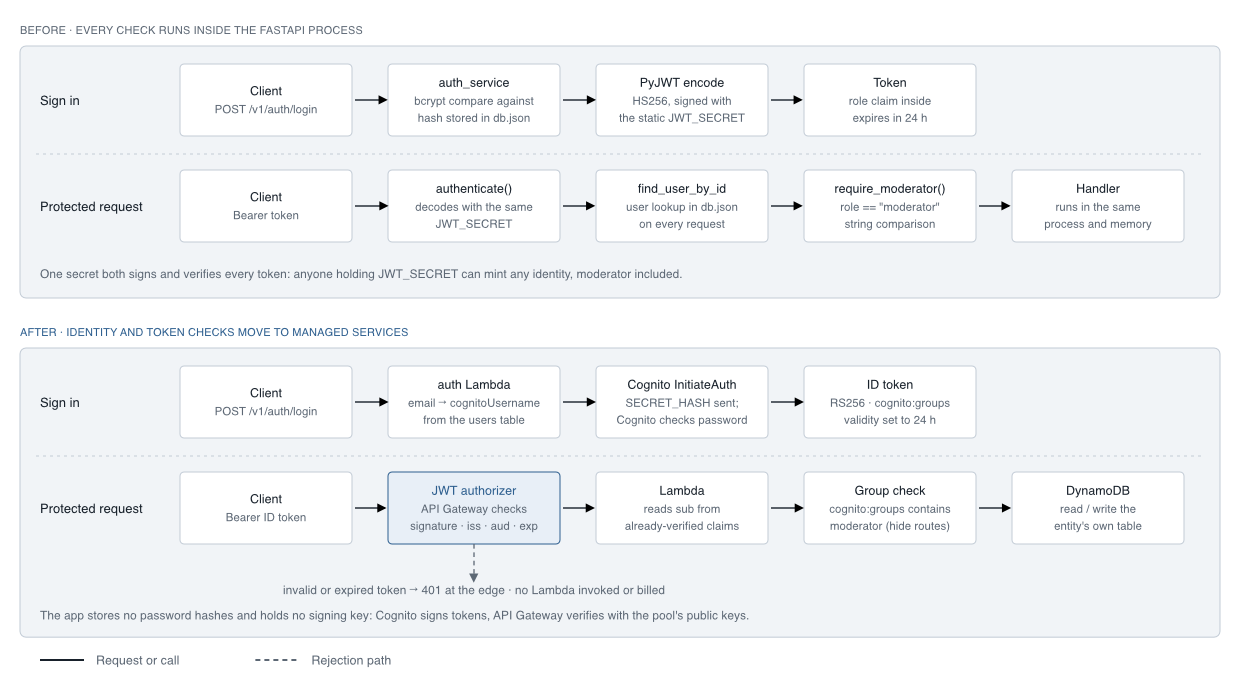
認証
移行前は、1つのシークレットですべてのトークンの署名と検証を行っていたため、JWT_SECRETを持っている人なら誰でも、モデレーターを含む任意のIDのトークンを発行できました。また、保護されたリクエストのたびにdb.jsonからユーザーを検索する必要がありました。
移行後は、Cognitoがパスワードを管理し、独自の鍵でトークンに署名します。API Gatewayは、Lambdaが実行される前に各トークンの署名、発行者、オーディエンス、有効期限を検証します。不正なトークンは、コンピューティングを一切起動する(そしてその料金を払う)ことなく、エッジで401が返されます。モデレーター権限は、アプリ自身が編集できるroleフィールドではなく、署名済みのcognito:groupsクレームから判断します。
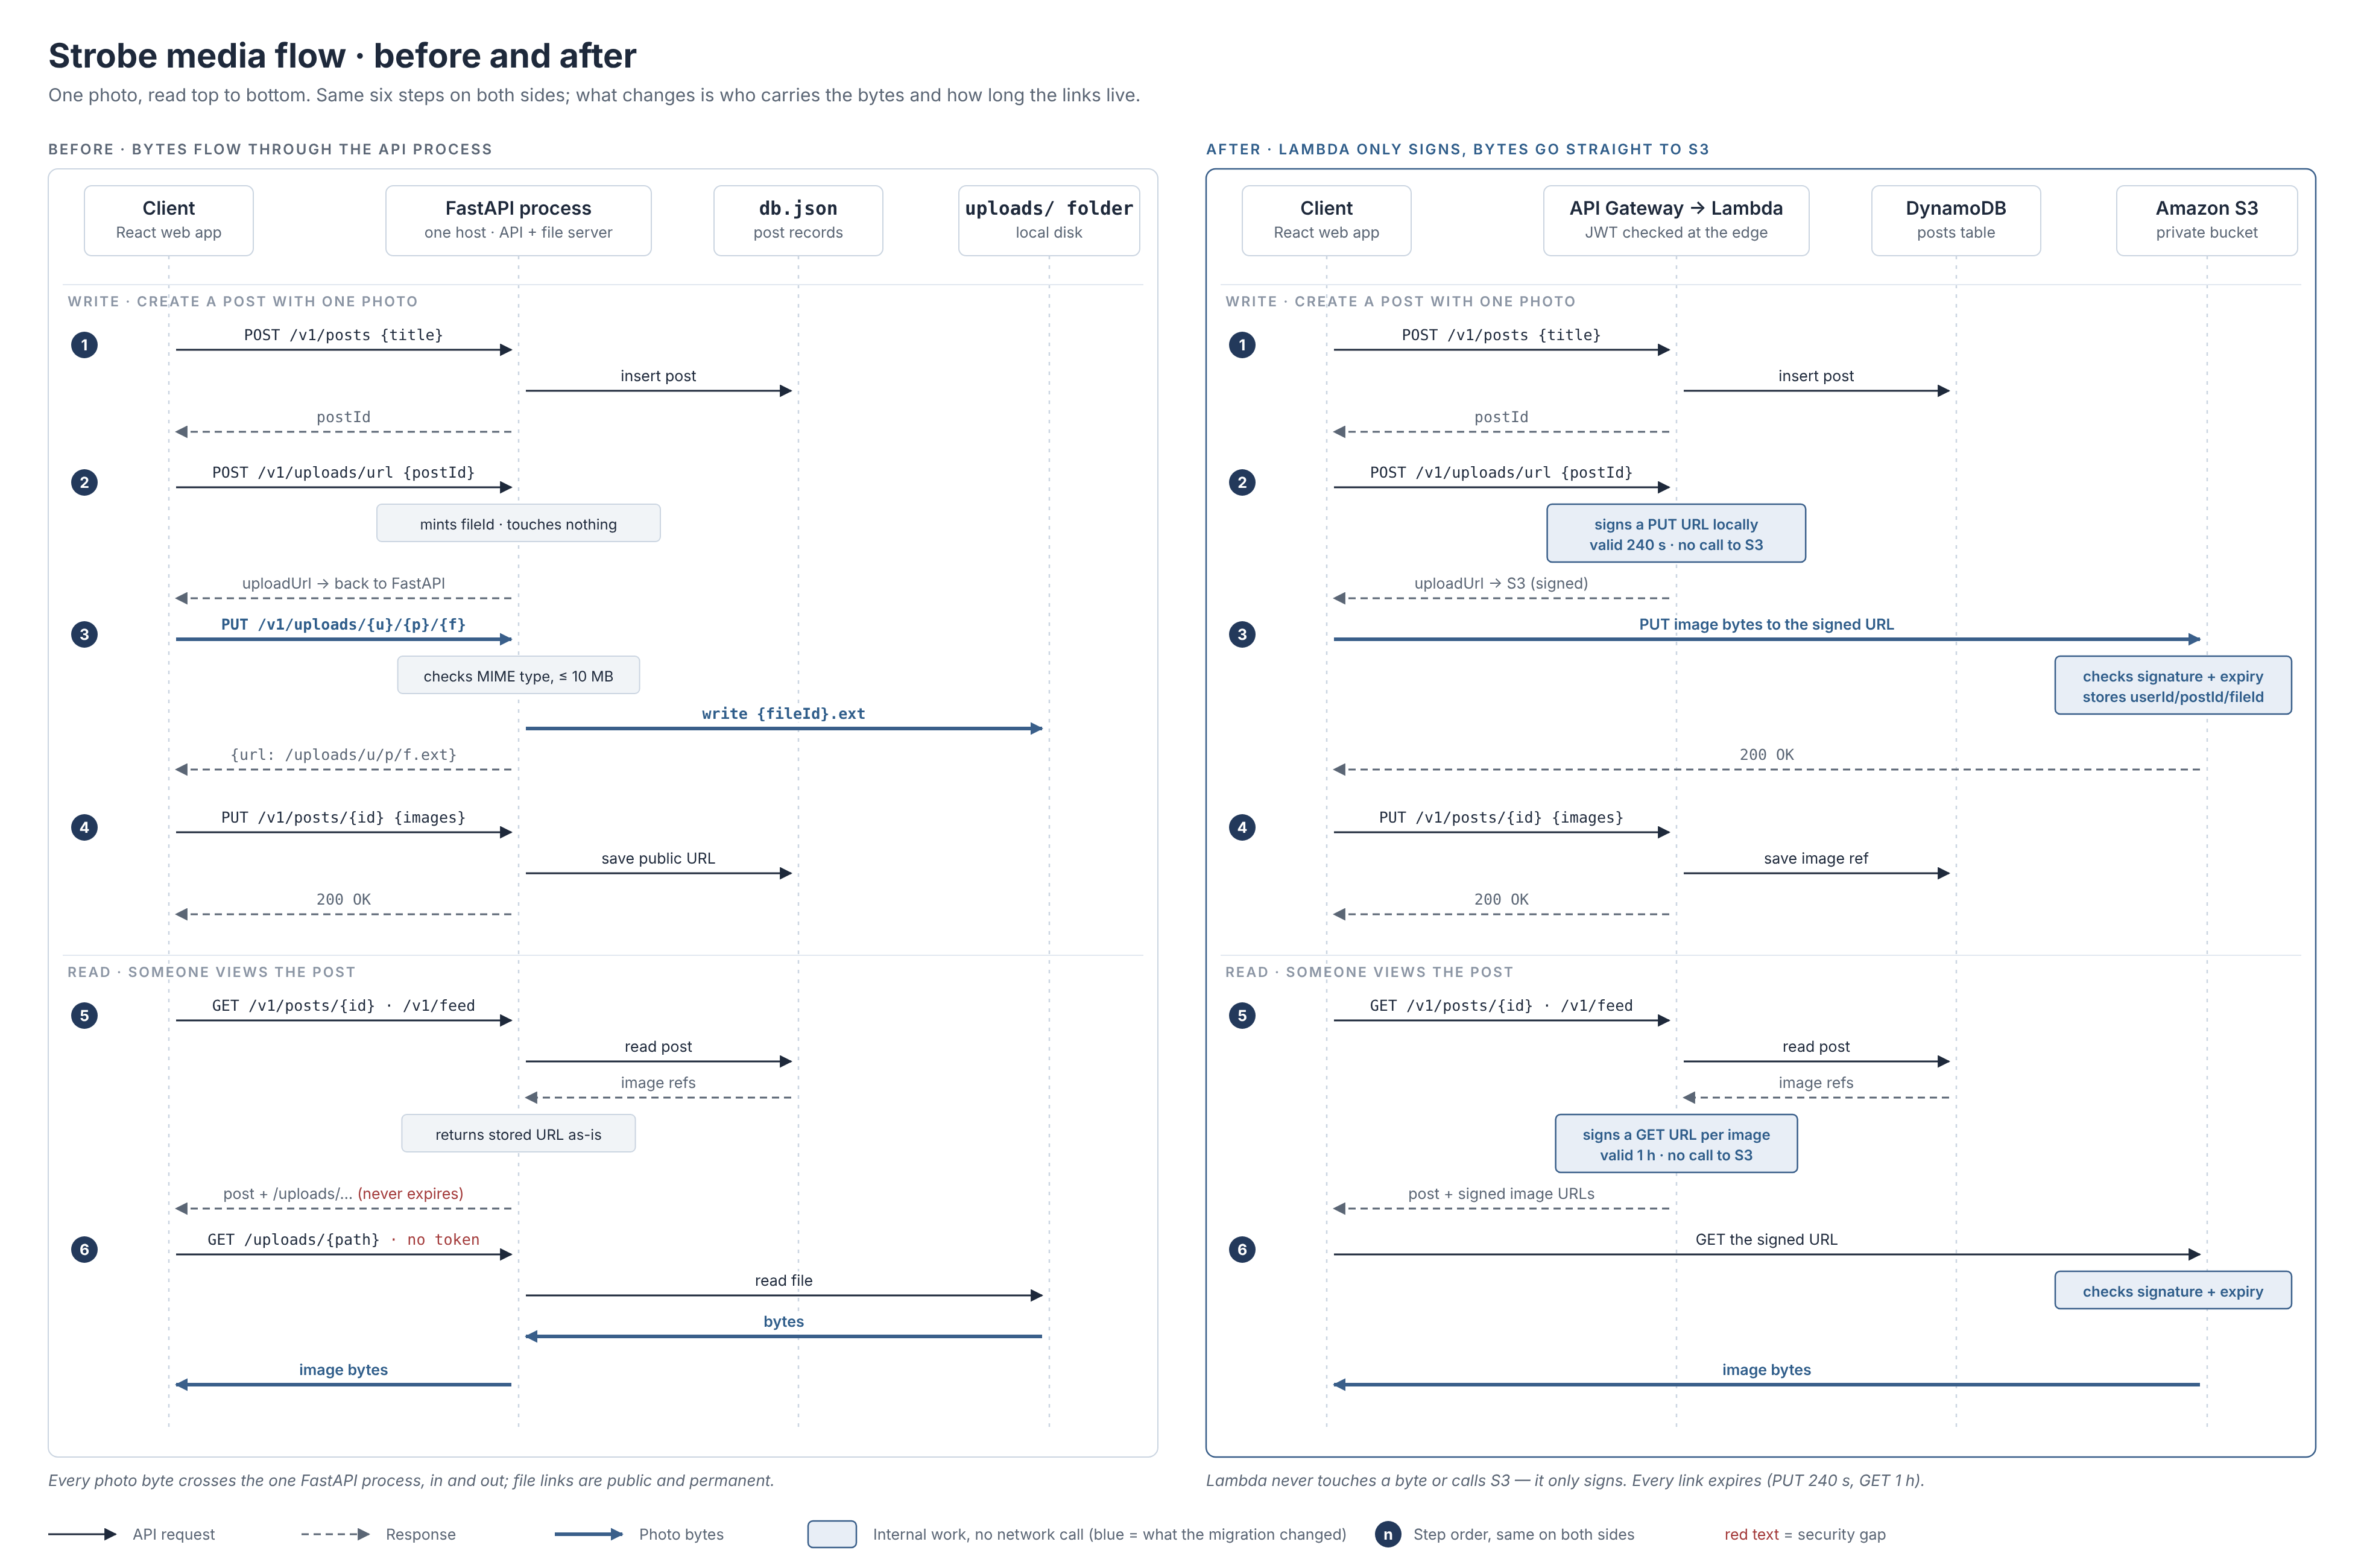
メディア
移行前は、写真のバイトデータがすべてAPIプロセスを経由し、保存されたリンクはいつまでも公開されたままでした。移行後は、LambdaはURLに署名するだけです。アップロード用URLは240秒間有効で、オブジェクトキーuserId/postId/fileIdに紐づけられ、閲覧用URLは1時間有効です。署名はローカルでの計算なので、LambdaがS3を呼び出したり画像のバイトデータを扱ったりすることはありません。クライアントは、ブロックパブリックアクセスを完全に有効にした非公開のS3バケットに対して直接アップロード・ダウンロードを行います。これにより、API GatewayやLambdaのペイロード上限を回避でき、ファイル転送がコンピューティングの料金に含まれなくなり、いつまでも有効なリンクもなくなります。
データ
1つのファイルは、エンティティごとに1つずつ、計6つのDynamoDBテーブルになりました。いずれもオンデマンドキャパシティで、7日間のポイントインタイムリカバリを有効にしています。図のグリッドが示すように、各Lambdaは必要なテーブルにしかアクセスしません。feedは読み取りのみ、uploadはDynamoDBに一切触れず、他のドメインのテーブルから削除を行うのはuserだけです。これはアカウント削除の際に、そのユーザーの投稿、コメント、いいね、フォローを連鎖的に削除するためです。
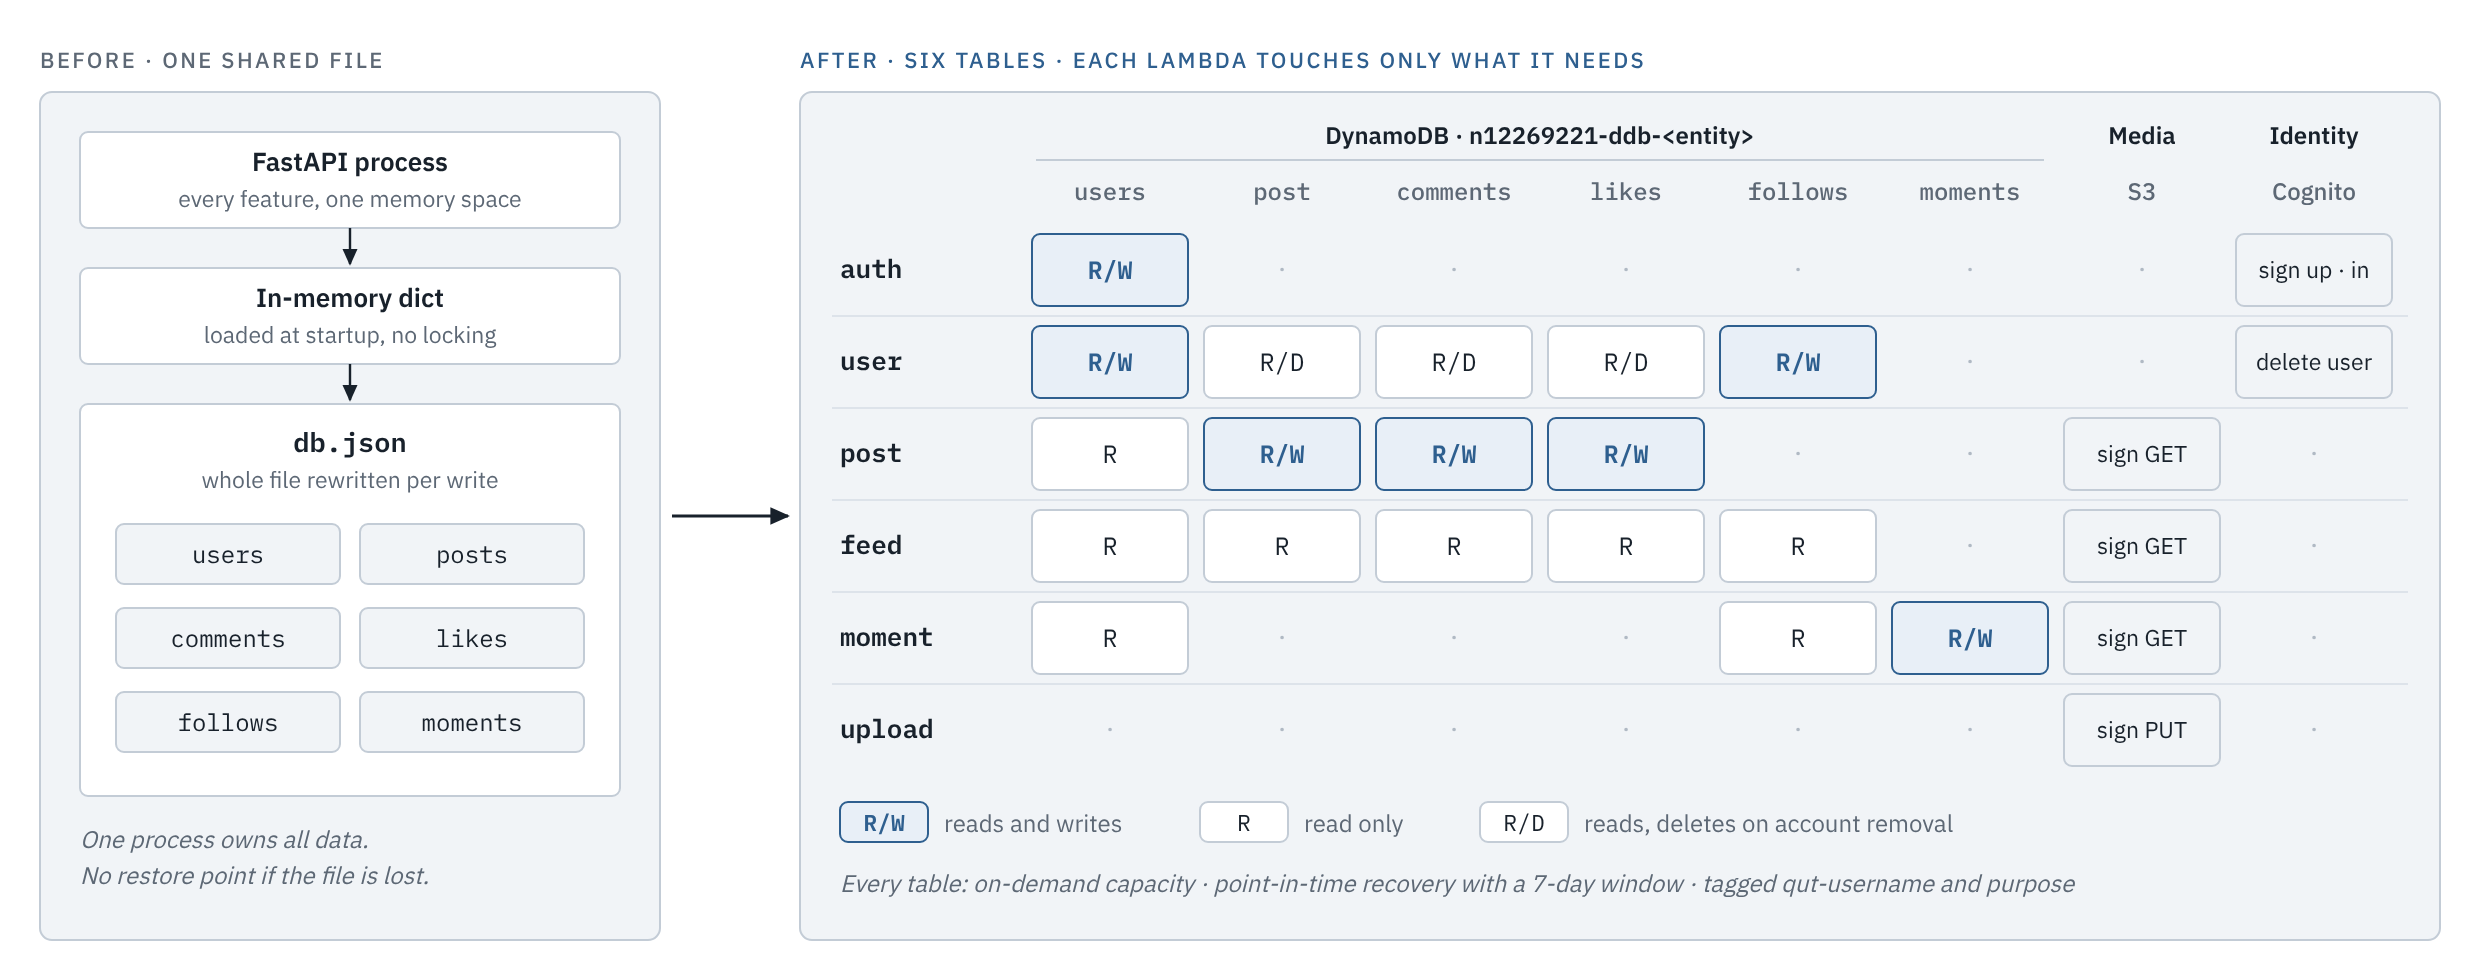
厳密に言えば、これらは教科書どおりのマイクロサービスではなく、ドメイン単位に区切った関数です。各Lambdaが自分のデータを独自のAPIの裏に持つのではなく、複数のLambdaが互いのテーブルを読み合っているからです。この規模ではこのトレードオフによってコードをシンプルに保てましたが、システムが成長したときには真っ先に境界を引き締めるべき箇所です。
新しいクラウドネイティブなサーバーレスアーキテクチャ
これらの構成要素を組み合わせた結果、元のバックエンドのすべての機能を備えつつ、セキュリティ、スケーラビリティ、保守性のいずれも向上したサーバーレスアーキテクチャができあがりました。
- ID管理: 認証情報とトークンの発行はCognitoが担い、プロフィールデータはローカルのJSONファイルではなく専用のDynamoDBテーブルに保存されます。アプリはもはやパスワードハッシュも署名鍵も保持しません。
- エッジ: すべてのトラフィックはHTTPS(TLS 1.2以上)でAPI Gatewayを経由して届きます。API Gatewayはルートを一元管理し、保護されたパスの手前で認証の境界を強制します。
- コンピューティング: ビジネスロジックはドメインごとに6つのLambdaに分かれています。ある関数の障害やタイムアウトが他の関数を巻き込むことはなく、関数ごとのCloudWatchロググループによって、障害を事後に追跡できます。
- メディア: 写真は有効期限の短い署名付きURLを通じてクライアントとS3の間で直接やり取りされるため、メディアの処理はAPIから完全に切り離されています。
課題と制約
「username」と呼ばれる4つのもの
ログインをCognitoに移行した後、後半のユーザーストーリー全体で401エラーが相次ぎました。根本原因は命名にありました。1人のユーザーに対して、「username」と呼ばれるものが4つ存在していたのです。クライアントが送信するJSONフィールド、アプリ独自のusername属性、Cognitoの変更不可な内部Username(このユーザープールはメールアドレス形式のユーザー名を受け付けないため、UUIDになっています)、そしてそのUUIDか検証済みのメールエイリアスを受け付けるInitiateAuthのUSERNAMEパラメータです。バグは1つ目にありました。ログインハンドラーはリクエストボディからemailを読み取っていましたが、クライアントが送っていたのはusernameでした。調査の全容はFour Things Called "Username": An Email-vs-Username Login Bug in Amazon Cognito(英語)にまとめています。
インメモリ前提の習慣はDynamoDBでは通用しない
最初の移植では、モノリスのアクセスパターンをそのまま残していました。投稿ごとに投稿者を検索し、いいねとコメントの数を数えるというものです。インメモリの辞書が相手なら、これにコストはかかりません。しかしDynamoDBが相手だと、投稿1件ごとに投稿者の検索1回とテーブル全体のスキャン2回が発生し、しかもすべてが順番に実行されます。50件の投稿があるプロフィールページでは約150回のラウンドトリップが必要になり、Lambdaのデフォルトのタイムアウトである3秒を超えてしまい、API Gatewayはそれを500として返していました。
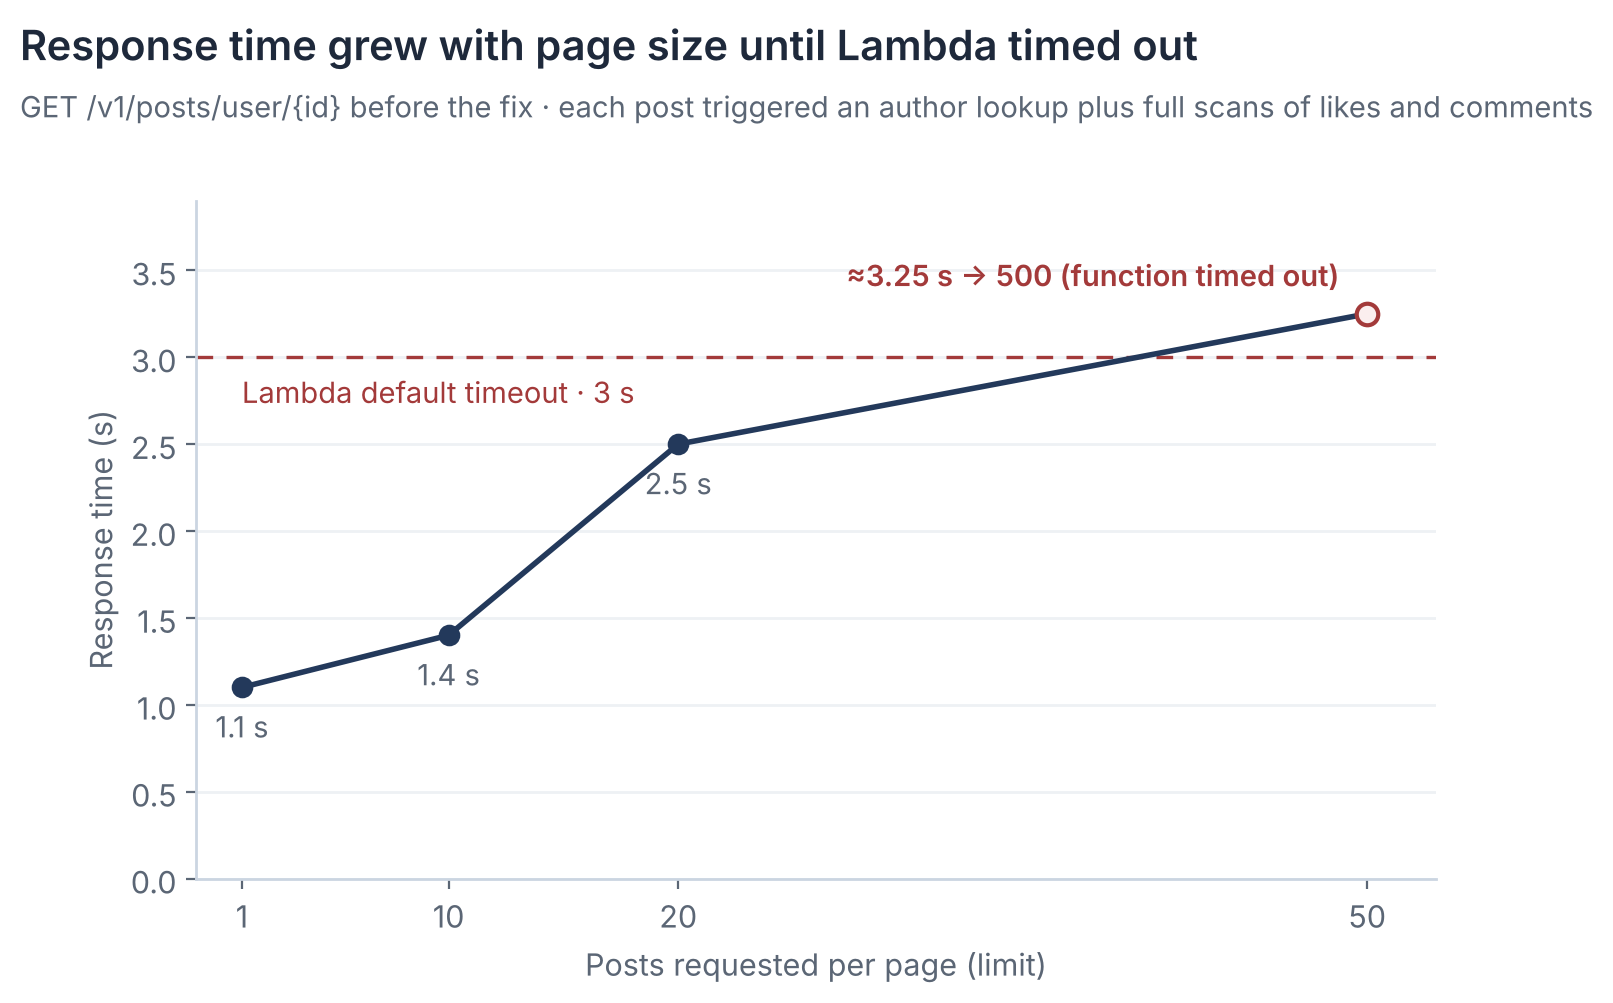
そこで、データを付加する処理を書き直し、リクエストごとに各テーブルを1回だけスキャンして、件数をメモリ上で集計するようにしました。より根本的な対策、つまりアプリが実際に行うクエリに合わせてキーとセカンダリインデックスを設計することは、まだ手つかずです。多くの読み取りは依然としてScanであり、テーブルが大きくなるにつれて遅く、高くつくようになります。
アップロード時の検証が失われた
モノリスでは、ファイルをディスクに書き込む前に、MIMEタイプを確認し、サイズを10 MBに制限していました。署名付きのPUT URLでは、バイトデータが私のコードを経由せずS3へ直接送られるため、これらのチェックはなくなってしまいました。コンテンツタイプとcontent-length-rangeのポリシー条件を付けた署名付きPOSTを使えば、ストレージ層でこれらの検証を復活させられます。
コンソールでの手作業による構築
アーキテクチャはスケールしますが、その構築方法はスケールしません。リソースの大半はAWSのWebコンソールから設定しており、スクリプト化したのはLambdaのコードのデプロイだけでした。別のアカウントやリージョンでスタックを再構築するには、何十もの手作業を繰り返す必要があり、設定のドリフトも目に見えません。たとえば、Cognitoのアプリクライアントはデフォルトでトークンの有効期限が60分になっており、フロントエンドにはリフレッシュの処理がないため、ユーザーは1時間後に、再ログインするまで保護された機能から何の通知もなく締め出されていました。Infrastructure as Codeであれば、この設定は明示的でレビュー可能なものになっていたはずです。TerraformやCDKでスタックを定義することが、真っ先に変えたい点です。
学んだこと
モノリシックなバックエンドは、最初は手に負えないように思えましたが、機能単位のモジュールに分解することで、移行を扱いやすいものにできました。鍵となったのは、最終的なアーキテクチャを一度に設計しようとしなかったことです。まず1つのモジュールから始め、その周りに他のサービスを1つずつ組み上げていきました。AWSのサービスは疎結合で組み合わせやすいため、各構成要素を単独で接続し、テストし、差し替えることができ、開発をスピーディーかつ影響範囲を限定した形で進められました。
スタックの大半はAWSのWebコンソールで構築しました。これは上で制約として挙げた点ですが、同時に学ぶうえでは最良の方法でもありました。AWSにはサービスもオプションも非常に多くありますが、コンソールの対話的な画面のおかげで、サービス同士の関係や、それぞれが提供する設定項目を、ドキュメントだけで学ぶよりもはるかに理解しやすく、気軽に試すこともできました。各設定が何をするのかを理解した今、それをコード化するのが自然な次のステップです。
何よりこのプロジェクトで学んだのは、システムをクラウドに移すことと、クラウド向けに設計することは同じではない、ということです。構成要素はマネージドサービスにきれいに対応づけられますが、その裏にある暗黙の前提はそうはいきません。メモリ上ならタダだったデータアクセスはネットワーク呼び出しになり、リクエストの経路上にあった検証は、バイトデータがその経路を通らなくなった途端に消えてしまいます。そうした前提を見つけ出すことこそが、この取り組みで最も価値のある部分でした。