
Transformerの学習は圧倒されるように感じるかもしれませんが、その根底にある考え方は意外なほどシンプルです。私が思うに、鍵になるのはアテンションが本当は何なのかを理解することです。なにしろ、元祖となった論文のタイトルにあるとおり、"Attention is all you need"なのですから。
とはいえ、本当に理解するには少し数学が必要でした。具体的には、ベクトルと行列の演算に慣れておくと助けになります。私の場合、2つの行列を掛け合わせ、その形状を追えるようになったところで、残りがすっと腑に落ちました。
この記事ではまず、Query、Key、Valueを使ってアテンションをゼロから組み立てます。そのうえで、私が何度も出くわしたさまざまな種類のアテンション、つまりセルフアテンション、クロスアテンション、マルチヘッドアテンションを整理していきます。
パート1:類似度のためのQuery(Q)、Key(K)、Value(V)
アテンションの核心は類似度です。同じ系列内の単語どうしであれ、異なる系列間であれ、それは変わりません。Query(Q)、Key(K)、Value(V)はその類似度を計算するための行列で、それぞれがはっきり異なる役割を担っています。
- Query(Q):「自分は何を探しているのか?」トークンごとに1つ。そのトークンが系列の残りの部分に投げかける問いです。
- Key(K):「照合用のラベルとして、自分は何を差し出せるのか?」トークンごとに1つ。他のトークンに見つけてもらうために、そのトークンが自分をどう示すかです。
- Value(V):「選んでもらえたら、実際にどんな情報を渡すのか?」トークンごとに1つ。照合が成立したときに受け渡される中身です。
私は図書館にたとえて考えるのが気に入っています。私のクエリは図書館に持ち込むテーマ、キーは本の背に貼られたラベル、バリューは本の実際の中身です。自分のテーマをすべてのラベルと見比べ、いちばんよく合う本を読むわけです。
Q、K、Vはどこから来るのか?
どれも同じところから来ます。、つまり系列全体のトークン埋め込み行列です。ここでは系列長です。
、、はそれぞれ、をそれぞれ専用の学習済み重み行列で線形変換したものです。
(はと等しいことが多いですが、必ずしもそうである必要はありません。)
つまり、同じトークンが3通りに射影されるということです。問いとして1回、ラベルとして1回、中身として1回です。
類似度スコアからアテンションへ
順を追って見ていく前に、まずはパイプライン全体を一目で確認しておきましょう。
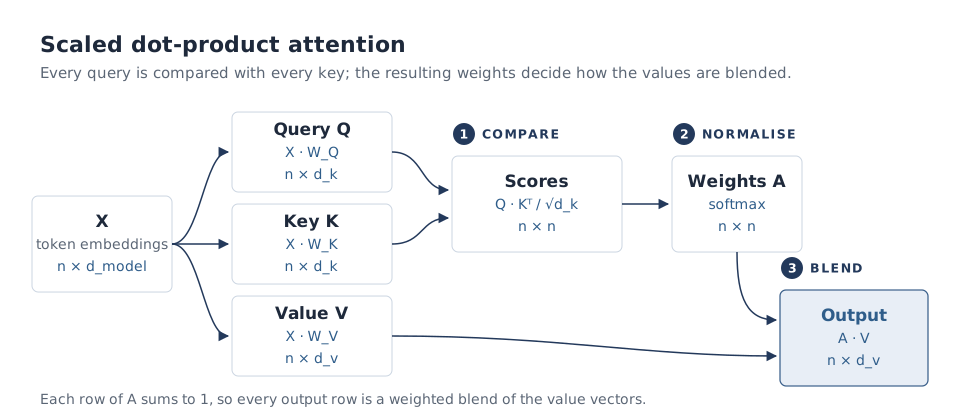
ステップ1:生のスコア。 すべてのクエリをすべてのキーと比較します。
これはただのドット積による類似度で、本質的には*「自分のクエリからすると、系列内のどの単語がいちばんよく合いそうか?」*という問いに答えるものです。行目には、トークンの、系列内のすべてのトークン(自分自身を含む)に対するスコアが入ります。
ステップ2:アテンションの重み。 スコアの各行にsoftmaxをかけ、0から1の間の値で合計が1になる重みに変換します。
ステップ3:重み付けされた値。 最後に、重みをに掛けます。
この重み付けされたアテンションの値こそが、Transformerが最終的にトークンを生成するために先へ受け渡していくものです。どのトークンも、自分が最も関連が深いと判断したトークンから「情報を得た」新しい表現を持つことになります。
実際にはどう見えるのか?
"The cat sat because it was tired."(猫は疲れていたので座った)という文を例にとりましょう。モデルが**"it"**を処理するとき、におけるその行は、たとえば次のようになるかもしれません(数値は説明のための架空のものです)。
| "it" の注目先 → | The | cat | sat | because | it | was | tired |
|---|---|---|---|---|---|---|---|
| 重み | 0.03 | 0.62 | 0.08 | 0.05 | 0.14 | 0.03 | 0.05 |
重みの大部分が"cat"に集まっているので、"it"の新しい表現は、ほとんどが"cat"のバリューから作られます。こうしてモデルは"it"が何を指しているのかを突き止めるのです。私が印象的だと感じたのは、これがソフトな検索だという点です。完全に一致するものを1つ選ぶのではなく、"it"は全員のバリューを、それぞれのキーが自分のクエリにどれだけよく合ったかに応じて重み付けして混ぜ合わせたものを受け取ります。
コードで見てみる
全体はほんの数行で書けます。PyTorchで書くとこうなります。形状はコメントで追っています。
import math
import torch

torch.manual_seed(0)
n, d_model, d_k, d_v = 4, 8, 8, 8  # 4 tokens, tiny dims so we can eyeball things

X = torch.randn(n, d_model)        # [n, d_model] token embeddings

W_Q = torch.randn(d_model, d_k)    # [d_model, d_k]
W_K = torch.randn(d_model, d_k)    # [d_model, d_k]
W_V = torch.randn(d_model, d_v)    # [d_model, d_v]

Q = X @ W_Q                        # [n, d_k]
K = X @ W_K                        # [n, d_k]
V = X @ W_V                        # [n, d_v]

scores = Q @ K.T / math.sqrt(d_k)  # [n, n]   every query vs every key
A = scores.softmax(dim=-1)         # [n, n]   each row sums to 1
output = A @ V                     # [n, d_v] one blended value per token

print(A.sum(dim=-1))               # tensor([1.0000, 1.0000, 1.0000, 1.0000])
print(output.shape) # torch.Size([4, 8])検算として、PyTorch組み込みのscaled_dot_product_attentionを使っても同じ結果になります。
数式をひとつの位置ずつ紐解く
行列の形は簡潔ですが、私はひとつの位置に絞って見たほうが、何が起きているのかずっとわかりやすいと感じました。
- 現在の位置を、別の位置をとします。クエリとキーのアテンションスコアは、1つの数値(スカラー)です。
- すべてのキーにわたってsoftmaxをかけると、次のようになります(は系列長)。
- 位置の出力は、参照が許されているすべての位置のバリューを重み付けして組み合わせたものです。通常のセルフアテンションならすべての位置、因果マスクがあればそれより前の位置だけです(これについては後述します)。
- 各位置の出力を積み重ねると、系列全体のアテンション値の行列が得られます。
- 実際には、計算してから積み重ねるということはしません。全体がという1回の行列積で得られます。Transformerが非常にGPU向きなのは、まさにこのためです。
ところで、なぜ√d_kで割るのか?
この小さな項は見落としがちですが、重要です。との要素がおおよそ平均0、分散1だとすると、それらのドット積は個の項の和になるので、分散はおよそ、ばらつき(標準偏差)はおよそまで大きくなります。簡単な実験で確かめられます。
for d_k in [4, 64, 512]:
    q, k = torch.randn(10_000, d_k), torch.randn(10_000, d_k)
    print(d_k, (q * k).sum(dim=-1).std())
# 4    ≈ 2.0
# 64   ≈ 8.0
# 512  ≈ 22.6
スコアが大きいとsoftmaxにとっては厄介です。softmaxが飽和して、ほぼすべての重みが1つのトークンに乗り、それ以外のすべてにはほとんど勾配が残らなくなってしまいます。
s = torch.tensor([2.0, 1.0, 0.5])
s.softmax(-1)        # tensor([0.63, 0.23, 0.14])     nice and spread out
(s * 8).softmax(-1) # tensor([0.9997, 0.0003, 0.0000]) basically one-hotで割ることで、ベクトルの次元がどれだけ大きくても、スコアを適切なスケールに戻せます。これがスケールド・ドット積アテンションという名前の由来です。
パート2:さまざまな種類のアテンション
アテンションという言葉はTransformerのあらゆるところで使われていて、私もいろいろな種類のアテンションに出くわしました。パート1と同じ基本的な考え方の上に成り立っているにもかかわらず、それぞれがまったく異なるものを指すことがあるので、どれが実際に何をしているのかを整理しておく価値があります。
うれしいことに、式そのものは決して変わりません。変わるのは、Q、K、Vがどこから来るのかと、計算がどう組み立てられているのかです。
セルフアテンション
- アテンションの重みは同じ系列の中だけで計算されます。
- Q、K、Vはすべて、パート1とまったく同じように、同じから射影されます。
- 現在の系列の外にある文脈は考慮されません。
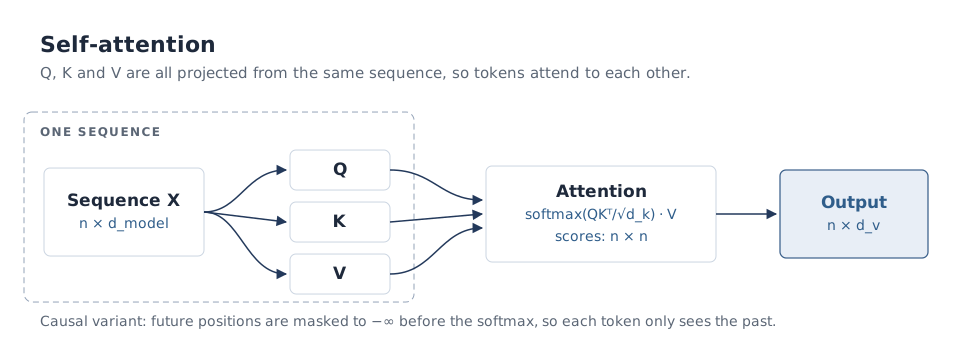
よく使われる派生形が、GPTのようなデコーダのみのモデルで使われる因果的(マスク付き)セルフアテンションです。モデルはテキストを左から右へ生成するので、トークンが未来を覗き見してはいけません。そこで、softmaxの前に対角線より上のスコアをに設定し、それらが0になるようにします。
           The    cat    sat    on
The       1.00     –      –      –
cat       0.30   0.70     –      –
sat       0.10   0.60   0.30     –
on        0.05   0.20   0.45   0.30
mask = torch.tril(torch.ones(n, n, dtype=torch.bool)) # lower-triangular [n, n]
scores = (Q @ K.T / math.sqrt(d_k)).masked_fill(~mask, float("-inf"))
A = scores.softmax(dim=-1) # zeros above the diagonalクロスアテンション
- アテンションの重みは異なる系列の間で計算されます。
- 最もよく使われるのはエンコーダ・デコーダ構成で、デコーダが次のトークンを生成するのに必要な情報を求めて、エンコーダの出力(KとV)に**クエリ(Q)**を投げかけます。
- 翻訳を思い浮かべてください。フランス語の文を書きながら、デコーダは英語の文を何度も「振り返って」見ています。
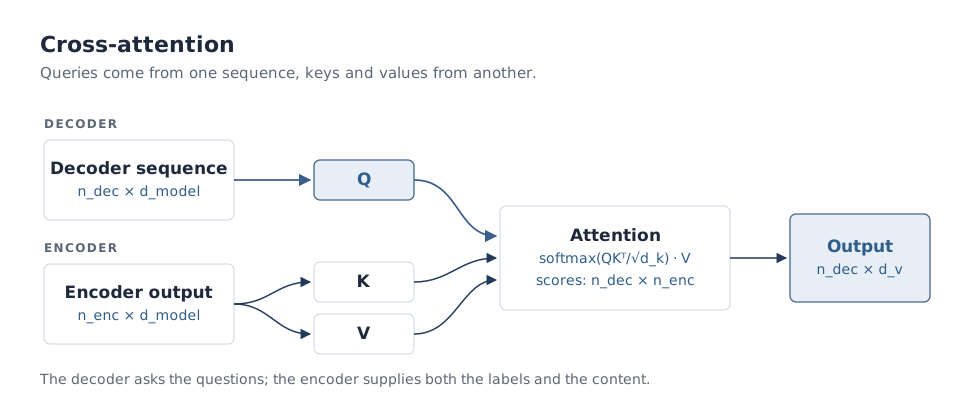
セルフアテンションとの実質的な違いは、各射影への入力だけです。ちょっと面白い副作用として、スコア行列はもう正方行列ではなくなります。デコーダのすべてのトークンがエンコーダのすべてのトークンに対してスコア付けされるので、になるのです。
def attention(Q, K, V, mask=None):
    scores = Q @ K.transpose(-2, -1) / math.sqrt(Q.size(-1))
    if mask is not None:
        scores = scores.masked_fill(~mask, float("-inf"))
    return scores.softmax(dim=-1) @ V

n_dec, n_enc = 3, 5
dec_x   = torch.randn(n_dec, d_model)  # [n_dec, d_model] what the decoder has so far
enc_out = torch.randn(n_enc, d_model)  # [n_enc, d_model] the encoder's output

Q = dec_x @ W_Q    # [n_dec, d_k]  questions come from the decoder
K = enc_out @ W_K  # [n_enc, d_k]  labels come from the encoder
V = enc_out @ W_V  # [n_enc, d_v]  content comes from the encoder

out = attention(Q, K, V)  # scores: [n_dec, n_enc] -> out: [n_dec, d_v]
マルチヘッドアテンション
私がしばらくつまずいていたのがここです。マルチヘッドアテンションは、セルフアテンションともクロスアテンションとも独立したものです。アーキテクチャの設計パターンであって、アテンションの範囲を指定するものではありません。マルチヘッドのセルフアテンションもあれば、マルチヘッドのクロスアテンションもあります。
考え方はこうです。全体に対して大きなアテンション計算を1回行う代わりに、それを個の小さなヘッドに分割します。各ヘッドはそれぞれ専用の、、を持ち、次元で計算します。各ヘッドが独立にアテンションを実行したら、その結果を連結し、もう1つの線形層で混ぜ合わせます。
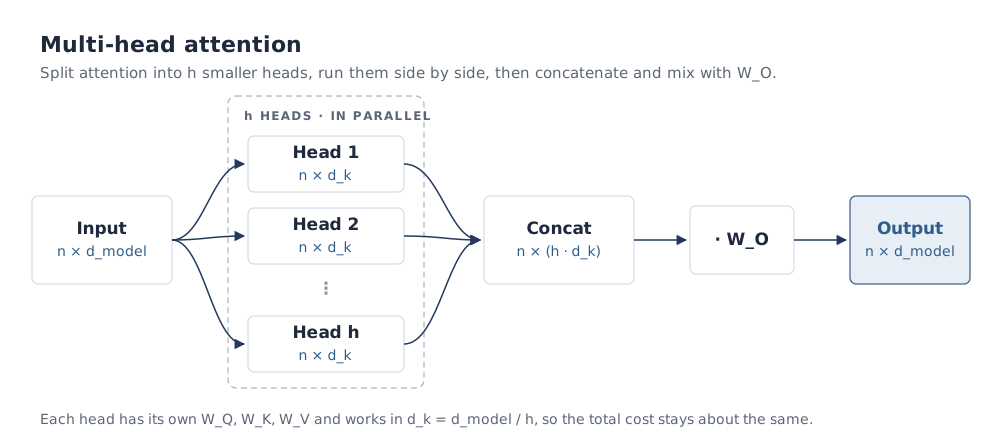
なぜわざわざそうするのでしょうか?私の理解では、主な利点は3つあります。
- 並列化による計算性能。 ヘッドどうしは互いに依存しないので、1つずつ順番にではなく、1回のバッチ行列積としてまとめて計算できます。しかも各ヘッドはより小さなで計算するので、全体のコストは、フルサイズのヘッド1つの場合とほぼ同じに収まります。
- 表現力の向上。 各ヘッドは、それぞれ異なる言語的特徴に注目するよう学習できます。あるヘッドは代名詞がどの名詞を指すかを追い、別のヘッドは隣接する単語に注目する、といった具合です。(実際には、ヘッドがいつもこれほどきれいに役割分担するとは限りませんが、そのための余分な表現力は備わっています。)
- 元の形状に戻すのが安上がり。 期待される形状に戻すには、特徴量の軸に沿って連結し、ヘッドをまとめる1つの線形層()を掛けるだけです。
最小限の実装は次のとおりです。私が気に入っているのは、「複数のヘッド」が、実はテンソルの次元が1つ増えただけにすぎないとわかるところです。
class MultiHeadAttention(torch.nn.Module):
    def __init__(self, d_model, n_heads):
        super().__init__()
        assert d_model % n_heads == 0
        self.h, self.d_k = n_heads, d_model // n_heads
        self.W_Q = torch.nn.Linear(d_model, d_model, bias=False)
        self.W_K = torch.nn.Linear(d_model, d_model, bias=False)
        self.W_V = torch.nn.Linear(d_model, d_model, bias=False)
        self.W_O = torch.nn.Linear(d_model, d_model, bias=False)  # combines the heads

    def split(self, t):                    # [n, d_model] -> [h, n, d_k]
        n = t.size(0)
        return t.view(n, self.h, self.d_k).transpose(0, 1)

    def forward(self, x_q, x_kv, mask=None):
        Q = self.split(self.W_Q(x_q))      # [h, n_q, d_k]
        K = self.split(self.W_K(x_kv))     # [h, n_kv, d_k]
        V = self.split(self.W_V(x_kv))     # [h, n_kv, d_k]

        heads = attention(Q, K, V, mask)   # [h, n_q, d_k]  all heads in one go

        n_q = x_q.size(0)
        concat = heads.transpose(0, 1).reshape(n_q, -1)  # [n_q, h * d_k] = [n_q, d_model]
        return self.W_O(concat)            # [n_q, d_model]

mha = MultiHeadAttention(d_model=8, n_heads=2)
mha(X, X).shape            # self-attention:  torch.Size([4, 8])
mha(dec_x, enc_out).shape # cross-attention: torch.Size([3, 8])同じモジュールで、セルフアテンションとクロスアテンションの両方をこなせます。違いはx_qとx_kvに何を渡すかだけで、まさにそこが要点です。マルチヘッドとは、アテンションをどう計算するかの話であって、何と何の間で計算するかの話ではありません。
実際の実装としては、PyTorchのソースにある量子化対応版のMultiheadAttentionが読む価値がありました。射影とヘッドの形状変換が素のPythonで書き下されているからです。
まとめ
専門用語を取り払えば、アテンションとは結局こういうことです。各トークンが探しているもの(Q)を、すべてのトークンが差し出しているもの(K)と比較し、その比較結果を重みに変え、その重みで全員の中身(V)を混ぜ合わせる。それ以外はすべて、この3つの行列がどこから来るのか、そして計算をどう分割するのかのバリエーションにすぎません。
| Qの出どころ | K、Vの出どころ | 用途 | |
|---|---|---|---|
| セルフアテンション | 系列 | 同じ系列 | 1つの系列内のトークンどうしを関連付ける |
| 因果的セルフアテンション | 系列 | 同じ系列(それより前のトークンのみ) | テキストを左から右へ生成する |
| クロスアテンション | デコーダ | エンコーダの出力 | 別の系列から文脈を取り込む |
| マルチヘッドアテンション | — | — | 上記のいずれかを個の並列ヘッドで実行する |
これが腑に落ちてからは、Transformerの残りの部分もずっと怖くなくなりました。
参考文献
- Attention Is All You Need(Vaswani et al., 2017):すべての始まりとなった論文です。この記事の内容はすべて3.2節で扱われています。
- Jay AlammarによるThe Illustrated Transformer:アーキテクチャ全体をとても視覚的に解説しています。
- Andrej KarpathyによるLet's build GPT: from scratch, in code, spelled out:因果的セルフアテンションとマルチヘッドアテンションを1行ずつ実装していきます。