
プライバシーについて: これはクライアントワークのケーススタディです。会社名、クライアント名、製品名、社内規格の名前は伏せ、クライアントの業種や時期も一般的な表現にとどめています。マニュアルの本文は載せず、図の中の例文は私が作ったものです。数字は、1冊のマニュアルの20ページ分のサンプルで数えた件数だけを使っています。
QUTの修士課程の冬休みを使って、日本のある開発会社で、技術マニュアル向けのAI校正ツールの開発に加わりました。クライアントは大手のメーカーで、マニュアルは1冊で数百ページあります。ツールは、日本語の誤り、用語の揺れ、社内の表記規格への適合を、ルールとLLMを組み合わせてチェックします。
このツールは、見逃さないことを優先して作られていました。そのぶん、指摘が多すぎます。私の仕事は大きく分けて2つでした。どの指摘が本物かを測って、ノイズを出どころで減らすこと。そして、指摘を1件ずつ確かめる人のための画面を作ることです。
関わったのは約5週間、週4日で、アジャイルの1スプリント分です。長い関わりではありません。なので、この記事群では成果の大きさではなく、短い期間の中で何をどう判断したかを書きます。
| 種類 | B2Bのクライアントワーク(開発会社のチームの一員として) |
| 対象 | 製品の技術マニュアル(日本語、1冊数百ページ) |
| チェック | 日本語校正、用語チェック、社内の表記規格への適合 |
| 仕組み | ルールとLLMを組み合わせたチェックエンジンと、Webの管理画面 |
| 期間 | 大学の冬休みの約5週間(週4日) |
| 進め方 | 小さな開発チーム。クライアントとの週次の定例は日本語 |
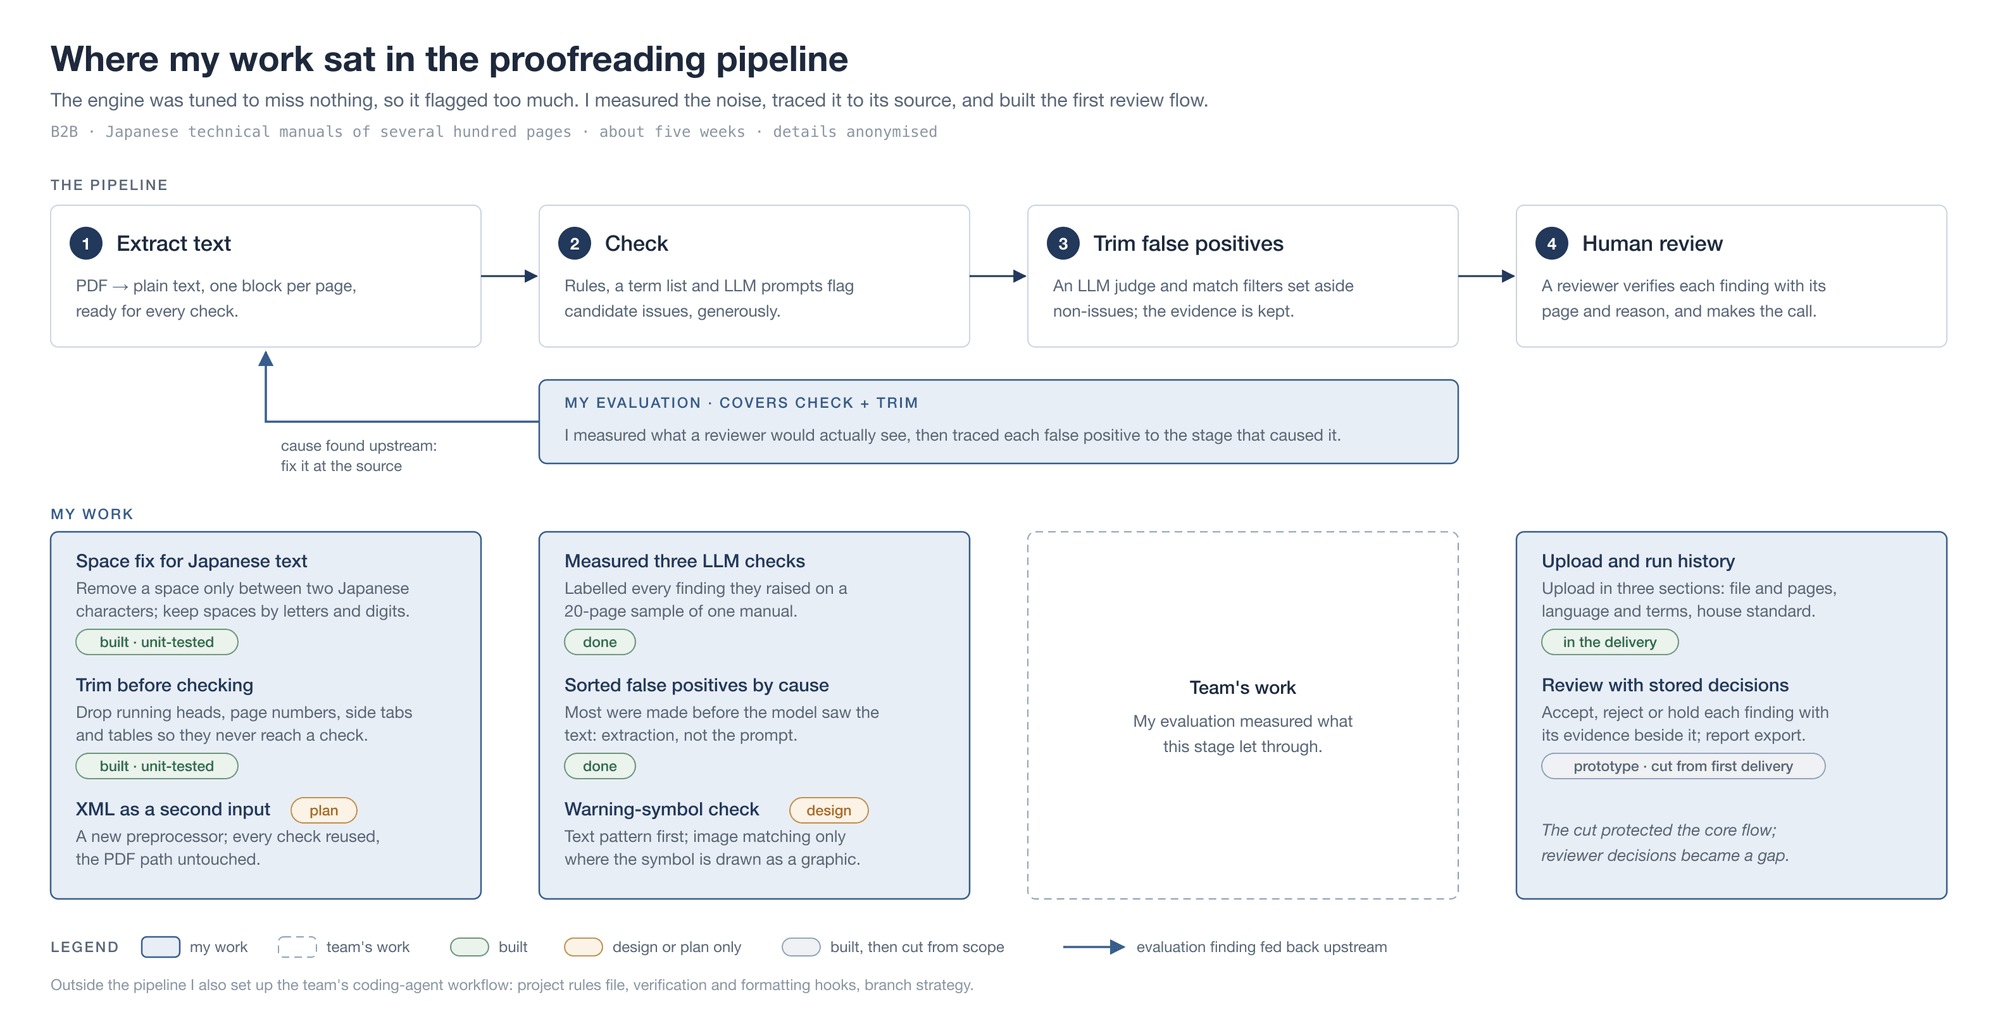
私がしたこと
- チームの開発の土台。 コーディングエージェント用のルールファイル、検証と整形のフック、ブランチ戦略、実装のロードマップを用意しました。
- 最初のレビュー画面。 アップロードからレビュー、レポート出力、実行履歴までの流れを作りました。レビューとレポートは、そのスプリントの納品からは外れています。
- 精度の評価。 3つのチェックを1冊のマニュアルの20ページで動かし、出てきた指摘すべてに自分で正誤を付けました。
- 誤検出の原因を出どころで直す。 誤字の指摘の多くがテキスト抽出の段階で生まれていることを突き止め、日本語向けのスペースの正規化を実装して、同じページで測り直しました。
- 前処理の改善。 ページ番号やヘッダーなどのトリムと、表と警告ブロックの除去を、ユニットテストとともに実装しました。
- 設計メモ。 警告記号の検出と、PDFに加えてXMLを入力にする方法について設計を書きました。どちらも私の在籍中には実装まで進んでいません。
記事
- 「再現率100%」は何も語っていなかった:LLM校正の誤検出を、モデルの手前で直す:精度の測り方と、誤検出の原因を辿って直した話です。
- 指摘しすぎるAIのためのレビュー:作って、外れて、残ったもの:指摘を確かめる画面と、動くスコープの中での判断の話です。
私が離れたのはプロジェクトの終わりではなく、1スプリントの区切りでした。クライアント社内での運用は数か月後に始まる予定と聞いていましたが、私が離れたあとの状況は分かりません。