
- ツール呼び出しをテキストとして書くモデル
- 15秒かかったURL
- 画像はモデルを通らない
- 1ターンの時間はどこに使われているか
- 会話の途中でツールサーバーが落ちたとき
- ネイティブのツール呼び出しを持つモデルを使うべきとき
- 今ならどう変えるか、そしてほかへの応用
Strobe Assistantの作り方を変えるきっかけになった返答は、写真1枚を見せるのに15.4秒かかりました。その裏の検索にかかったのは約0.5秒です。残りの時間は、モデルがURLを1トークンずつ打ち出すことに費やされていました。
Strobe Assistantは、ユーザー自身の写真ライブラリを対象にしたチャットエージェントです(システム全体はプロジェクトの概要にまとめています)。モデルはAmazon Bedrock上のGemma 3 12Bです。これは私が選んだというより、授業用のアカウントで有効になっていたチャット兼画像対応のモデルがそれだった、というのが実情です。本稿は、モデルが小さく、ネイティブのツール呼び出しを持たないときに何が変わるのか、そして結局モデルの中ではなくモデルの周りで行うことになった作業について書いたものです。
ツール呼び出しをテキストとして書くモデル
Bedrock上のGemma 3はtoolConfigを受け付けますが、toolUseブロックを返すことはありません。代わりに、ツール呼び出しのように見えるもの、つまりフェンスで囲んだtool_codeブロックを返答のテキストに書いて止まります。エージェントのループからはごく普通のend_turnに見えるので、ツールは実行されず、次のメッセージでモデルは取得してもいない写真を嬉々として説明していました。
修正では、ネイティブのツール呼び出しがやってくれることを自分で行いました。ツールの一覧と呼び出しの手順をシステムプロンプトに入れ、返答から呼び出しを解析して実行し、結果をテキストとして返すのです。ツール呼び出しの仕組みと、このプロンプトベースの方法についてはLLMはコードを実行できないで書いたので、ここでは繰り返しません。その記事で触れていないのは、これにかかったコストです:
- モデルを呼ぶたびに入力トークンが約600増える。 ツールの一覧と手順の分です。
- 1回の返答につきツール呼び出しは1つ。 ツールは1つずつ順番に実行され、ツールを呼び出しつつ回答も書き始めた返答は、呼び出しのところで切られます。ストリームのフィルターが、開きフェンス以降をすべて隠すからです。
- 学習された振る舞いではなく、ベストエフォート。 パーサーは、私が指示したJSON形式に加えて、Gemmaがよく書くPython風の呼び出しも受け付けます。それ以外はテキストとして扱われてターンが終わるので、推測でツールが実行されることはありません。
エージェントはモデルIDからモードを選びます。Gemmaならプロンプトモード、ClaudeやNovaのように対応しているモデルならネイティブモードです。モデルの切り替えは、Parameter Storeの値1つで済みます。
15秒かかったURL
ツールが動くようになると、次の問題は速度でした。get_imageはS3の署名付きURLを返します。バケット名、認証情報、署名からなる約1,200文字の文字列です。写真を表示するために、モデルはそのURLをMarkdownの画像記法の中にもう一度書き出す必要がありました。
これは、私が考えてもいなかった形で高くつきました。署名はランダムな文字列なので、トークナイザーがまとめられる単語がなく、数文字ごとに1トークンを消費します。写真1枚を見せる1つの返答で、出力トークンは1,266、かかった時間は15.4秒でした。出力は1トークンずつ生成されるので、返答の時間はおおよそ「書いたトークン数 ÷ デコード速度」で、ここでは毎秒約82トークンです。しかも脆い仕組みでした。1文字でも間違えれば署名が壊れますし、小さなモデルは本物のIDの周りにもっともらしいURLをでっち上げるのが得意です。
修正では、モデルに本物のURLを一切見せないことにしました:
- ツールの結果がモデルに届く前に、エージェントがその中のすべての
httpsURLを短い参照strobe://image/<imageId>に書き換え、本物のURLはそのターン用のマップに保持します。 - モデルは参照を書きます。かかるのは数トークンです。
- 返答がストリーミングされる間、フィルターはMarkdownのリンクを完成するまで保留し、既知の参照なら本物のURLに置き換え、知らないものはリンクのラベルに置き換えます。
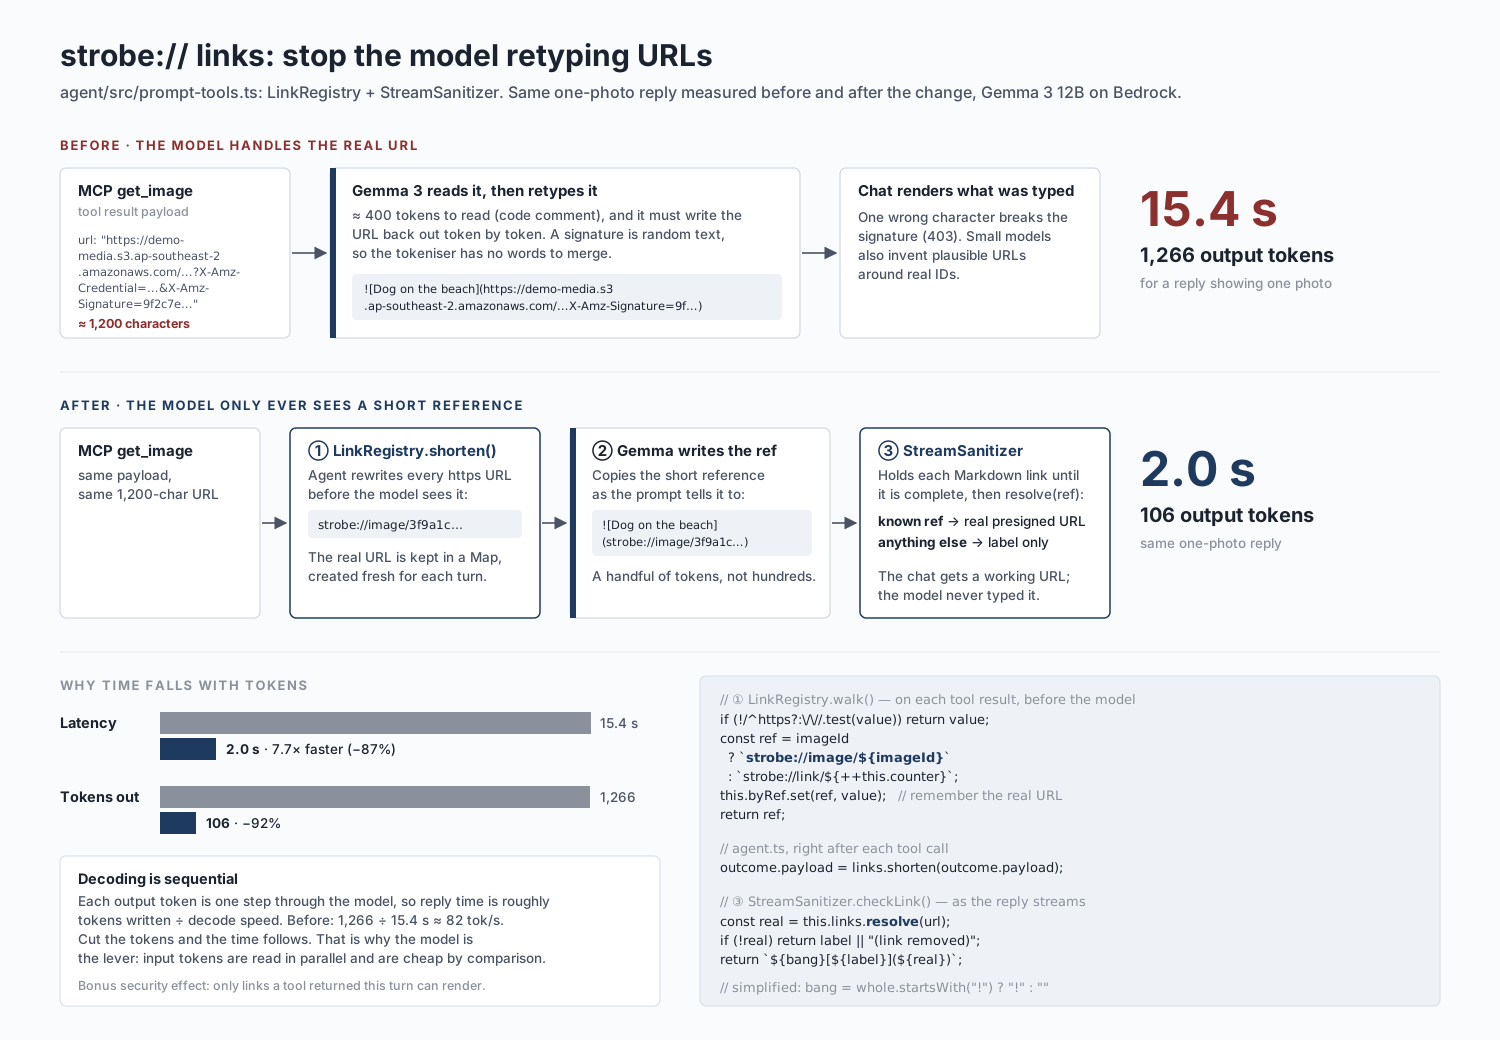
同じ返答は2.0秒、出力106トークンになりました。おまけとして、セキュリティ上の性質も手に入りました。返答に現れうるリンクは、そのターンでツールが返したものだけになったのです。モデルがでっち上げたリンクには解決先がないので、ユーザーにはただのテキストとして表示されます。
画像はモデルを通らない
大きくて中身の読めないデータをモデルから遠ざける、という同じ考え方を、画像についても双方向に適用しました。
画像で検索する場合。 find_similar_to_imageには、ユーザーが添付した写真が必要です。スマートフォンの写真をBase64にすると数メガバイトのテキストになり、それをモデルにツールの引数へ書き写させるのは、URLの問題を千倍にしたようなものです。そこで、このツールのスキーマにはモデルが埋める画像の引数がありません。モデルは何も渡さずにツールを呼び、エージェントがユーザーのメッセージからすでに持っている添付画像を差し込みます。
結果を見せる場合。 検索の後、エージェントは上位3枚の写真のサムネイルを自分で取得し、チャットの画像ブロックとしてユーザーに直接送ります。モデルが受け取るのは各写真のキャプションとラベル、そしてサムネイルを3枚表示したという注記だけなので、言及するだけでいい写真を見るために画像トークンを払うことはありません。以前のターンの画像のバイトも履歴の中でプレースホルダーに置き換えるので、毎ターン課金し直されることもありません。
ここから生まれたルールは、モデルは参照と判断を扱い、バイトはエージェントが運ぶ、というものです。
1ターンの時間はどこに使われているか
各ターンの合計時間を、モデルの時間、ツールの時間、エージェントのオーバーヘッドに分けて記録するテレメトリーを追加しました。計測した6回のチャットのターンでは、1ターンの平均は3.9秒で、モデルが2.3秒(57%)、ツールが1.6秒(43%)、エージェント自体はほぼゼロでした。実行ログにある12回のチャットのターンでは、中央値が3.4秒、95パーセンタイルが9.2秒です。
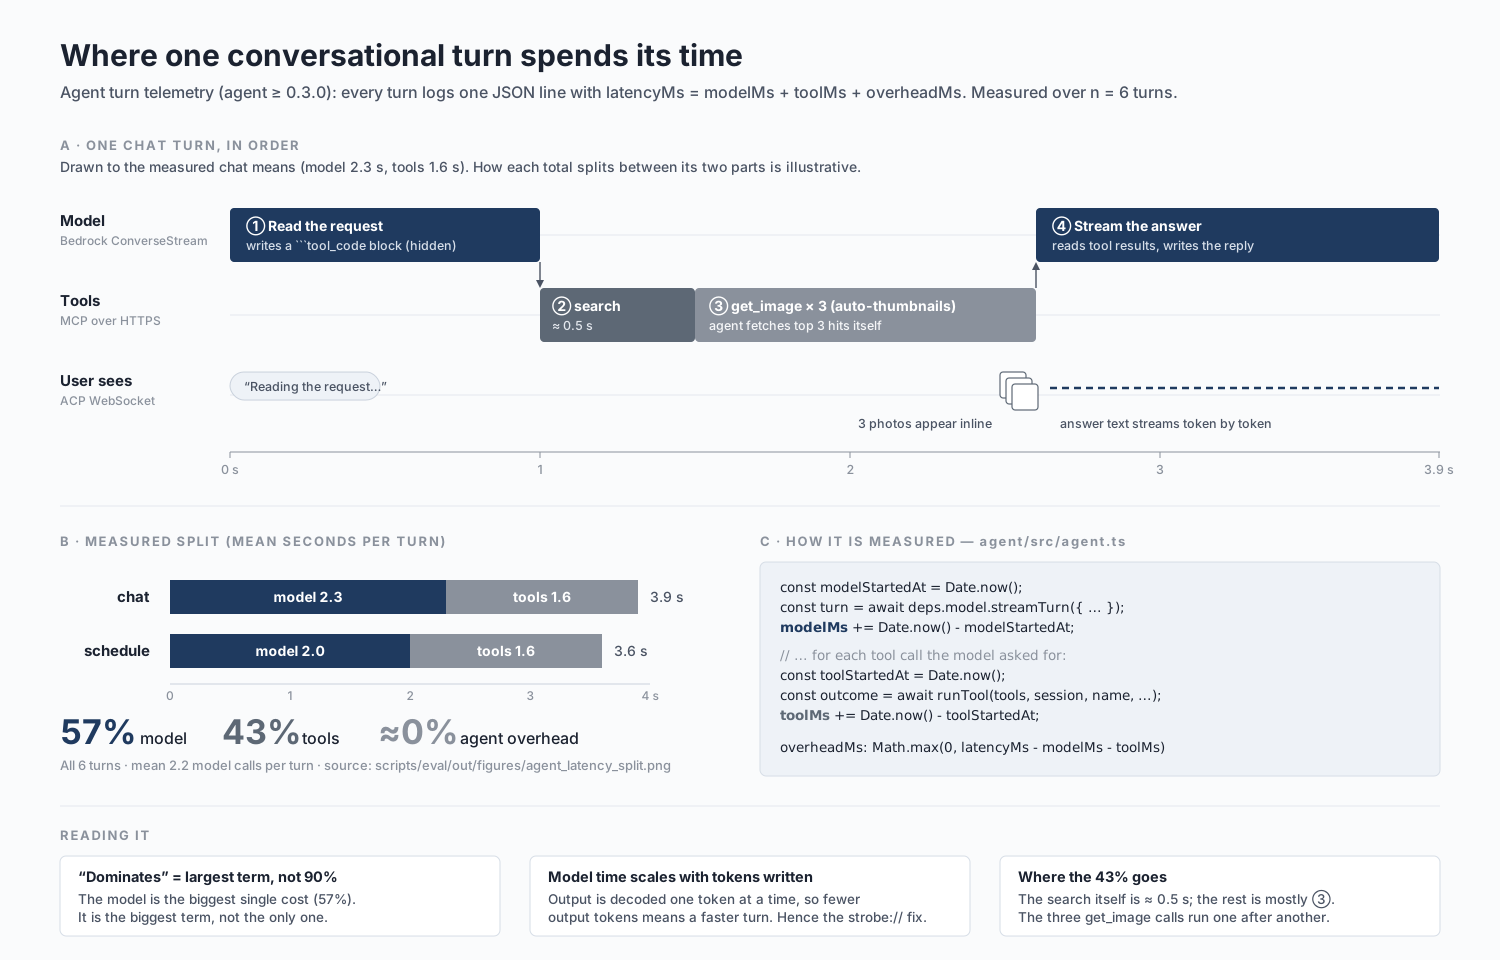
この内訳には驚いた点が2つありました。モデルは最大の要素ではあるものの、思っていたほどの差ではありませんでした。そして、2回の埋め込みと2回のベクトル検索を並行して行う検索そのものは、約0.5秒しかかかっていません。ツールの時間の大半は3枚のサムネイルの取得で、エージェントはそれを1枚ずつ順番に待っています。これを並行して実行することが、このシステムに残っている最も手軽な高速化です。
モデルの割合からは、URLの教訓が一般化できることもわかります。入力トークンは並列に処理されて安価ですが、出力トークンは1つずつ生成されます。時間がかかるのは、モデルが書かなければならない、長くて中身の読めないものです。
会話の途中でツールサーバーが落ちたとき
MCPサーバーの障害訓練を設計していて、障害そのものより悪い問題に気づきました。会話の途中でサーバーが再起動すると、最初のツール呼び出しが失敗します。それは問題ありません。ところが、サーバーが復帰した後も、その会話の以降の呼び出しがすべて失敗していました。エージェントが、接続の切れたクライアントを持ち続けていたからです。
今では、通信レベルの失敗(接続拒否、ソケットのクローズ、タイムアウト)があるとクライアントを壊れたものとして印を付け、エージェントは次のターンの最初に再接続します。サーバーが呼び出しを拒否した場合は、再接続しても意味がないので対象外です。会話の開始時にツールサーバーに到達できなければ、最初の返答は固まるのではなく、そう伝える明確な一文になります。モデルのスロットリングにも同じような扱いをしています。エージェントは1秒後、続いて3秒後に再試行しますが、それはまだ何もストリーミングしていない場合に限ります。ユーザーが回答の半分を見た後に再試行すると同じ内容を繰り返してしまうので、その場合は「モデルが混み合っています」と正直に伝えます。
ネイティブのツール呼び出しを持つモデルを使うべきとき
制約の下では、プロンプトモードは正しい選択でしたし、予備の手段として持っておくのも役に立ちます。それでも、自由に選べるならネイティブのツール呼び出しを持つモデルを使います。1回の返答で複数のツールを呼べ、1回の呼び出しにつき約600トークン少なく、隠すべきフェンスもありません。切り替えはパラメーター1つなので、書き直しではなく設定の変更で済みます。
どのモデルでも残したいのは、その周りで行っていることすべてです。URLの代わりに参照を使うこと、返答がリンクできる先にフィルターをかけること、バイトをモデルに通さないこと、そして再接続するクライアントです。どれも、Gemmaが小さいから存在するわけではありません。モデルにデータを正確に書き写すことを任せるべきではなく、またその必要もないから存在するのです。
今ならどう変えるか、そしてほかへの応用
- サムネイルを並行して取得する。 テキストの質問がたまたま写真に当たった場合は、取得自体を省きます。
- 投稿の抜粋をベクトルのメタデータに保存する。 検索のたびに元のAPIから取得していて、1回の検索につき約300ミリ秒かかっています。
- ツール呼び出しのモードを、テストされた組み合わせにする。 同じ会話のスクリプトを、プロンプトモードとネイティブモードの両方で実行します。
クライアントワークでは、私が関わる前にモデルが決まっていることがよくあります。データの所在地の要件や、承認済みベンダーの一覧、あるいはそのリージョンで使えるものによってです。そうなると、エンジニアリングはモデルの周りで行うことになります。何をモデルに入れ、何を書かせ、何に触れさせないかを決めるのです。これは、私が文書パイプラインで使っているのと同じ考え方です。モデルには短いIDでものを参照させ、それをモデルの外で解決します。