
プライバシーについて: これは技術マニュアル向けAI校正のケーススタディの1本目です。会社名と製品名は伏せ、数字は1冊のマニュアルの20ページ分のサンプルで数えた件数だけを使っています。
このプロジェクトで最初に任されたのは、精度を測ることでした。測ってみて分かったことは2つあります。測り方を決めないまま出した数字は、こちらを簡単にだますこと。そして、モデルのせいに見えた誤りの多くが、モデルがテキストを読む前に作られていたことです。
3つのチェックを、20ページで測る
対象は、チームが精度を上げたいと考えていた3つのチェックです。LLMによる誤字脱字の指摘、文字数で判定する長すぎる文の検出(書き換え案はLLMが出します)、LLMによる用語の表記ゆれの検出です。1冊のマニュアルの最初の20ページで動かし、出てきた指摘を1件ずつ元のPDFと突き合わせて、正誤を付けました。
| チェック | 指摘 | 正しかった指摘 |
|---|---|---|
| 誤字脱字 | 29 | 2 |
| 長すぎる文 | 46 | 23 |
| 表記ゆれ | 21 | 1 |
数字そのものより大事だったのは、この表を作る途中で決めなければならなかったことです。
測る前に決めておくべきだったこと
チェックごとに、測っているものが違う。 長すぎる文のチェックは、決まった文字数を超えたかどうかを機械的に判定しています。なので、このチェックの正誤が測っていたのはモデルではなく、PDFから文をどう切り出したかでした。表や目次がつながって1つの「文」になれば、それが誤検出として数えられます。このチェックでLLMが実際にしている仕事は書き換え案を出すことで、その評価は正誤ではなく、意味が保たれているか、読みやすくなったかで測るべきものです。表記ゆれも、語を1つずつ当てるのではなく語のグループを作るタスクなので、本来は数え方が違います。3つを同じ列の1枚のシートに並べると、この違いが見えなくなります。
再現率は、モデル自身の答えでは測れない。 正解のリストをモデルの指摘から作ると、リストに載る「本物の誤り」はすべてモデルが見つけたものになります。見逃しは常にゼロで、再現率は必ず100%です。実際、私たちのシートの見逃しの列はゼロのままでした。
見逃しを数えるには、モデルとは別に作った正解が要ります。人がページを読んで誤りを洗い出すか、性質の違う複数のシステムの結果を集めるかです。たとえば20ページに誤りが8件あり、モデルがそのうち3件を見つけたとします。正解がモデル自身の指摘なら、再現率は3/3で100%です。独立に作った正解なら3/8で38%になり、見逃した5件が初めて見えます。
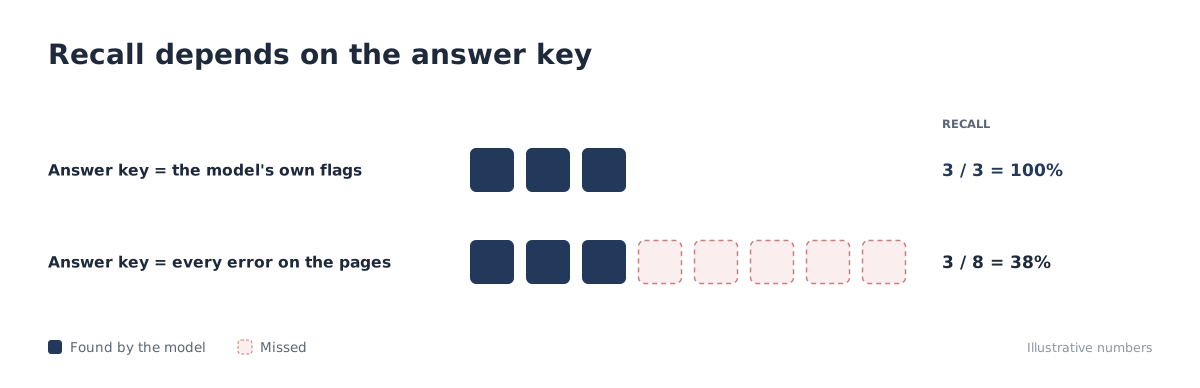
一方、指摘のうち何件が正しかったか(適合率)は、このやり方でも測れていました。測れていなかったのは再現率です。校正ツールにとって一番困るのは見逃しなので、これは見た目の問題ではありません。情報検索の分野では、複数のシステムの結果を集めて正解を作る方法(プーリング)でさえ、再現率は過大に見積もられがちだと指摘されています(Zobel, 1998)。1つのモデルの結果だけなら、なおさらです。
「1件」の数え方で、数字が動く。 同じページで同じ語が5回指摘されたら、5件と数えるのか、1件と数えるのか。誤字脱字のチェックでは「くださ い」が1ページに5回指摘されていて、数え方しだいで誤検出の数が変わります。このルールは誰も決めていませんでした。
もう1つ、自分でラベルを付ける前に、同じ指摘をLLMにも判定させていました。比べると、少なくとも5件で私の判断と分かれました。LLMに判定させる方法は、条件がそろえば人の判断とよく一致しますが、提示の順番や回答の長さに引っ張られる偏りもあり、人のラベルと照らし合わせて初めて信頼できるものです(Zheng et al., 2023)。照らし合わせた結果、このプロジェクトではLLMの判定は下書き以上には使えないと分かりました。ただし、私はLLMの判定を見たあとで自分のラベルを付けているので、それに引っ張られた可能性はあります。
誤検出を、原因で分ける
誤字脱字のチェックの29件(最初の実行で、私がラベルを付けたもの)を、原因ごとに分けました。
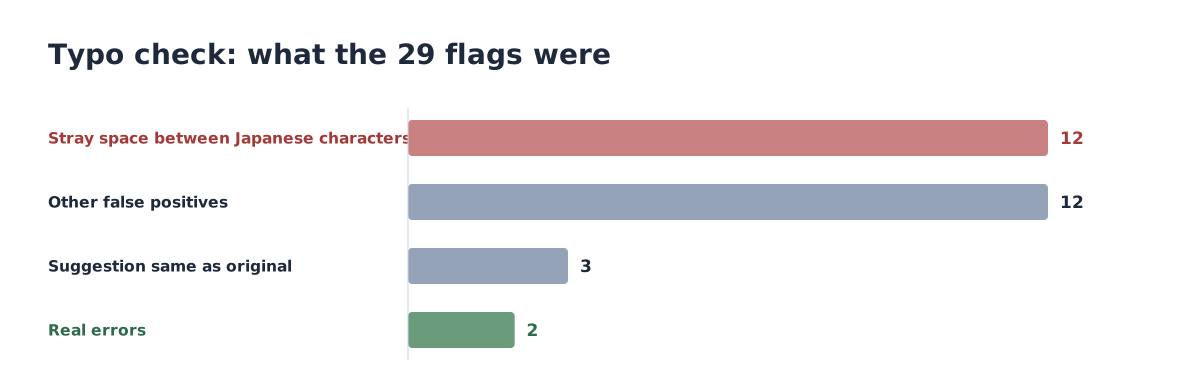
本物の誤りは2件だけでした。誤検出のうち3件は、修正案が元の文とまったく同じものです。「そのほか」の12件には、マニュアルの表記ルールを誤りとみなしたもの、言い換えにすぎない修正案、表の読み違いなどが含まれます。そして残りの12件は、日本語の単語の途中に入ったスペースを、モデルが誤字として指摘したものでした。「くださ い」や「デバ イス」のようなものです。実際のマニュアルに、そんなスペースはありません。誤りはモデルの手前で作られていたので、モデルやプロンプトをどう変えても根本的には直りません。チームでまとめたフィードバックでも、誤字脱字と表記ゆれの課題の1つに「データのノイズ(スペースの有無)による誤検出」が挙がり、対策は前処理の改善とされていました。
仮説を立てて、外す
最初の仮説は、PDFからテキストを取り出すライブラリがスペースを足している、というものでした。ライブラリにはスペースの挿入を抑えるオプションがあるので、それを有効にして同じページを取り出し直しました。出力は1バイトも変わりませんでした。
原因は私たちのコードにありました。ライブラリは、PDFの見た目の1行ごとにテキストを返します。私たちのコードは、その行をスペースでつないでいました。英語なら問題ありませんが、単語の間にスペースを置かない日本語では、行が折り返すたびに単語の途中にスペースが入ります。縦に並んだ見出しは、1文字ずつスペースで区切られていました。
消していいスペースだけを消す
スペースを全部消せば済むわけではありません。型番、単位、規格名のように、英数字のまわりのスペースには意味があります。そこで、スペースを消すのは前後が両方とも日本語の文字のときだけにして、英字や数字が隣にあるスペースは残しました。
数字と日本語の間のスペースも消す、もっと積極的な版も考えました。ただ、「図1 本体」のように、つながってはいけないものまでつながるおそれがあります。こちらは効果を測ってから入れるかどうかを決めることにして、外しておきました。結局、私の在籍中にその計測はしていません。
この処理には、消すべきスペースと残すべきスペースの両方についてユニットテストを書き、テキストを組み立てる処理の最後に入れました。
同じ20ページで測り直す
修正したあと、同じ20ページを同じモデル、同じ設定で動かし直しました。
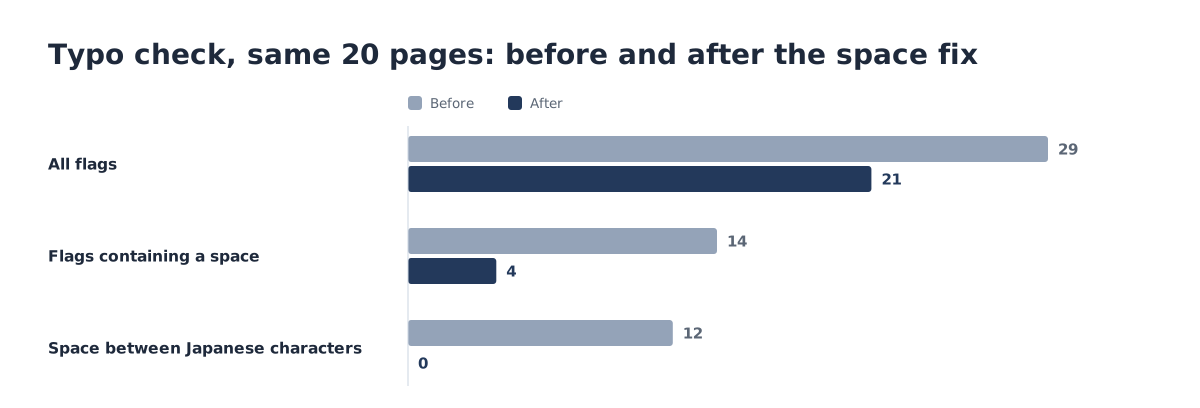
指摘は29件から21件に減り、日本語の文字の間のスペースを含む指摘は12件から0件になりました。スペースを含む指摘全体では14件から4件です。残った4件はどれも英数字の隣のスペースで、意図して残したものです。
ただし、これは件数であって精度ではありません。修正後の21件に、私はラベルを付けていません。それに、スペースが消えたことで別の種類の誤検出が見えてきました。見出しが何度もつながった長い文字列への指摘や、取り扱いの注意書きの「凍結しやすい」を「凍結しにくい」に変える、意味を逆にする修正案です。後者を見て、最後に人が確かめる工程はやはり外せないと思いました。
スプリントの終わりには、ページ番号やヘッダーなどを校正の前に取り除くトリムと、表と警告ブロックの除去も前処理に加えました。どちらもユニットテスト付きです。このときチームで確かめたのは、LLMのチェックの結果ではなく、前処理の出力そのものの修正前後でした。LLMの結果を見ると、原因が前処理なのかモデルなのかが混ざって分からなくなるからです。
もう一度やるなら
クライアントからは正解のラベルが出ておらず、「精度は上がっているのか」という問いには、スプリントの終わりまで答えられませんでした。次に同じような案件に入るなら、キックオフで次の3つを合意したいです。
- 何を1件の指摘とし、何を誤りに含めるかを書いた、1ページのラベル付けの基準
- 20ページほどのサンプルと、そこにある誤りを人がすべて書き出した正解のリスト
- その正解のリストを作る2人の担当者。それぞれが基準に沿って、モデルの出力を見ずに互いに独立してラベルを付け、食い違いは話し合って決めます
どれも大きな作業ではありません。それでも、これがないまま改善を重ねると、何かが良くなったのかどうかを誰も言えなくなります。
参考
- Zobel, J. (1998). How Reliable are the Results of Large-Scale Information Retrieval Experiments? SIGIR '98.
- Zheng, L. et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS 2023.