
エンコーダは何をするのか
簡単に言えば、エンコーダとは高次元の入力を受け取り、その次元を削減して、より低次元の表現を出力するニューラルネットワークです。やっていることは本質的には特徴抽出ですが、特徴を人の手で選ぶわけではありません。入力のどの側面を残す価値があるのかを、ネットワーク自身が学習します。オートエンコーダでは、エンコーダの出力を保持するボトルネック(つまり潜在空間)と、圧縮を元に戻そうとするデコーダが、エンコーダと組み合わされています。
どんなネットワークを使うかはデータによります。画像を入力とする場合、エンコーダはたいていただのCNN、つまり画像の幅と高さを段階的に縮めていく畳み込み層の積み重ねです。表形式のデータなら全結合層の積み重ね(MLP)が一般的で、系列データならRNNやTransformerが使われることもあります。
手書き数字で学習させた小さなCNNエンコーダの内部を見ると、次のようになっています(この記事の後半で構築するのと同じモデルです):
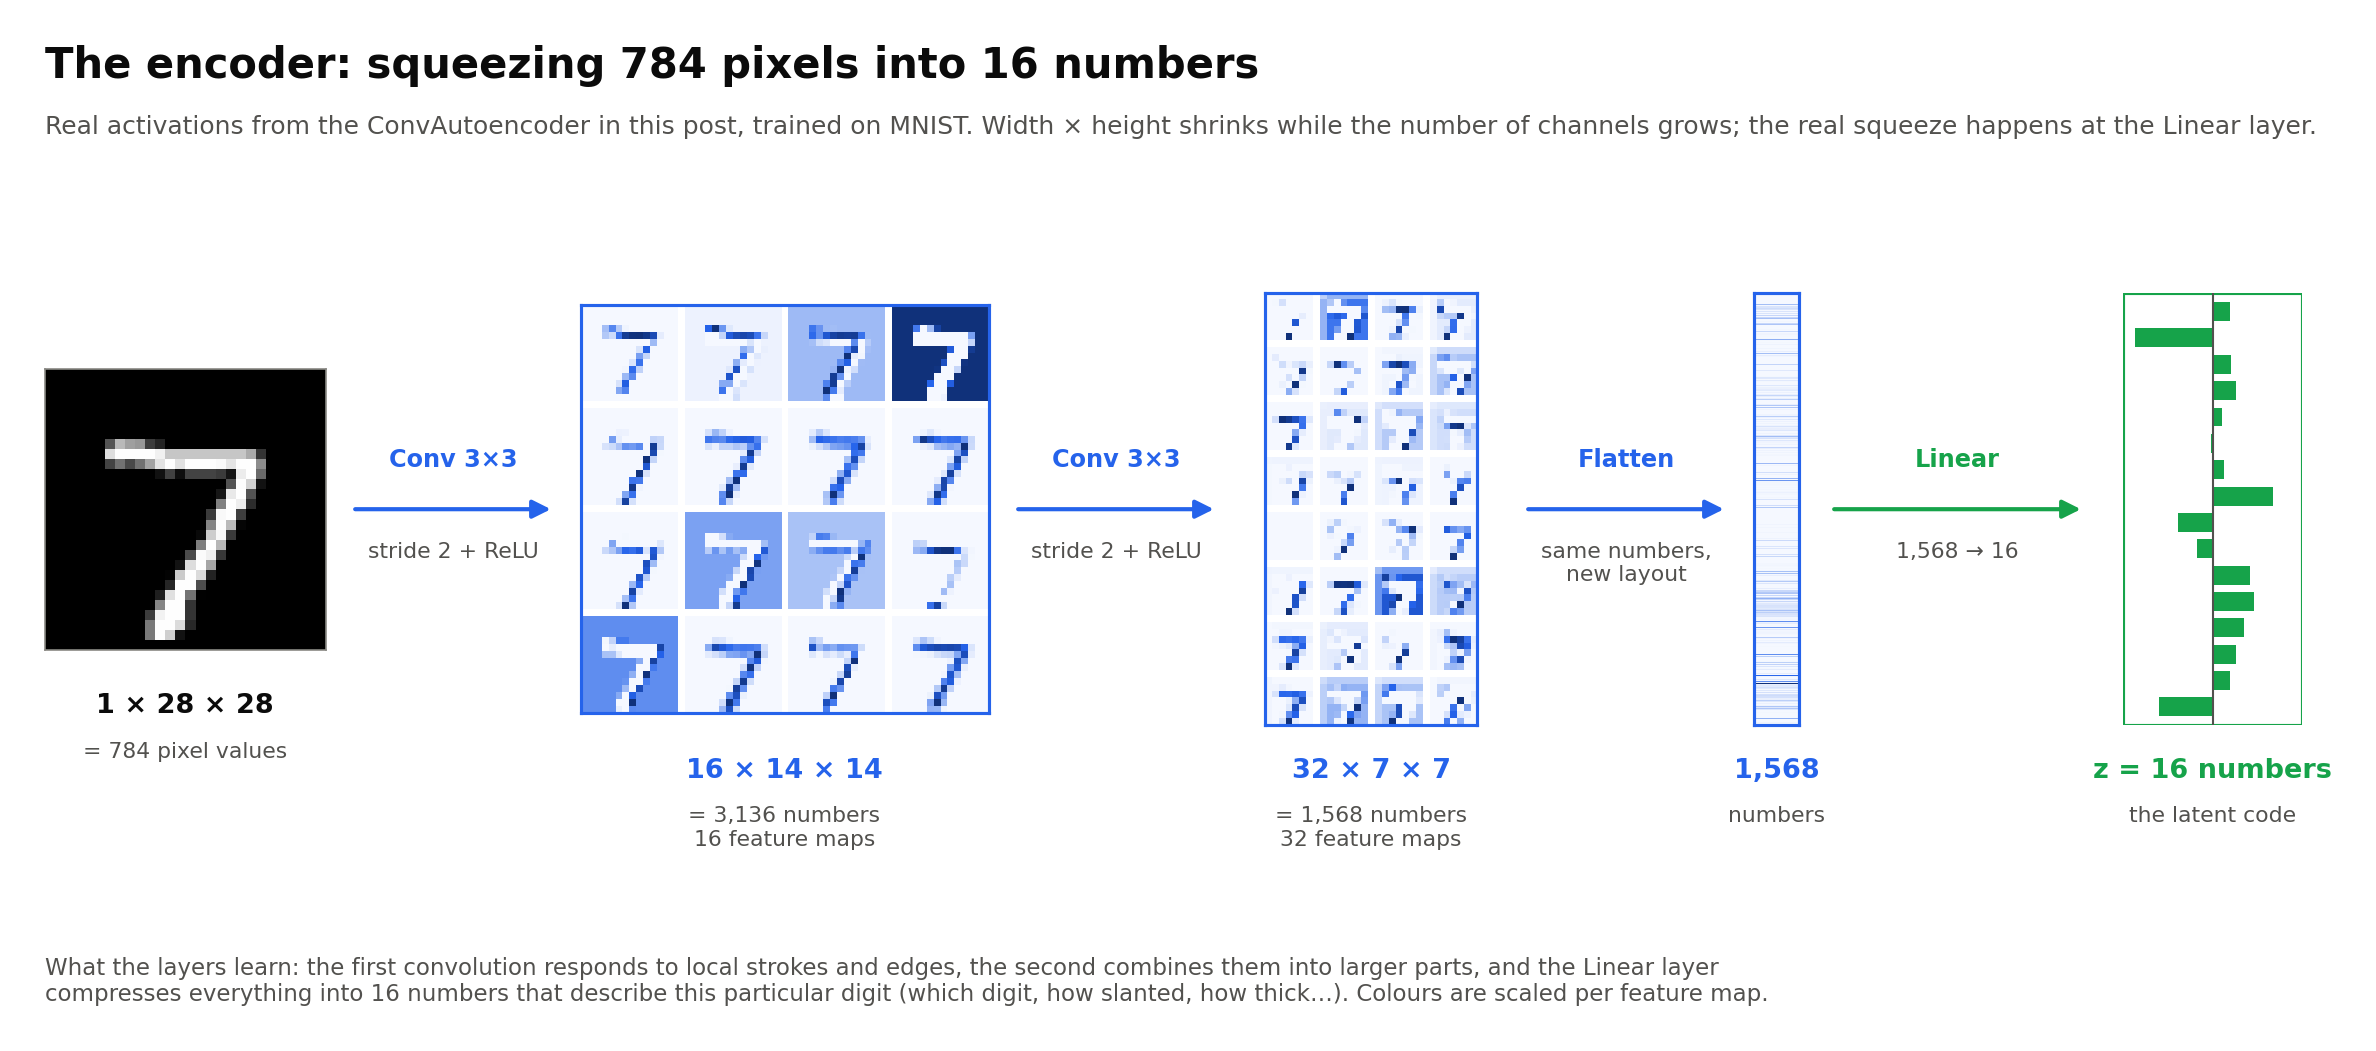
注目すべき点が1つあります。最初の畳み込みは、実は入力よりも 多くの 数値を生み出しています(784に対して3,136)。ストライド2の畳み込みはそれぞれ幅と高さを半分にしますが、同時にチャンネルを増やすため、各位置がより多くの特徴で表現されるようになるのです。本当の圧縮が起きるのは最後の最後で、Linear層が1,568個の数値すべてをわずか16個の潜在コードへと押し縮めます。
デコーダは何をするのか
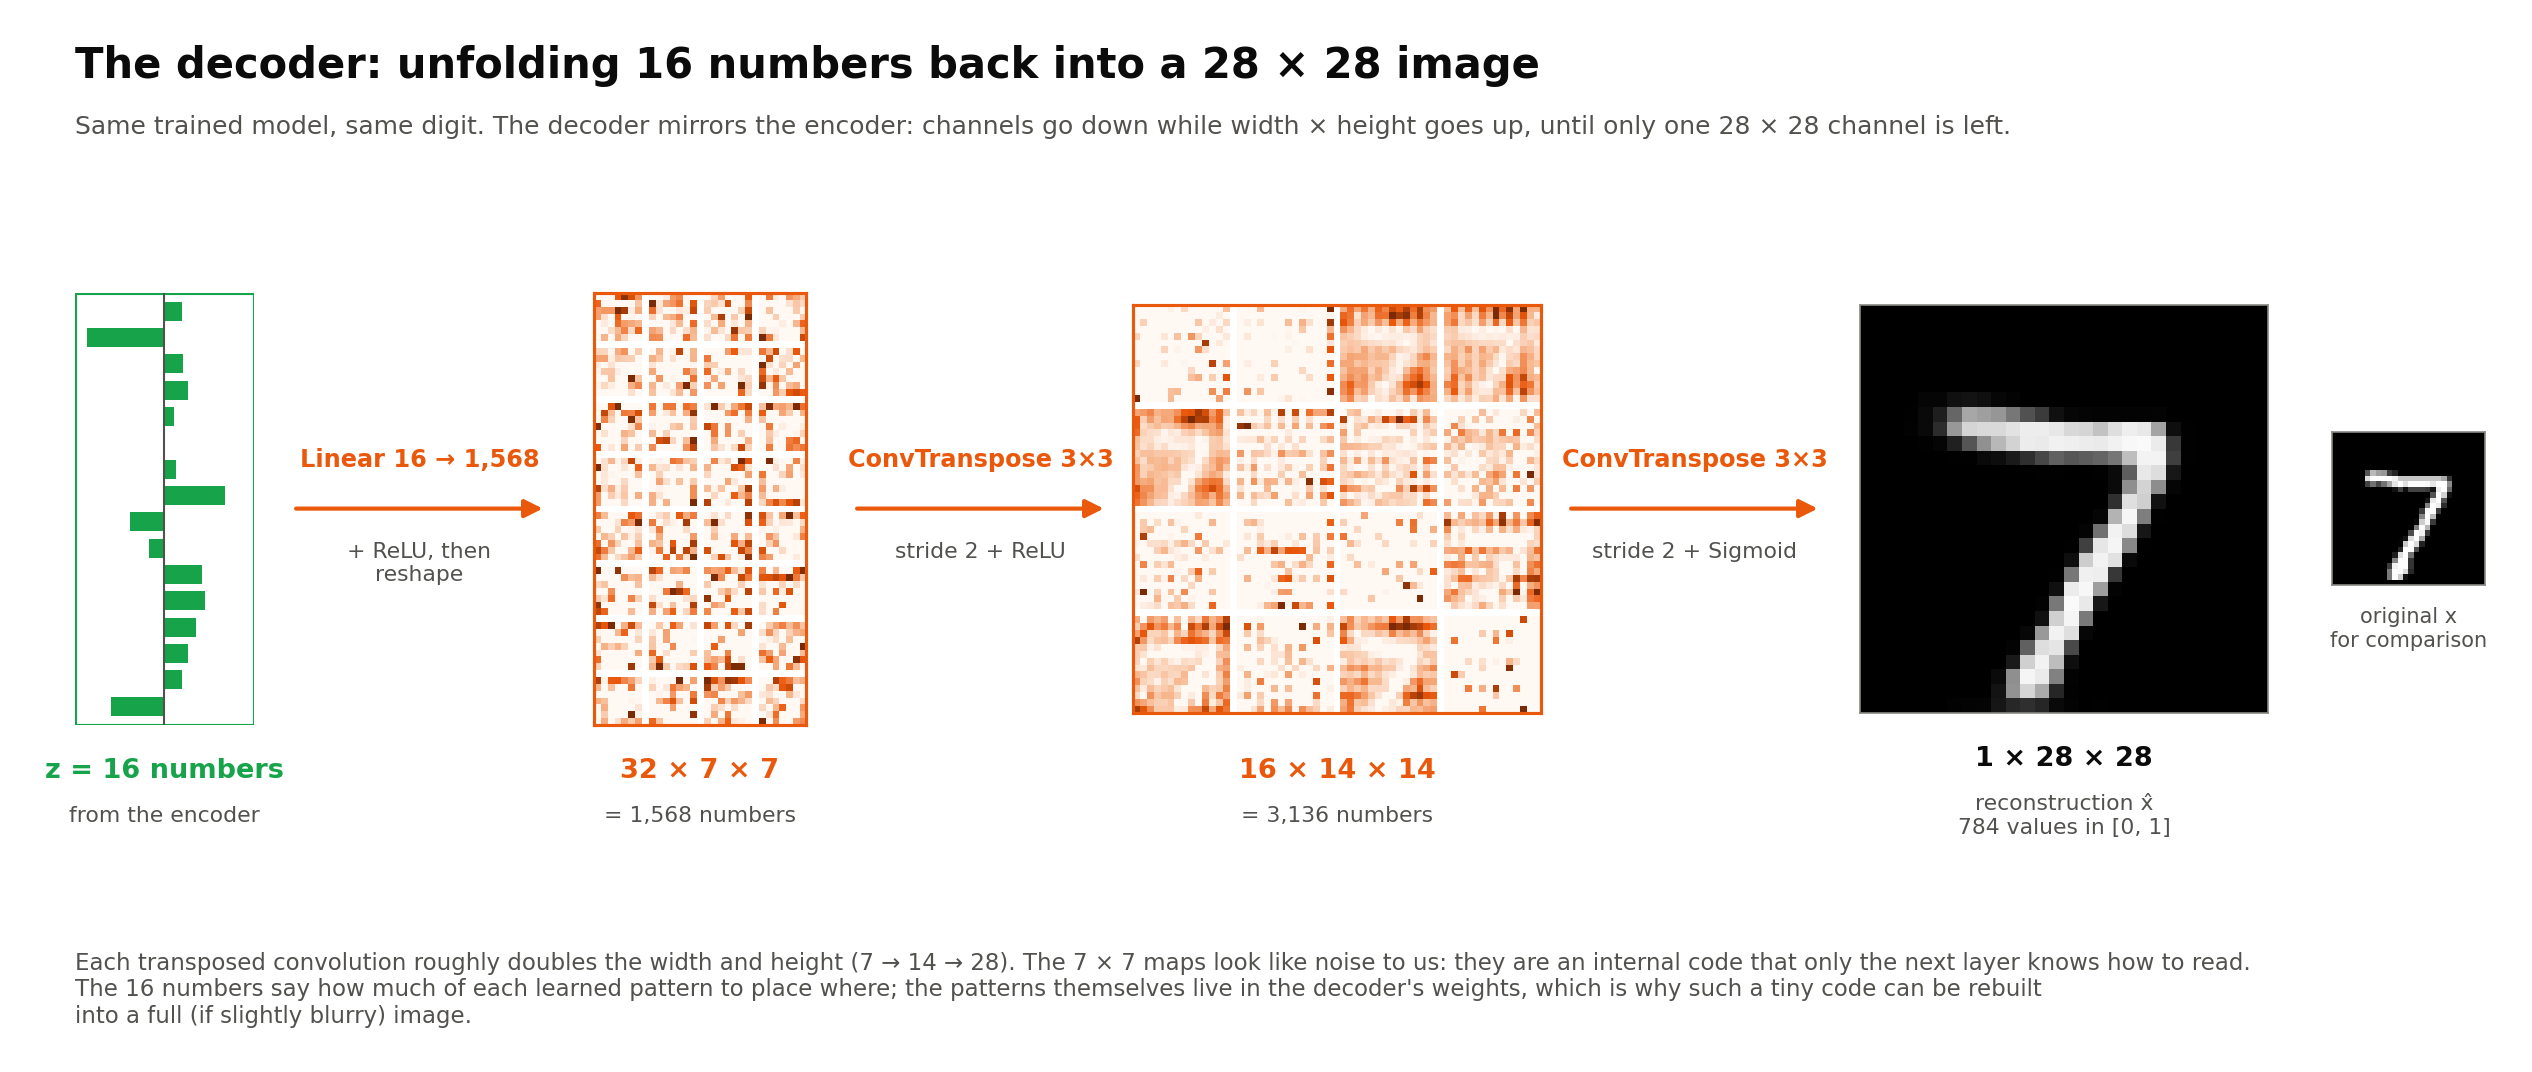
デコーダはエンコーダの鏡像です。低次元の潜在コードを受け取り、元の入力と同じ形のものへと展開し直します。画像の場合、これは通常、転置畳み込み(またはアップサンプリングの後に通常の畳み込み)によって空間解像度を段階的に大きくしていき、その一方でチャンネル数を減らしていって、最後に画像そのものだけが残るようにすることを意味します:
転置畳み込みはそれぞれ、スタンプのように働きます。小さな入力グリッドの各数値が学習済みのパターン(カーネル)を拡大縮小し、拡大縮小されたパターンがより大きな出力グリッドに貼り付けられていきます:
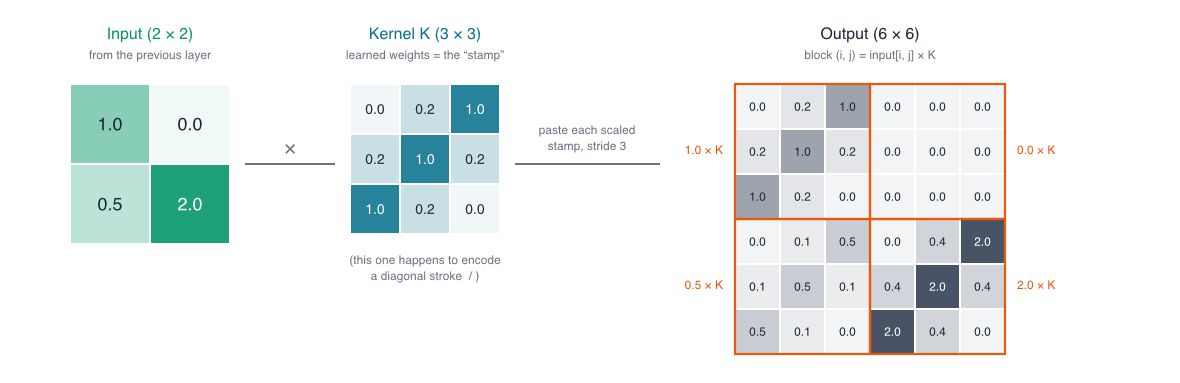
これは、これほど小さなコードから画像全体を復元できる理由でもあります。潜在コードが伝えているのは、各パターンを どこに どれだけ 置くかだけです。線や曲線がどう見えるかといったパターンそのものは、デコーダの重みに蓄えられています。
したがって、デコーダはそれ単体で 生成器 だと言えます。潜在コードを与えれば出力を生み出します。ただし、その出力が意味をなすかどうかは、コードがデコーダの学習対象となった潜在空間の領域から来ているかどうかに完全に左右されます(これについては後で詳しく説明します)。
「オート」が意味するもの
オート(auto) はギリシャ語で「自己」を意味する言葉に由来します。このネットワークは 自分自身の 入力を再現するように学習します。目標が入力そのものなのでラベルは必要なく、これは自己教師あり学習(しばしば大まかに教師なし学習とも呼ばれます)にあたります。このアーキテクチャは、ラベルのない入力を受け取り、パターンを見つけ出し、圧縮された特徴をすべて自力で出力するのです。
アーキテクチャ
オートエンコーダは、エンコーダとデコーダという2つのニューラルネットワークと、潜在コードを保持するボトルネック(潜在空間)から構成されています:
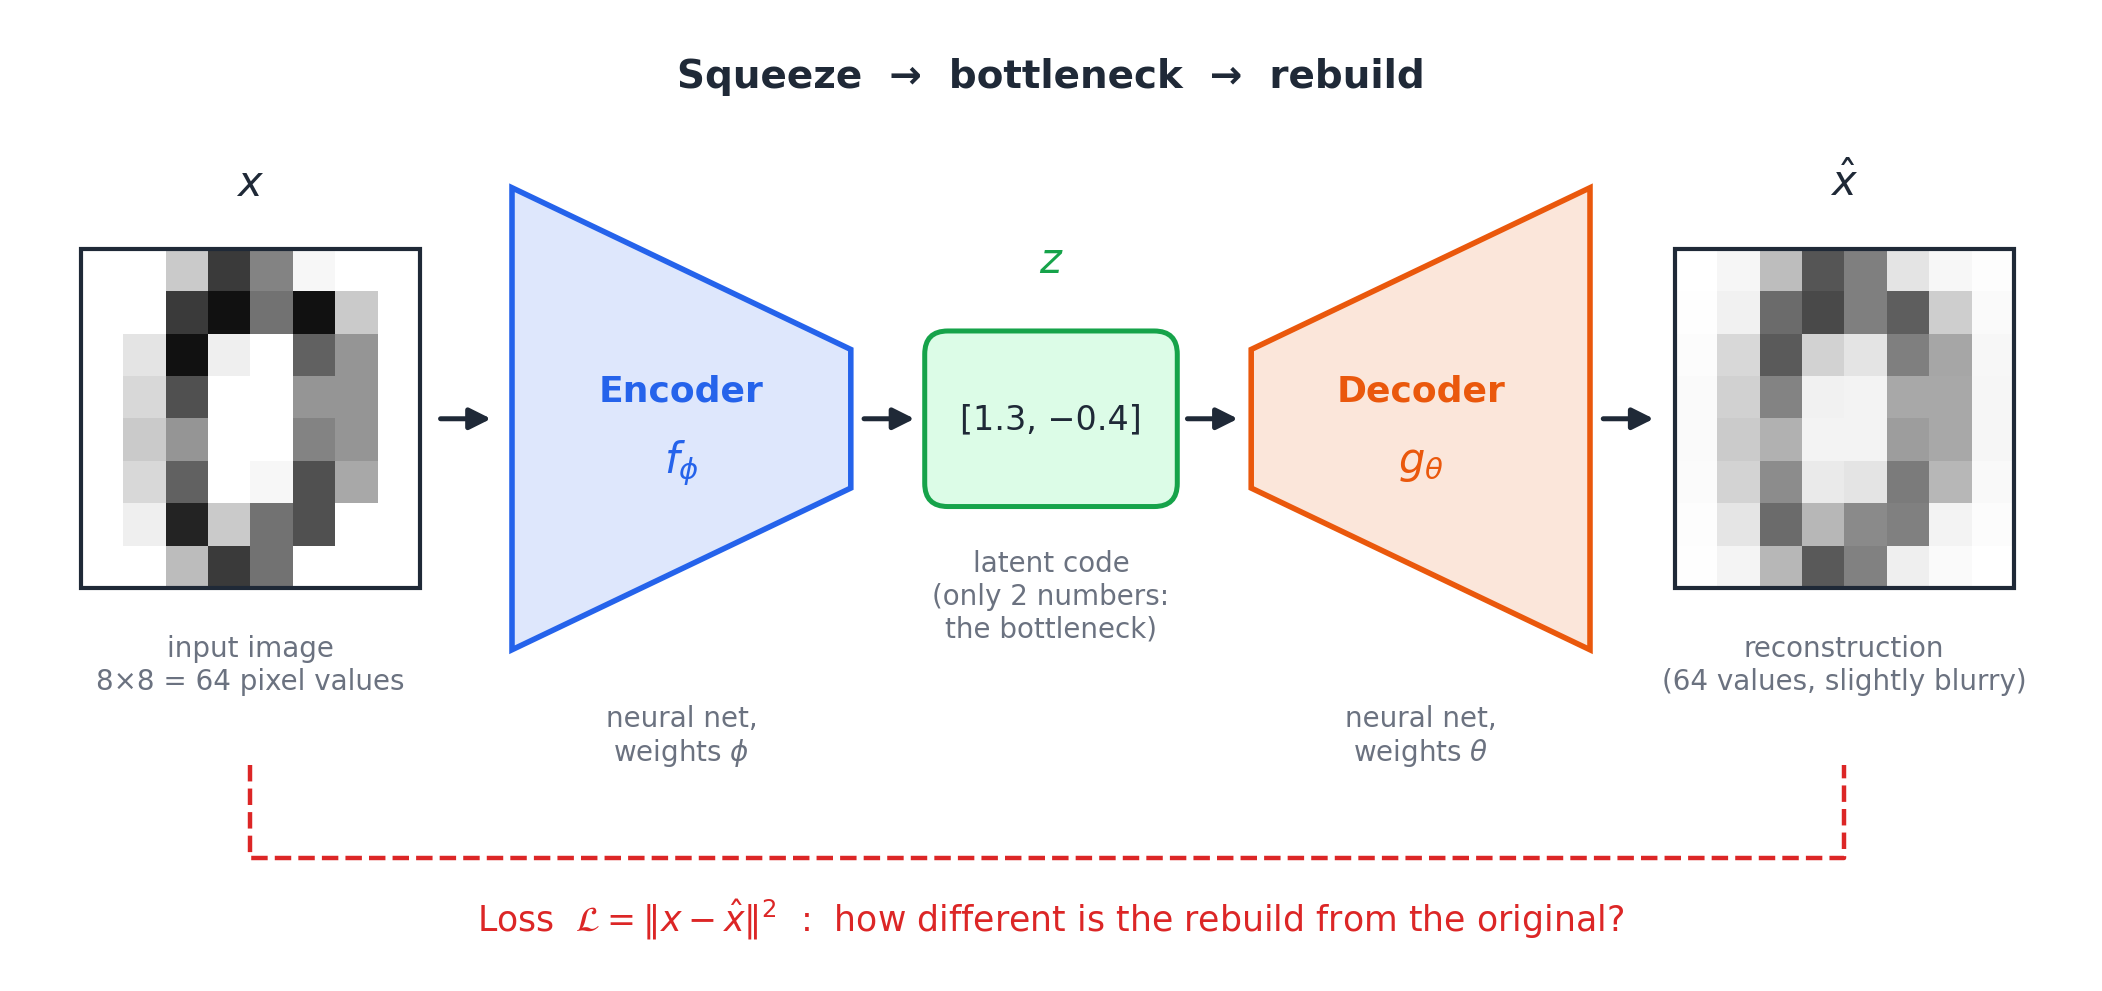
オートエンコーダは、次のように定義される再構成誤差を最小化することを目指します:
| 記号 | 名前 | 表しているもの |
|---|---|---|
| データ点 | 手書き数字の画像のような、実際の例1つ(上の図では8×8 = 64個のピクセル値、MNISTでは28×28 = 784個)。 | |
| エンコーダ | 重み を持ち、 を潜在コード に写すニューラルネットワーク。 | |
| 潜在コード | ボトルネックに置かれる圧縮された表現。図の例ではたった2つの数値 [1.3, −0.4]。決定的な1つの点であり、同じ からは常に同じ が得られる。 | |
| デコーダ | 重み を持ち、潜在コードを入力空間へと写し戻すニューラルネットワーク。 | |
| 再構成() | だけから を復元しようとするデコーダの試み。 と同じ形をしており、ボトルネックで情報の一部が失われるため、たいていは少しぼやけている。 | |
| L2ノルムの2乗 | と のピクセルごとの差の2乗和。ピクセル(とバッチ)について平均すると、おなじみの平均二乗誤差(MSE)になる。 |
実際には、損失は学習バッチについて平均され、勾配降下法で と を同時に更新しながら最小化されます。MSEが標準的な選択ですが、ピクセル値が にスケーリングされている場合はバイナリクロスエントロピーもよく使われます。
学習の様子
具体的に見るために、小さな畳み込みオートエンコーダをMNISTで学習させてみましょう。MNISTは、28×28ピクセルのグレースケールの手書き数字70,000枚からなる定番のデータセットです。エンコーダはストライド2の畳み込みを2回使って1×28×28から32×7×7にし、その後Linear層でそれを16個の数値からなる潜在コードに押し縮めます。デコーダは転置畳み込みでその各ステップを逆にたどります。これらは、上のエンコーダとデコーダの図に示した層そのものです:
import torch
from torch import nn
from torchvision import datasets, transforms

class ConvAutoencoder(nn.Module):
    def __init__(self, latent_dim=16):
        super().__init__()
        self.encoder = nn.Sequential(                             # f_φ
            nn.Conv2d(1, 16, 3, stride=2, padding=1), nn.ReLU(),  # 1×28×28 → 16×14×14
            nn.Conv2d(16, 32, 3, stride=2, padding=1), nn.ReLU(), # → 32×7×7
            nn.Flatten(),                                         # → 1,568
            nn.Linear(32 * 7 * 7, latent_dim),                    # → z (16)
        )
        self.decoder = nn.Sequential(                             # g_θ
            nn.Linear(latent_dim, 32 * 7 * 7), nn.ReLU(),         # z → 1,568
            nn.Unflatten(1, (32, 7, 7)),                          # → 32×7×7
            nn.ConvTranspose2d(32, 16, 3, stride=2, padding=1, output_padding=1), nn.ReLU(),  # → 16×14×14
            nn.ConvTranspose2d(16, 1, 3, stride=2, padding=1, output_padding=1), nn.Sigmoid(), # → 1×28×28
        )

    def forward(self, x):
        z = self.encoder(x)
        return self.decoder(z), z

train_loader = torch.utils.data.DataLoader(
    datasets.MNIST("data", train=True, download=True, transform=transforms.ToTensor()),
    batch_size=128, shuffle=True,
)
model = ConvAutoencoder()
optimiser = torch.optim.Adam(model.parameters(), lr=1e-3)

for epoch in range(10):
    for x, _ in train_loader:          # labels are ignored: that's the "auto"
        x_hat, _ = model(x)
        loss = nn.functional.mse_loss(x_hat, x)

        optimiser.zero_grad()
        loss.backward()
        optimiser.step()
損失に渡している目標が x そのものである点に注目してください。y はどこにも出てきません。最後の Sigmoid は出力の各ピクセルを の範囲、つまり ToTensor() を通した後の入力ピクセルと同じ範囲に収めます。
全体の学習は、2コアのCPUで1分半ほどで終わります。いくつかのテスト用の数字(モデルが学習には一度も使わないもの)の再構成を追っていくと、損失を最小化することが実際に何をもたらすのかがわかります:
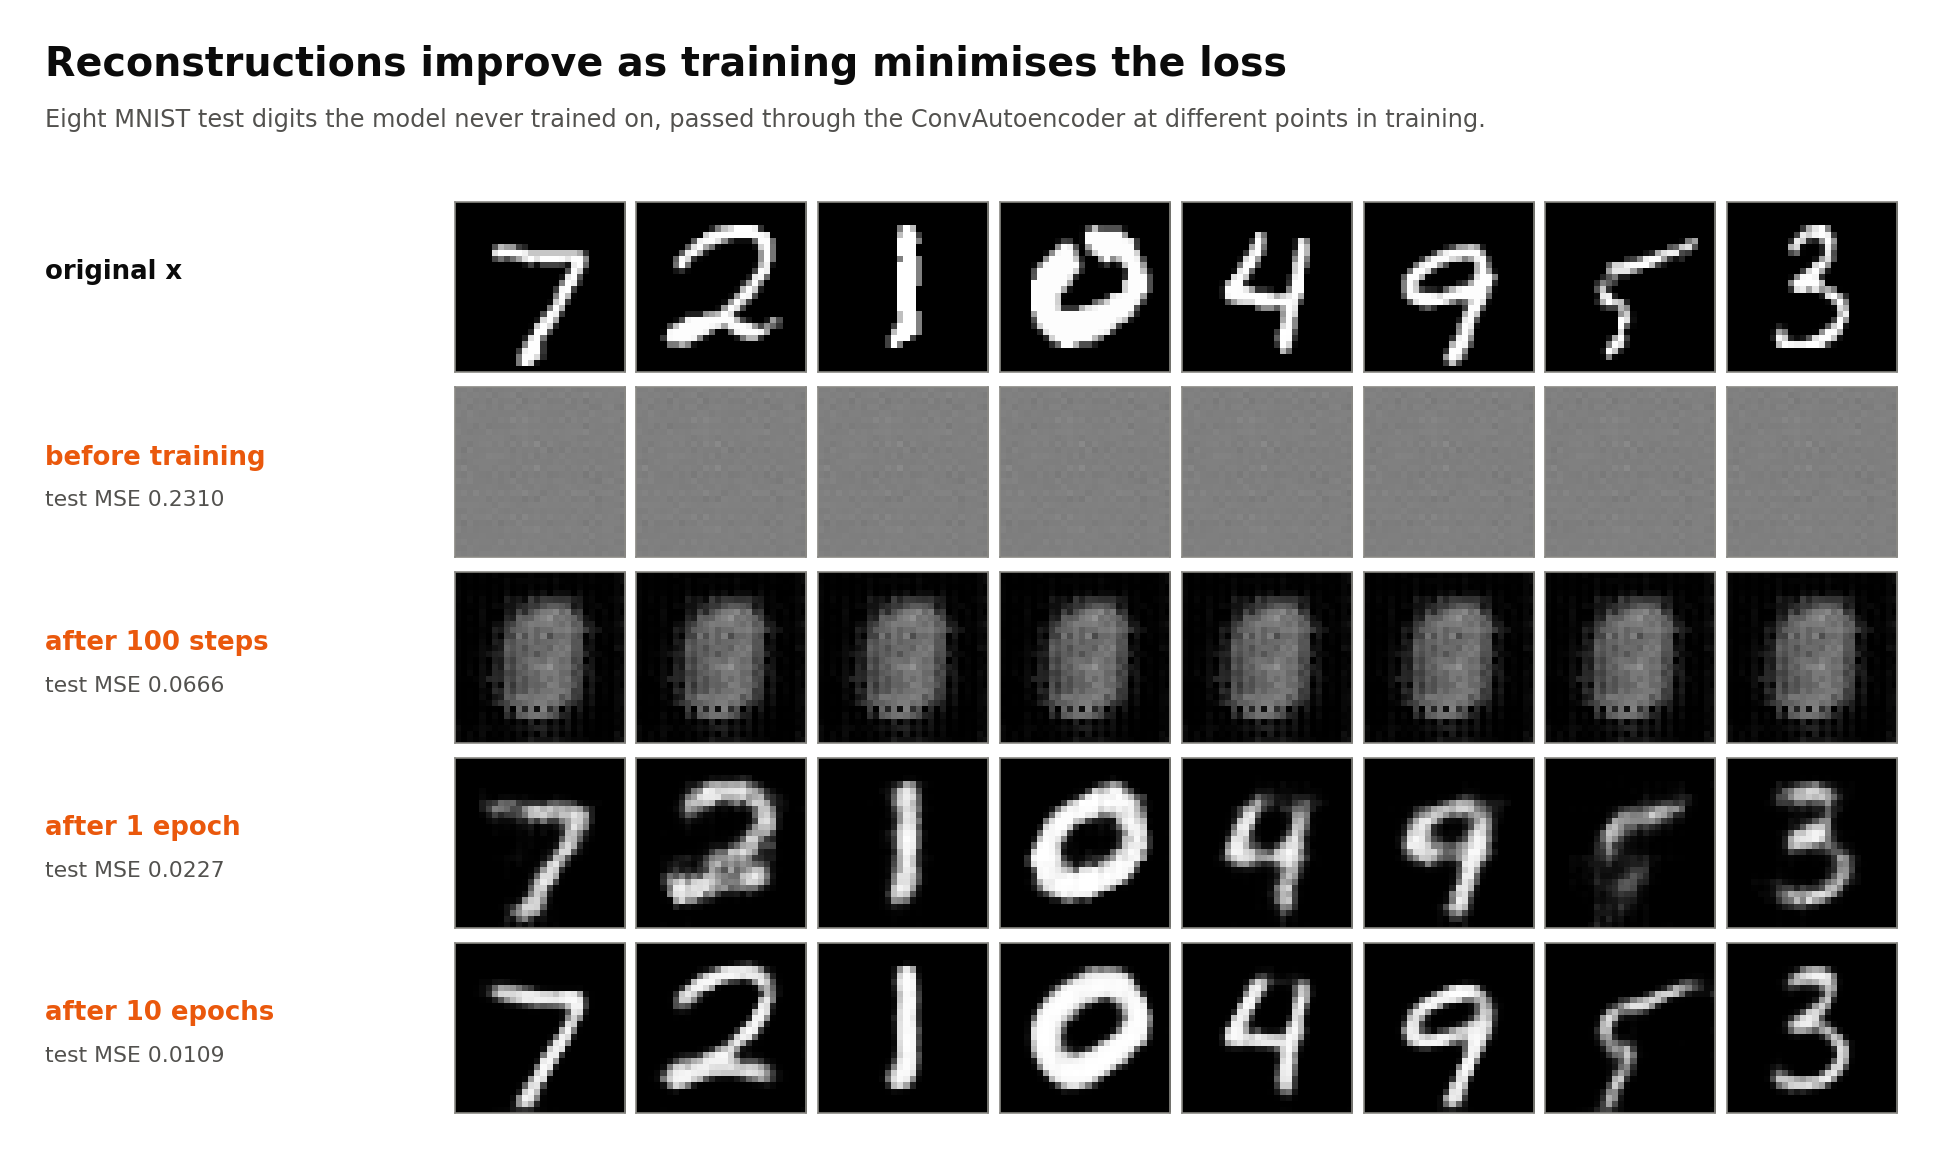
学習前は、まだ学習していないデコーダがどの入力にも同じ一様な灰色を出力します。100ステップ後には、使える中で最も手軽な手、つまり入力に関係なくぼやけた「平均的な数字」を出力することを覚えています。1エポック目が終わる頃には潜在コードが数字を区別できるだけの情報を持つようになり、10エポック後には再構成は元の画像に近く、わずかに柔らかい程度になります。5の長い上の横線のような細くて珍しい細部が最後まで再現されないことに注目してください。平均誤差への影響が最も小さいからです。
ボトルネックが重要な理由
ボトルネックがなければ、このタスクは自明なものになってしまいます。潜在空間が入力と同じ大きさのネットワークなら、入力を出力にそのままコピーすること(恒等関数)を学習するだけで、何も有用なことを学ばずに損失をゼロにできてしまいます。データを狭いボトルネックに通すよう強制する(不完備(undercomplete) なオートエンコーダ)ことで、ネットワークは何を残し何を捨てるかを決め なければならなく なり、データの大部分に共通する構造を捉えることでしか成功できなくなります。
したがって、ボトルネックの大きさはトレードオフです。小さすぎると再構成から重要な細部が失われ、非常にぼやけたものになります。大きすぎると、ネットワークは入力を丸暗記することに近づき、コードの意味が薄れていきます。入力よりも 大きな 潜在空間を使うこと(過完備(overcomplete) なオートエンコーダ)も可能ですが、その場合はノイズやペナルティ項など、ネットワークが単にコピーするのを防ぐ別の仕組みが必要になります(よく使われる派生形を参照)。
ここで参考になるのがPCA(主成分分析)です。エンコーダとデコーダが純粋に線形で、MSEで学習させる場合、オートエンコーダはPCAと同じ部分空間を学習します。オートエンコーダがPCAを超えて、データの中の曲がったより複雑な構造を捉えられるのは、非線形の活性化関数のおかげです。
再構成誤差という目的関数の問題
損失関数には再構成誤差の項しかありません。コードを潜在空間の どこに 置くべきか、どのように広げるべきかについては何も言っていないのです。実際には、似た入力は似たコードになるため、エンコーダは間に大きな空白を挟んだ別々のクラスタを形成しがちで、空間全体のスケールも任意になります。これは分類タスクには役立つかもしれませんが、生成タスクにとっては問題です。
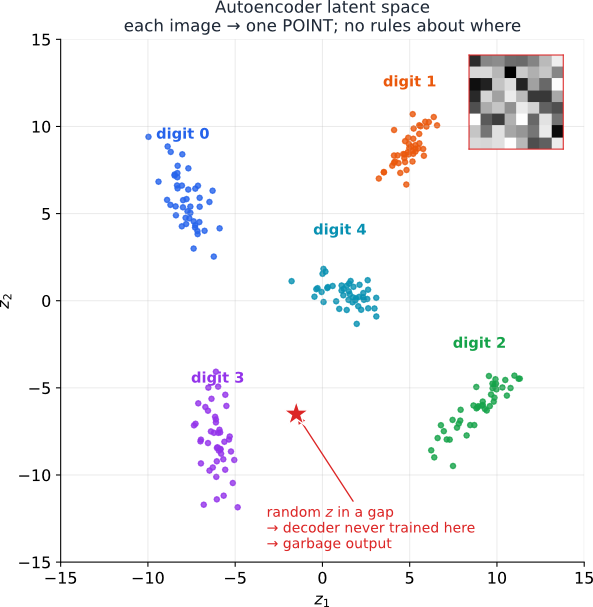
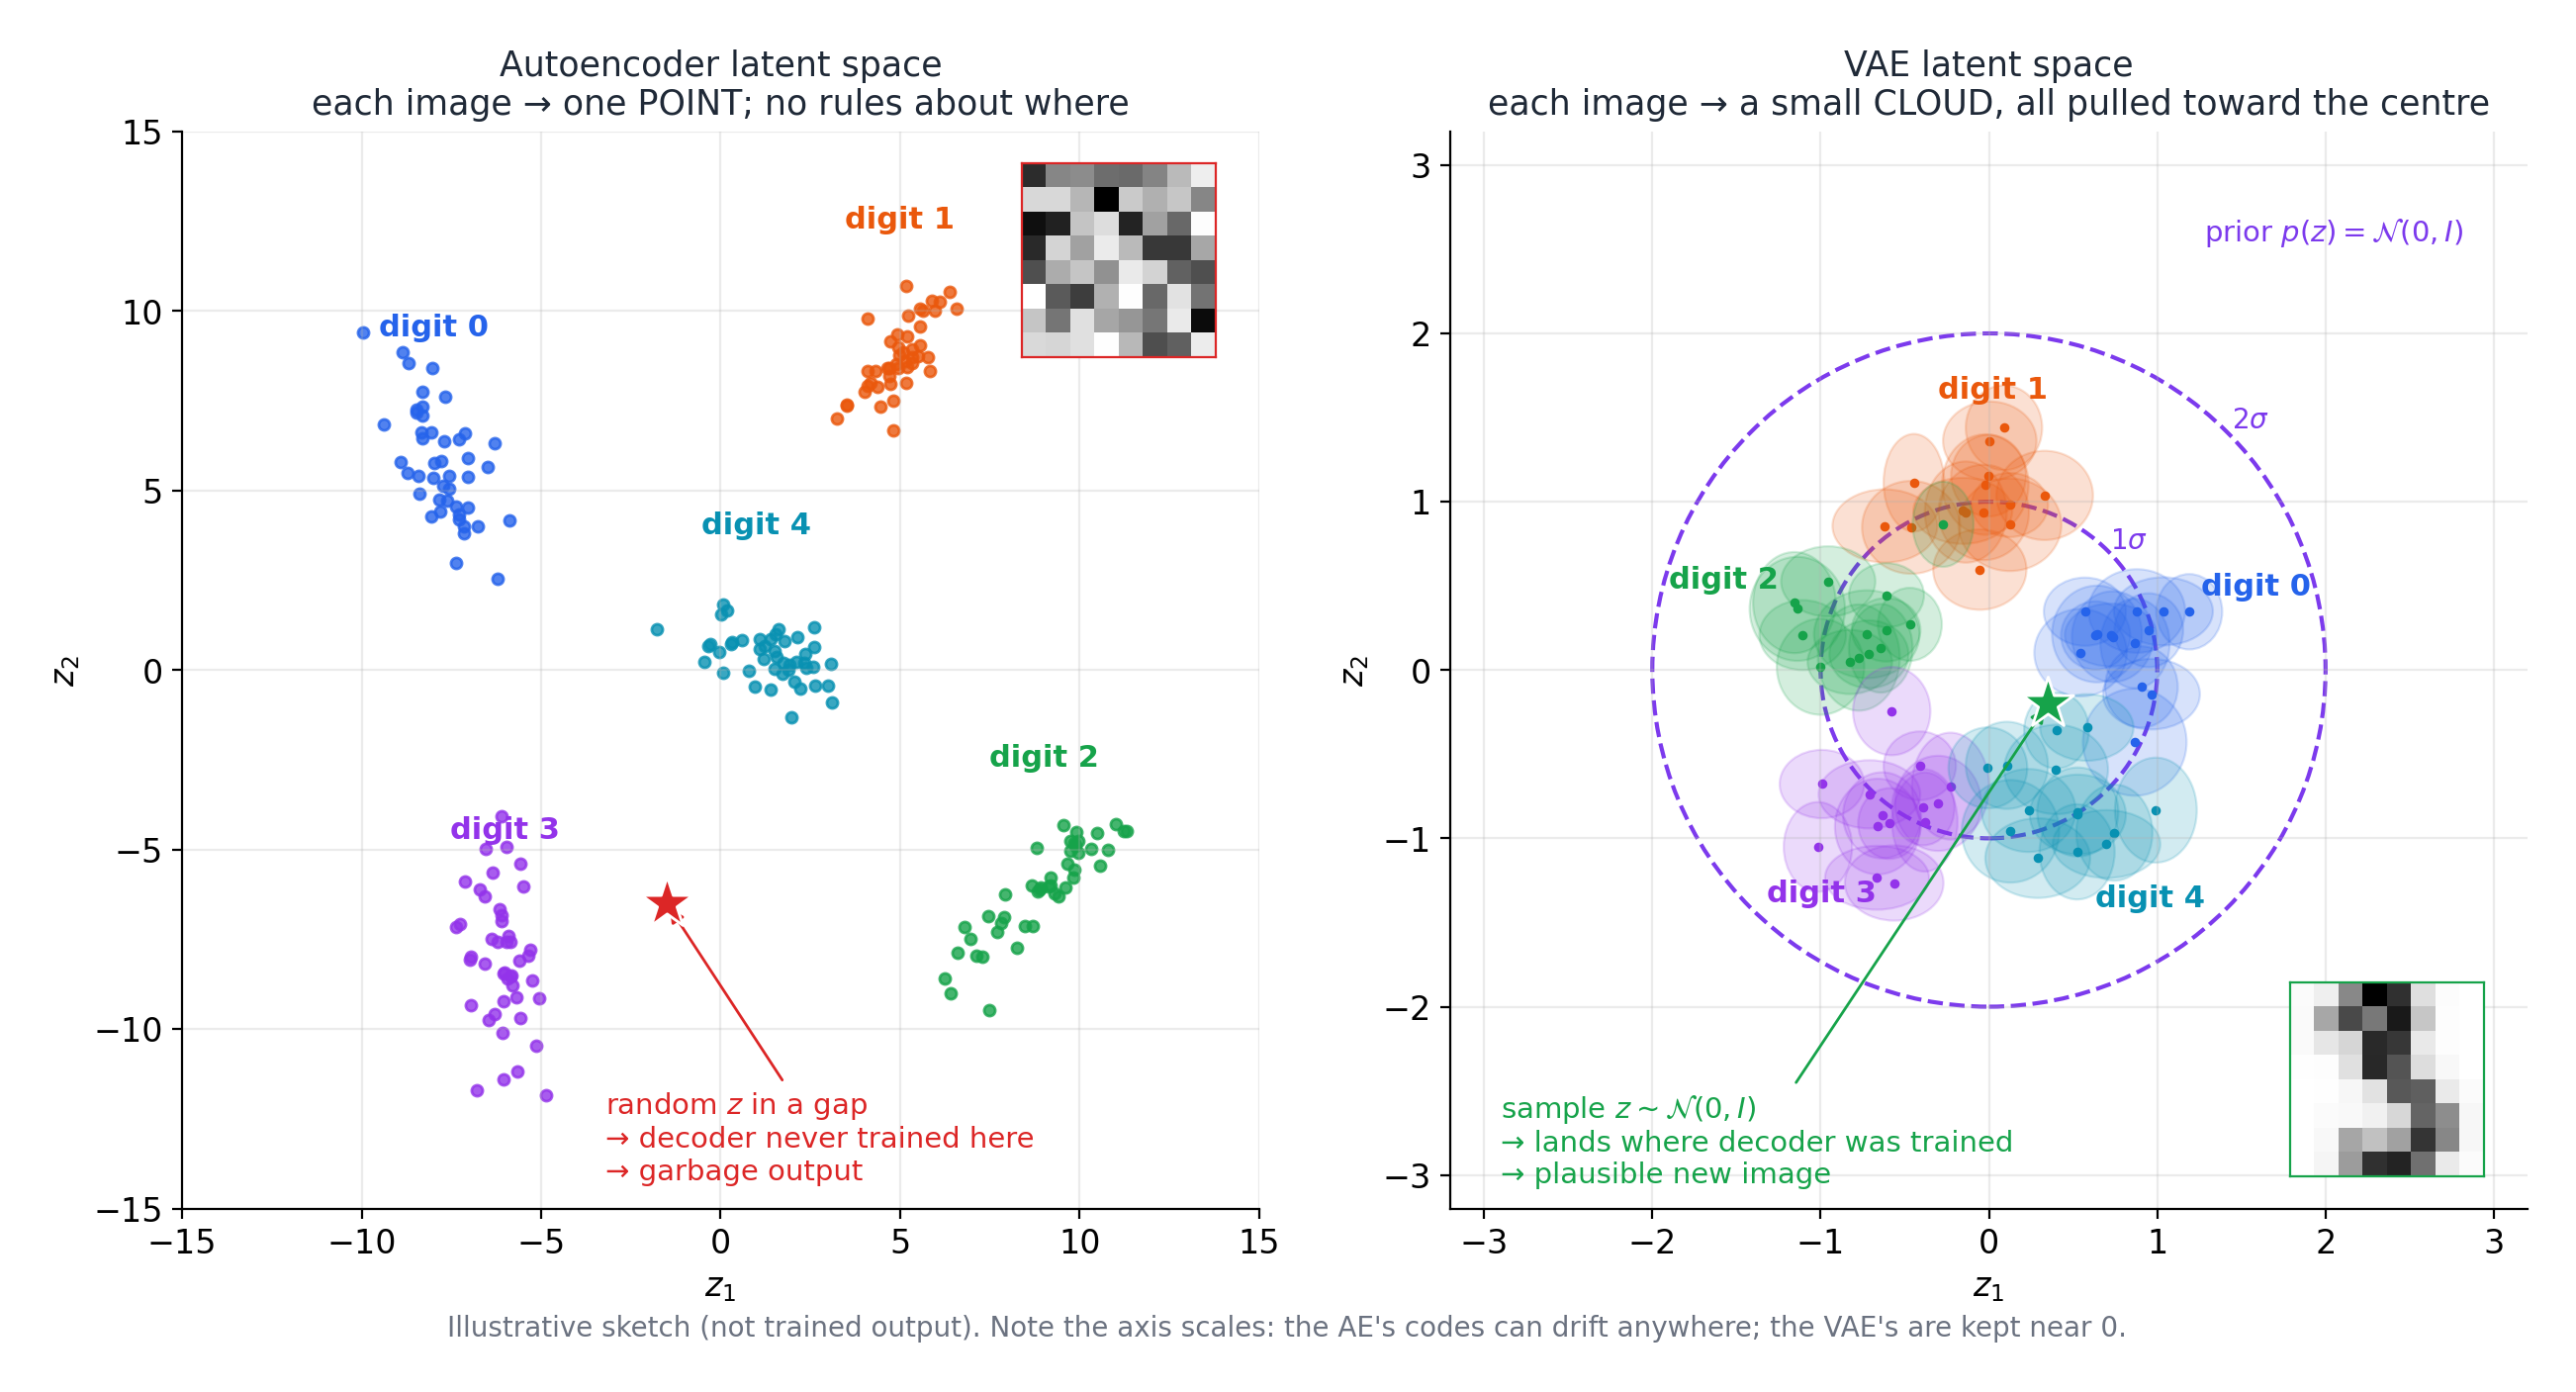
たまたまその空白のどこかに落ちる潜在コードを選んで新しい何かを生成しようとしても、デコーダはその領域のコードで一度も学習していないため、モデルは意味のある出力を生み出せません。補間をするときにも同じ問題が現れます。ある数字のコードから別の数字のコードへと直線的に移動すると空白を通過するため、途中の出力はしばしば数字として認識できないものになります。
これが、代わりにVAEを使う理由の1つです(変分オートエンコーダ(VAE)についての記事を参照)。VAEは潜在空間内の1つの点ではなく確率分布を出力し、それらの分布すべてを共通の事前分布(通常は標準ガウス分布)へと引き寄せます。これにより、空白が少なく、より滑らかで隙間なく埋まった潜在空間が生まれ、より一貫した生成につながります:
よく使われる派生形
素のオートエンコーダは、モデルの一大ファミリーの出発点です。ほとんどの派生形は、エンコーダ–ボトルネック–デコーダという同じ形を保ったまま、入力か損失のどちらかを変更しています:
| 派生形 | 何が変わるか | なぜか |
|---|---|---|
| 不完備(素のオートエンコーダ) | 何も変わらない。狭いボトルネックが唯一の制約。 | 圧縮と特徴抽出。 |
| デノイジングオートエンコーダ(DAE) | 入力を意図的に劣化させる(例:ガウスノイズ、ピクセルのマスク)が、目標はきれいな元の画像のまま。 | ネットワークは「きれいな」データがどういうものかを学習しなければならない。特徴がより頑健になる。 |
| スパースオートエンコーダ | 潜在の活性化へのペナルティ(例:L1)を損失に加え、どの入力に対してもごく一部のユニットしか活性化しないようにする。 | コピーに陥らずに大きな潜在空間を使える。より解釈しやすい特徴を学習する傾向がある。 |
| 縮小オートエンコーダ(contractive autoencoder) | 入力の小さな変化に対するコードの感度(エンコーダのヤコビアンのノルム)へのペナルティ。 | の小さな摂動からほぼ同じ が得られるようになり、表現がより安定する。 |
| 変分オートエンコーダ(VAE) | エンコーダが点ではなく分布を出力し、KLダイバージェンスの項がそれを事前分布へと引き寄せる。 | 潜在空間を連続的でサンプリング可能なものにし、オートエンコーダを生成モデルに変える。 |
オートエンコーダのユースケース
以下の例はすべて、学習の様子で作った、MNISTで学習させた同じ小さな ConvAutoencoder を使っています。変わるのは、それをどう使うかだけです。
特徴の発見と次元削減
学習が済めば、エンコーダ単体が、学習によって得られた非線形の圧縮器になります。その潜在コードは、クラスタリング、検索、レコメンデーションといった下流タスクのためのコンパクトな特徴として使えます。潜在空間が2次元や3次元であれば、上の潜在空間の図のように、コードを直接プロットして高次元のデータを可視化することもできます。
類似検索はその好例です。すべてのテスト画像を16個の数値からなるコードにエンコードし、クエリに最も近いコードを探すと、見た目の似た画像が得られます:
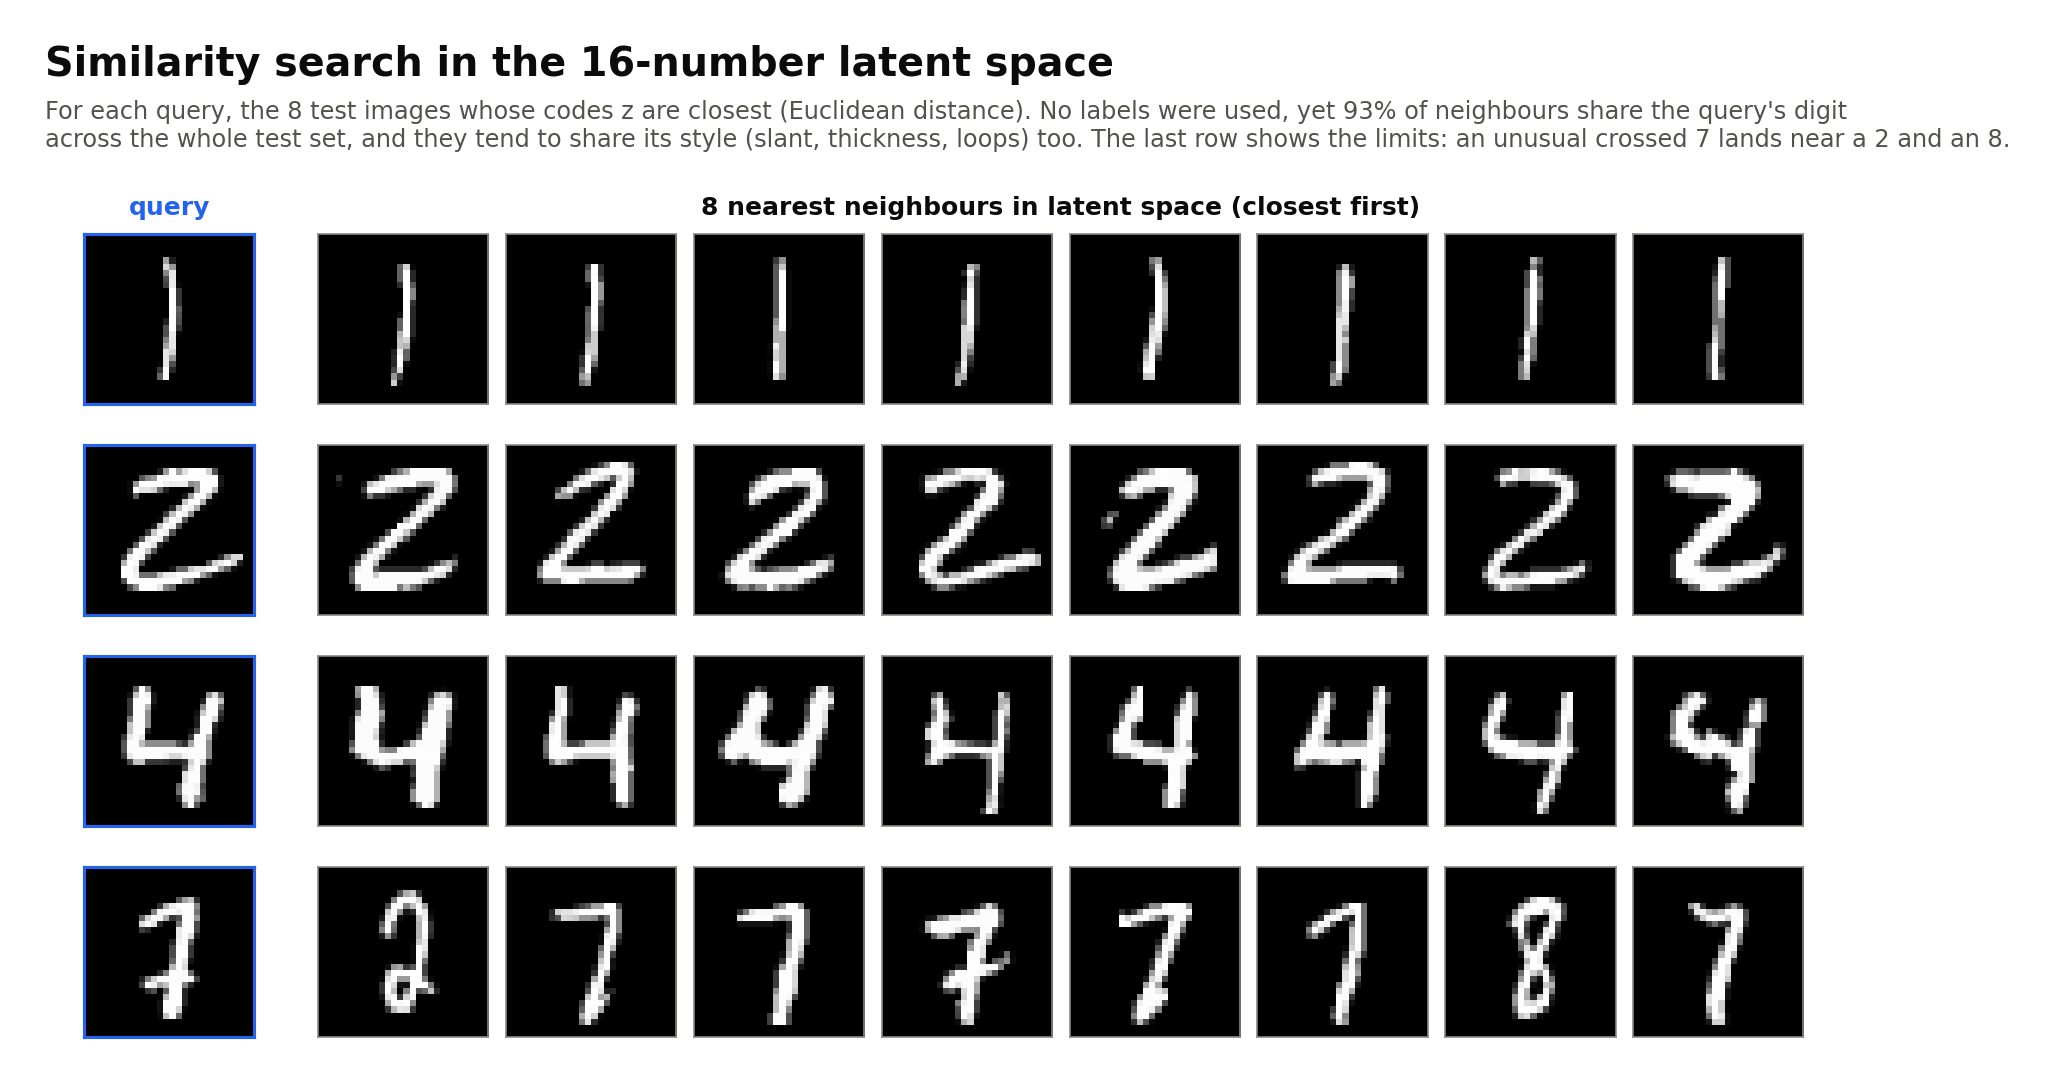
モデルはラベルを1つも見ていないにもかかわらず、最近傍の93%がクエリと同じ数字であり、手書きの癖まで似ている傾向があります。同じ手法が「似たアイテムを探す」機能を支えており、そこでは短いコードを比べるほうが生の画像を比べるよりはるかに安く済みます。最後の行はその限界も示しています。コードが捉えているのは意味ではなく見た目の類似性なので、横線の入った珍しい7は、2や8の近くに位置してしまいます。
この圧縮はデータに特化したものである点に注意してください。手書き数字で学習させたオートエンコーダは、数字はうまく圧縮できますが、顔はうまく圧縮できません。学習したのは数字の構造だけだからです。オートエンコーダは、現代の生成モデルにおける重要な構成要素でもあります。例えば、Stable Diffusionのような潜在拡散モデルは、オートエンコーダを使って画像をはるかに小さな潜在空間に圧縮し、計算コストの高い拡散プロセスを生のピクセルではなくその空間で実行します。
ノイズ除去
デノイジングオートエンコーダは、(劣化した入力、きれいな目標)のペアで学習させます。劣化は通常、学習中に人工的に加えられるので、きれいなバージョンが常に手元にあります。推論時には、ノイズの乗った入力や劣化した入力のきれいなバージョンを出力します。例えば、写真の粒状ノイズを取り除いたり、スキャンした文書をきれいにしたりできます。
この学習の仕方がもたらす違いを見るために、同じアーキテクチャを2回学習させてみます。1回は素のオートエンコーダとして(きれい → きれい)、もう1回はデノイジングオートエンコーダとして、すべての入力にガウスノイズを加えつつ、損失では出力をきれいな元の画像と比較します(ノイズあり → きれい)。同じノイズの乗ったテスト用の数字を、それぞれがどう扱うかを見てみましょう:
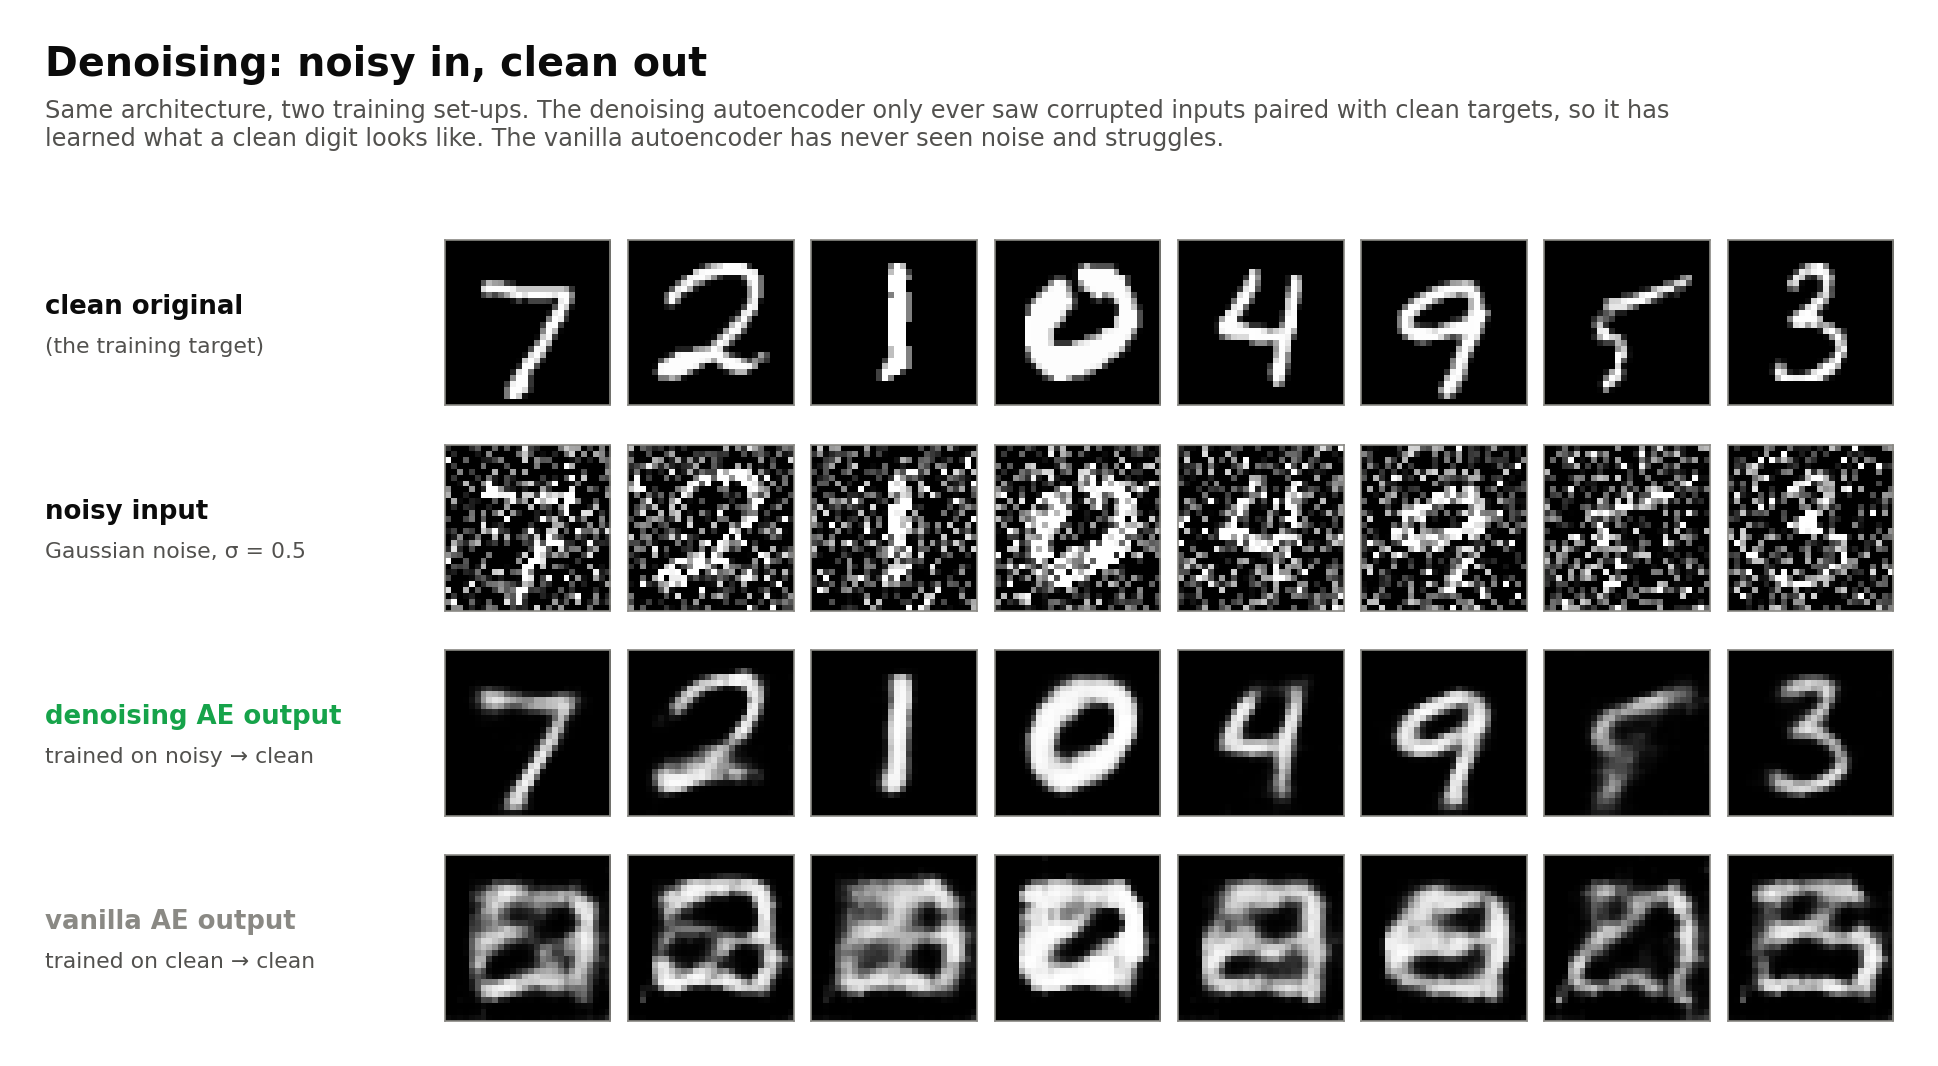
デノイジングオートエンコーダは、私たちが見ても読みにくいような入力から、認識できる数字を取り戻しています。損失を最小化する唯一の方法が、きれいな数字がどういうものかを学び、それ以外をすべて無視することだったからです。素のオートエンコーダはノイズを一度も見たことがなく、それを入力の一部として扱うので、出力はただの塊になってしまいます。違いはすべて学習データにあり、アーキテクチャは同一です。
異常検知と不正検知
考え方は、正常なデータ(例えば正当な取引や健全なセンサーの読み取り値)だけでオートエンコーダを学習させ、「正常」がどういうものかを非常にうまく再構成できるようにすることです。そのうえで、再構成誤差が大きくなる入力はすべて異常としてフラグを立てます。モデルはその種のパターンを再構成することを一度も学習していないからです。しきい値は通常、取り分けておいた正常データでの再構成誤差の分布から、例えば99パーセンタイルに設定します。
以下の例では、数字のオートエンコーダが不正検知器の役を演じます。手書き数字が「正常」なデータで、Fashion-MNISTデータセットの衣類の画像が異常の役を担います:
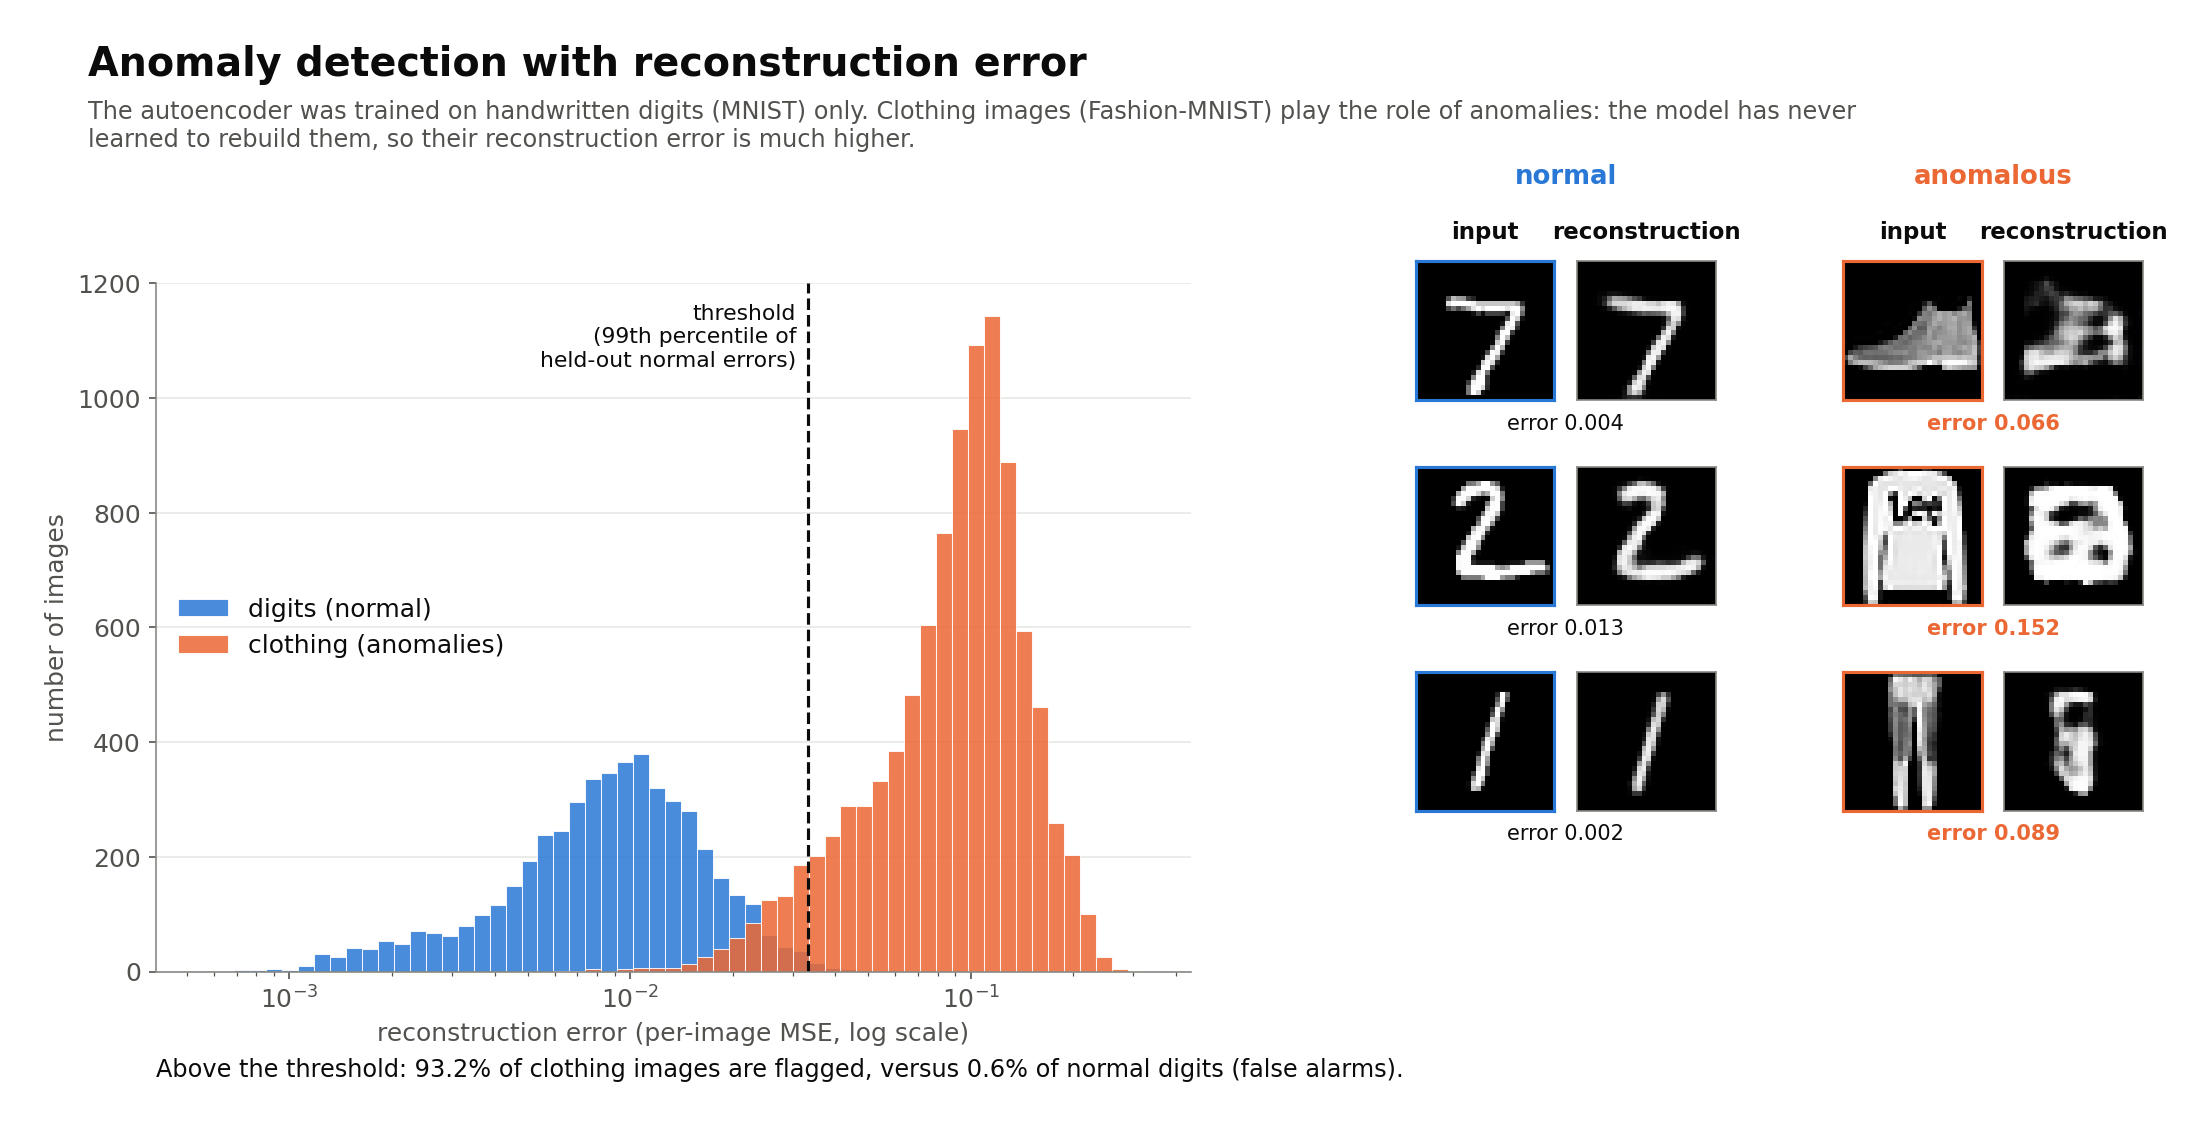
2つの誤差の分布はほとんど重なっていません。取り分けておいた数字での誤差の99パーセンタイルをしきい値にすると、衣類の画像の93%にフラグが立つ一方、誤検知となる正常な数字はわずか0.6%です。右側の再構成を見るとその理由がわかります。靴やセーターを入力されても、デコーダは数字のような線しか描けません。描き方を知っているのはそれだけだからです。
ただし、注意点もあります。十分に強力なオートエンコーダは、異常まで再構成できるほど汎化してしまうことがあり、そうなると異常が正常に見えてしまいます。そのため、ボトルネックの大きさとモデルの容量は調整が必要であり、現実の異常は数字の中に紛れた衣類よりもずっと微妙なものであることがほとんどです。
教師なし事前学習と分類
このユースケースは、ラベル付けにはコストがかかるものの、ラベルのないデータは安く手に入る場合、例えば専門家によるラベル付けが必要な医療画像などのためのものです。手順は次のとおりです:
- まず、エンコーダ+デコーダからなるバックボーン全体を、大量のラベルなしデータで学習させる。
- 次に、ネットワークからデコーダを取り除き、エンコーダの末尾に分類器を取り付ける。
- 大規模なラベルなしデータセットを代表する、小規模なラベル付きデータセットを使って分類器を学習させる。エンコーダは凍結する(分類器だけが学習する)ことも、分類器と一緒にファインチューニングすることもできる。
- 新しいデータ -> エンコーダ -> 分類器 -> クラスラベル
これを試すために、MNISTの学習用画像60,000枚すべてを、ラベルを無視してオートエンコーダとしてエンコーダを事前学習させ、その後Linear層を1つ分類器として取り付けて、わずか100〜3,000枚のラベル付き画像で学習させてみます。比較対象は、まったく同じネットワークを同じラベル付き画像でゼロから学習させたものです:
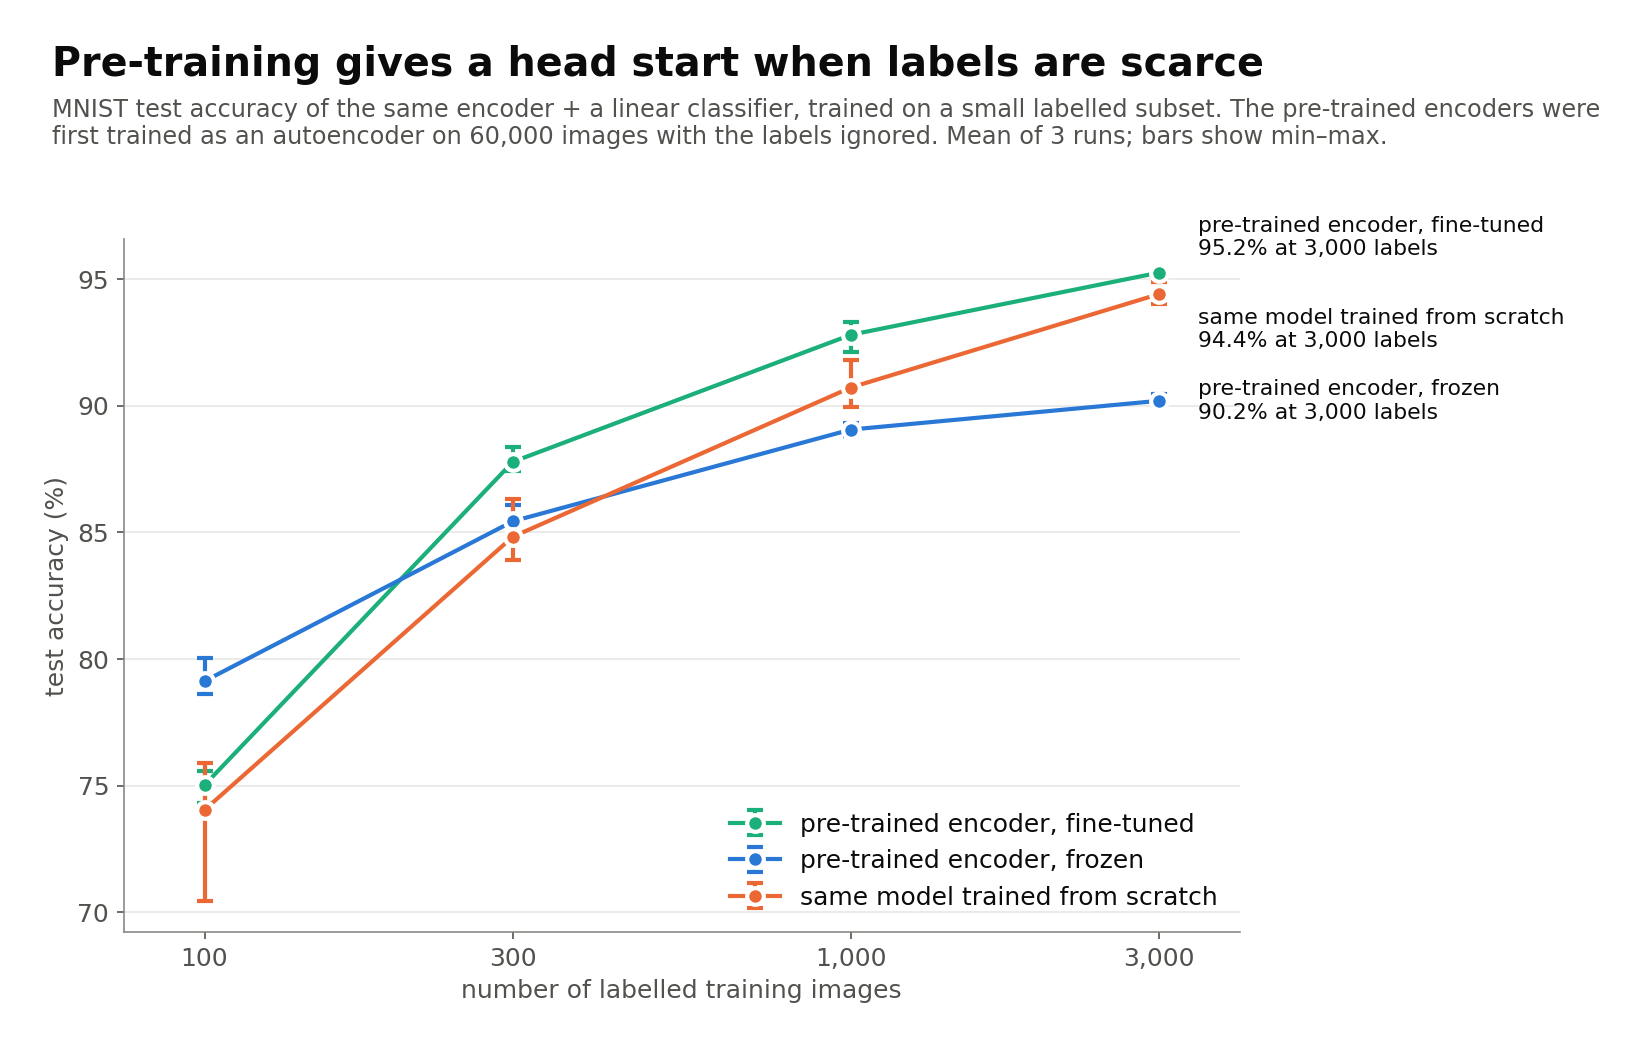
ラベルがわずか100枚の場合、凍結した事前学習済みエンコーダは79%の精度に達し、ゼロから学習させたモデルの74%を上回ります。事前学習で得た特徴が、すでに数字をそれなりにうまく分離しているからです。ラベルが300枚以上になると、事前学習済みエンコーダをファインチューニングしたものが最も良い結果を出します。一方、凍結したエンコーダは90%前後で頭打ちになります。再構成のためだけに学習した特徴は、分類器が必要とする特徴とは少し異なり、適応する余地を与える必要があるのです。また、ラベルが豊富になるにつれて優位性は縮まり、ラベル100枚での約5ポイントから、3,000枚では1ポイント未満になります。
このささやかで、しかも縮んでいく効果は、より良い初期化手法や学習の工夫によって深いネットワークをゼロから簡単に学習できるようになってから、素のオートエンコーダによる事前学習が廃れていった理由の一端です。とはいえ、考え方そのものは生き続けています。マスクドオートエンコーダ(MAE)は、画像のパッチの大部分を隠してモデルにそれを再構成させることでVision Transformerを事前学習させるもので、画像のための自己教師あり事前学習手法の中でも特に効果的なものの1つです。
まとめ
オートエンコーダは、入力そのものだけを目標として、入力を小さな潜在コードに圧縮し(エンコーダ)、そのコードから入力を復元する(デコーダ)ことを学習します。単なるコピーではなく有用な構造を学習させるのは、ボトルネックの役割です。損失は良い再構成にしか報いないので、潜在空間は空白だらけで配置も任意のものになります。類似検索、ノイズ除去、異常検知、事前学習にはそれで十分ですが、新しいデータの生成には向きません。VAEは、各入力を分布としてエンコードし、潜在空間を事前分布へと正則化することでこの問題に対処します(変分オートエンコーダ(VAE)についての記事を参照)。
参考文献
- Hinton, G. E. & Salakhutdinov, R. R. (2006). Reducing the Dimensionality of Data with Neural Networks. Science, 313(5786), 504–507.
- Vincent, P., Larochelle, H., Bengio, Y. & Manzagol, P.-A. (2008). Extracting and Composing Robust Features with Denoising Autoencoders. ICML.
- Rifai, S., Vincent, P., Muller, X., Glorot, X. & Bengio, Y. (2011). Contractive Auto-Encoders: Explicit Invariance During Feature Extraction. ICML.
- Kingma, D. P. & Welling, M. (2013). Auto-Encoding Variational Bayes: https://arxiv.org/abs/1312.6114
- Goodfellow, I., Bengio, Y. & Courville, A. (2016). Deep Learning, Chapter 14: Autoencoders: https://www.deeplearningbook.org/contents/autoencoders.html
- He, K. et al. (2021). Masked Autoencoders Are Scalable Vision Learners: https://arxiv.org/abs/2111.06377
- MNIST: LeCun, Y., Cortes, C. & Burges, C. J. C. The MNIST database of handwritten digits.
- Fashion-MNIST: Xiao, H., Rasul, K. & Vollgraf, R. (2017). Fashion-MNIST: a Novel Image Dataset for Benchmarking Machine Learning Algorithms: https://arxiv.org/abs/1708.07747