
オートエンコーダについての記事は、ある問題で締めくくりました。オートエンコーダはすべての入力を潜在空間内の1つの点に押し込みますが、それらの点が、間に大きな空白を挟んだ孤立したクラスタへと散らばってしまうのを止めるものは何もありません。圧縮のためならそれで構いませんが、ランダムなコードを選んでデコーダに新しい何かへ変換させようとすると、たいていは意味をなさない出力が返ってきます。
変分オートエンコーダ(VAE)は、2つの小さな変更でこれを解決します。エンコーダが点ではなく 分布 を出力するようにし、損失にはそれらの分布すべてを共通の事前分布の近くに保つための項を1つ追加します。本稿ではこの2つの変更を順に見ていき、そのうえで私が理解するのにいちばん時間がかかった部分、つまり学習・再構成・生成の各段階で z の得方がどう異なり、なぜそうなるのかを解説します。
「変分」とは平たく言うと何か
この名前は、統計学の手法の一群である 変分推論 に由来します。ある量を厳密に計算するのが難しすぎるとき、より単純な分布の族を選び、その中で(つまりパラメータを 変化させながら)本当に求めたい量を最もよく近似するものを探す、という考え方です。
VAEで求めたい量は事後分布 です。つまり、画像 が与えられたとき、どの潜在コード がそれを生み出し得たのか、ということです。これを厳密に計算するには という、あり得るすべての にわたる積分が必要になり、ニューラルネットワークのデコーダではこれは計算できません。そこで代わりに、エンコーダが近似 を学習し、その形は単純なもの、つまり潜在次元ごとに1つの平均と1つの分散を持つガウス分布に制限されます。
平たく言えば、VAEは「この を生み出すのは どの そのもの か?」に答える代わりに、「 に近いものを生み出し得るのは どの領域 の か?」に答えます。その領域から引いたどの も、デコードすれば に似たものになるはずです。
VAEとAE:アーキテクチャの違い
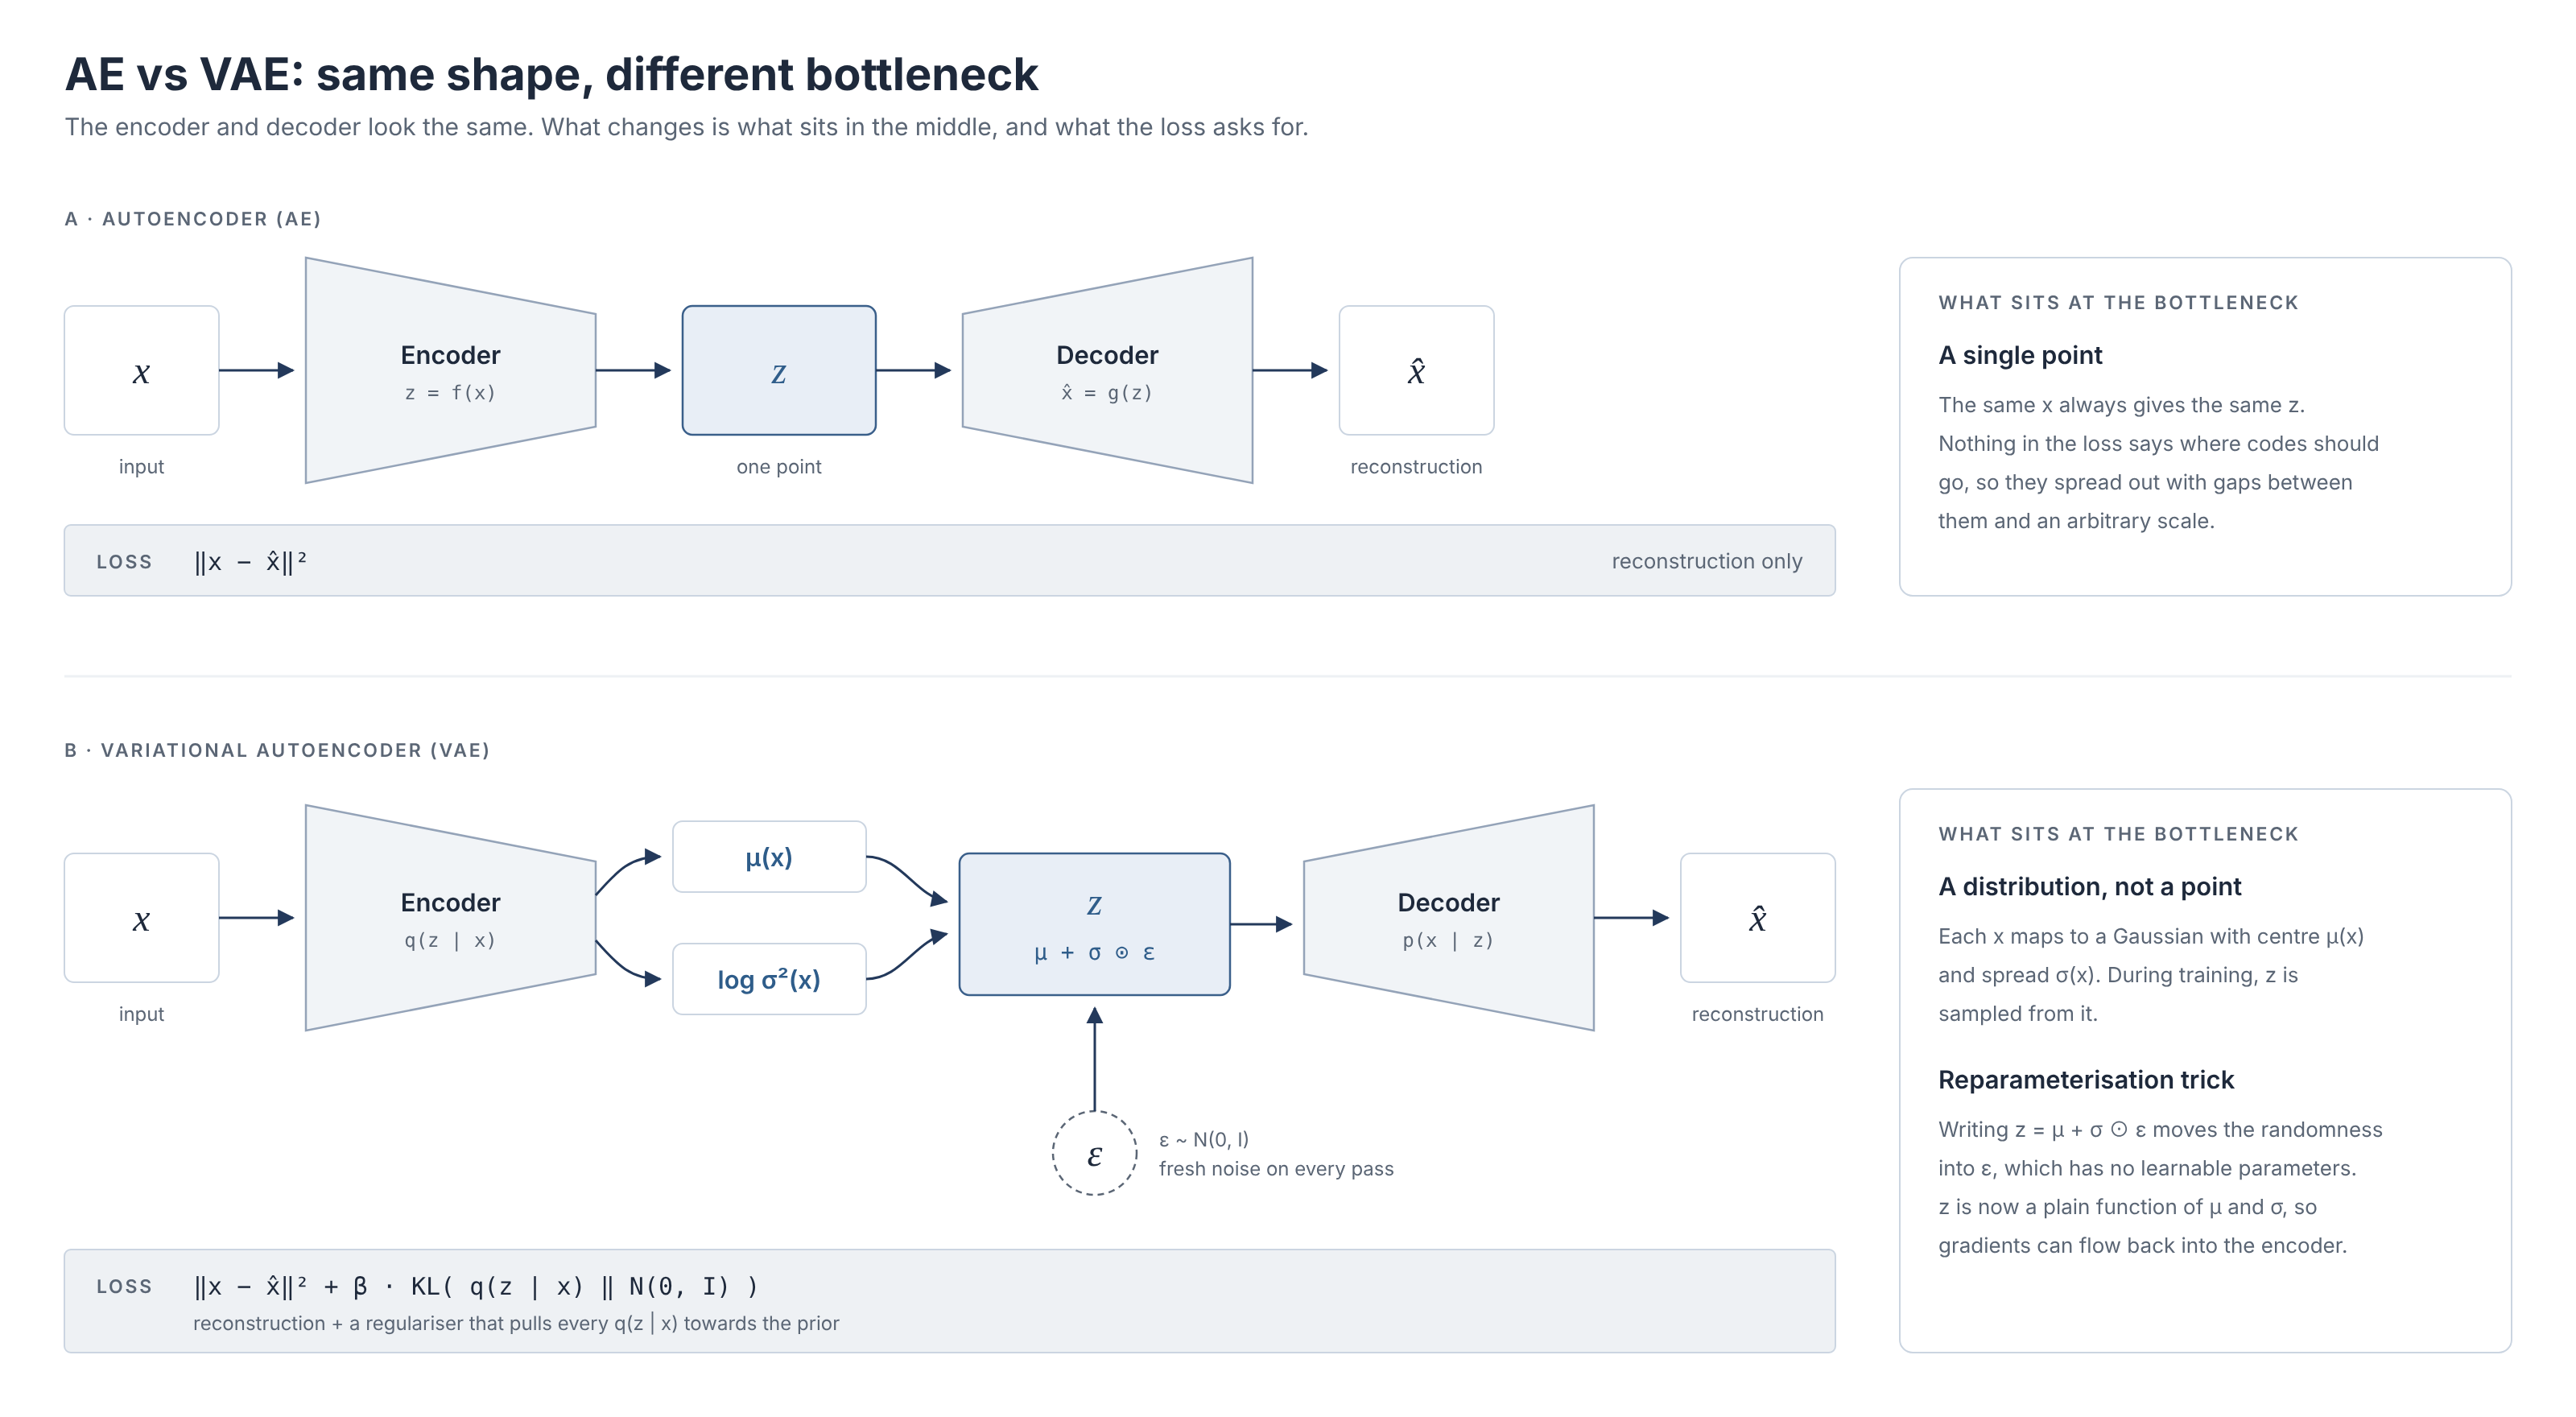
外から見ると、2つのネットワークはほとんど同じに見えます。違いはボトルネックと損失にあります:
1. エンコーダの出力
AEのエンコーダは z_dim 個の数値からなるベクトル、つまり潜在空間内の固定された1つの点を出力します。一方、VAEのエンコーダは入力ごとに 2 * z_dim 個の数値を出力します。各潜在次元についての平均 と対数分散 です。これらを合わせると、点ではなく潜在空間内のガウス分布の「雲」を表すことになります。
以下は、MNISTデータセットで条件付きVAEを学習させたプロジェクトで私が実装した Encoder を簡略化したものです:
class Encoder(nn.Module):
    def __init__(self, z_dim):
        super().__init__()
        self.encoder_backbone = nn.Sequential(...)   # convolutions, flattening, etc.
        self.encoder_head = nn.Sequential(
            nn.Linear(256, 2 * z_dim)
        )

    def forward(self, x):
        x = self.encoder_backbone(x)
        x = self.encoder_head(x)
        mu, logvar = torch.chunk(x, 2, dim=1)
        return mu, logvar
2 * z_dim 個の数値のどちらの半分を mu にし、どちらの半分を logvar にするかは 任意 である点に注意してください。学習前の時点では、それらはただの数値にすぎません。後でどう使うか(サンプリングのステップとKL項)によって初めて平均や対数分散に なる ので、一貫していればどんな分け方でも構いません:
mu, logvar = torch.chunk(mu_logvar, 2, dim=1)
# Or
logvar, mu = torch.chunk(mu_logvar, 2, dim=1)
# Or
mu = mu_logvar[:, 0::2]
logvar = mu_logvar[:, 1::2]
# Or any other ordering, as long as there are equal numbers of mus and logvarsなぜ分散そのものではなく対数分散なのでしょうか。分散は正でなければなりませんが、Linear 層はどんな実数でも出力し得ます。 を予測させれば、ネットワークは好きな値を出力でき、しかも は常に正になります。分散が非常に小さくなったときに数値的に安定するという利点もあります。
入力ごとに分布があるので、区別しておくべき分布が2種類あることになります:
- 個別の事後分布(individual posterior) :1枚の画像に対してエンコーダが出力する
muとlogvarで定まる、小さなガウス分布の雲。 - 集約事後分布(aggregate posterior) :個別の雲すべてをデータセット全体で平均したもの。
事前分布には通常、標準正規分布 を 選びます。損失のKL項(次節)は個々の雲をすべてこの事前分布へと引き寄せますが、再構成項はそれに抵抗します。特定の画像を復元するには、その雲がある程度狭く、自分の場所にとどまっている必要があるからです。結果として妥協が生まれます。個々の雲は小さいままですが、全体としては事前分布を埋め尽くすので、 に近づくのは 集約 事後分布のほうです:
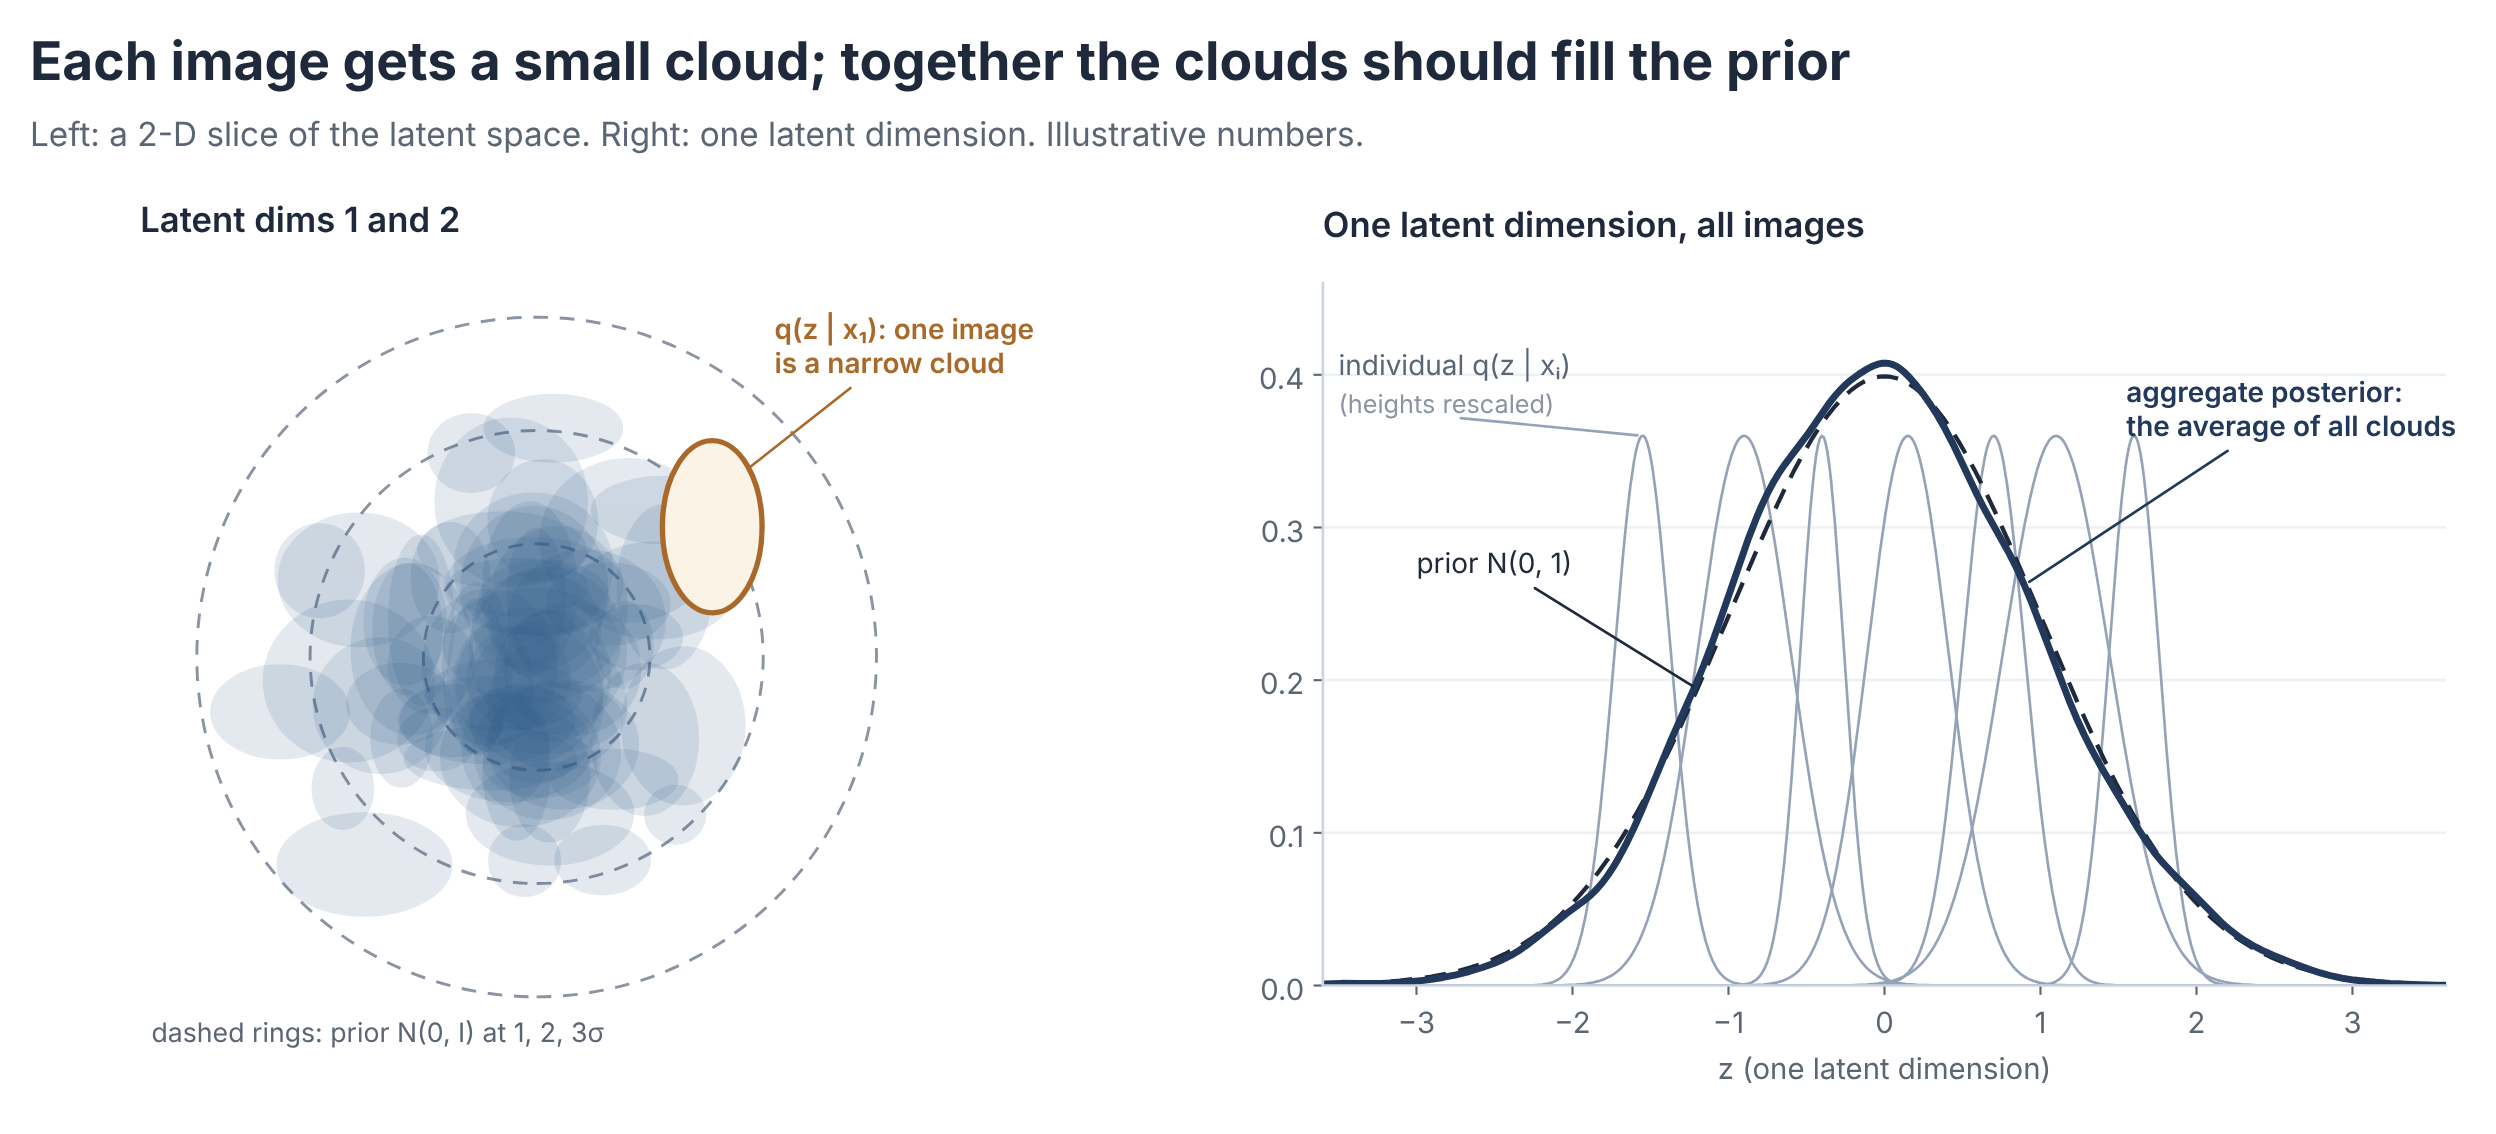
これは、学習済みのモデルを調べたときに私が目にした結果とも一致します。テスト画像全体で見ると、各潜在次元の の値は0付近におおよそ釣り鐘型に分布していた一方、 の値はほとんどが0.1から0.4の間でした。個々の雲は狭いのに、全体としては事前分布を覆っているわけです。
(もし個々の雲までもがすべて になってしまったら、すべての画像が同じ雲に対応づけられ、 はデコーダに何の情報も伝えなくなります。これについては後の の話で詳しく触れます。)
2. 損失関数
AEと比べると、VAEの損失にはKLダイバージェンスの項が追加されています:
ここで はピクセル数です。事後分布が対角ガウス分布で事前分布が標準正規分布の場合、KL項は閉じた形で書けます:
ここで は z_dim です。和の各項は かつ のときに最小になるので、KL項は2つの役割を果たします。雲を原点へ引き寄せること(AEのコードのように離れていかないように)と、雲が点へと縮むのを防ぐこと(重なり合って隙間を埋めるように)です。定数を除けば、2つの項の和はELBO(証拠下界)、つまり変分推論が最大化する目的関数の符号を反転させたものになります(これについては、ELBOについての別の記事で詳しく解説する予定です)。
2つの項は互いに 競合 します。再構成項は、すべての画像がそれぞれはっきりと分離した固有のコードを持つことを求め、KL項は、すべてのコードが同じ標準正規分布のように見えることを求めます。この2つのバランスこそが、VAEにそれなりの再構成と、サンプリング可能な潜在空間の両方をもたらしているのです。
実装上の落とし穴を1つ挙げておきます。再構成誤差は、KL項を潜在次元について和をとるのと同じように、ピクセルについて 和をとり、そのうえでバッチについて平均すべきです。F.mse_loss をデフォルトの reduction="mean" のまま使うと、再構成誤差がピクセル数(MNISTなら784)で割られてしまい、KL項が意図より何百倍も強くなっていることに気づきにくくなります。ピクセル値が の範囲にある場合は、和をとったバイナリクロスエントロピーも再構成項としてよく使われます。
元のVAEは2つの項を単純に足し合わせるだけです。よく使われる派生形では、KL項にハイパーパラメータ を掛けてその強さを調整します:
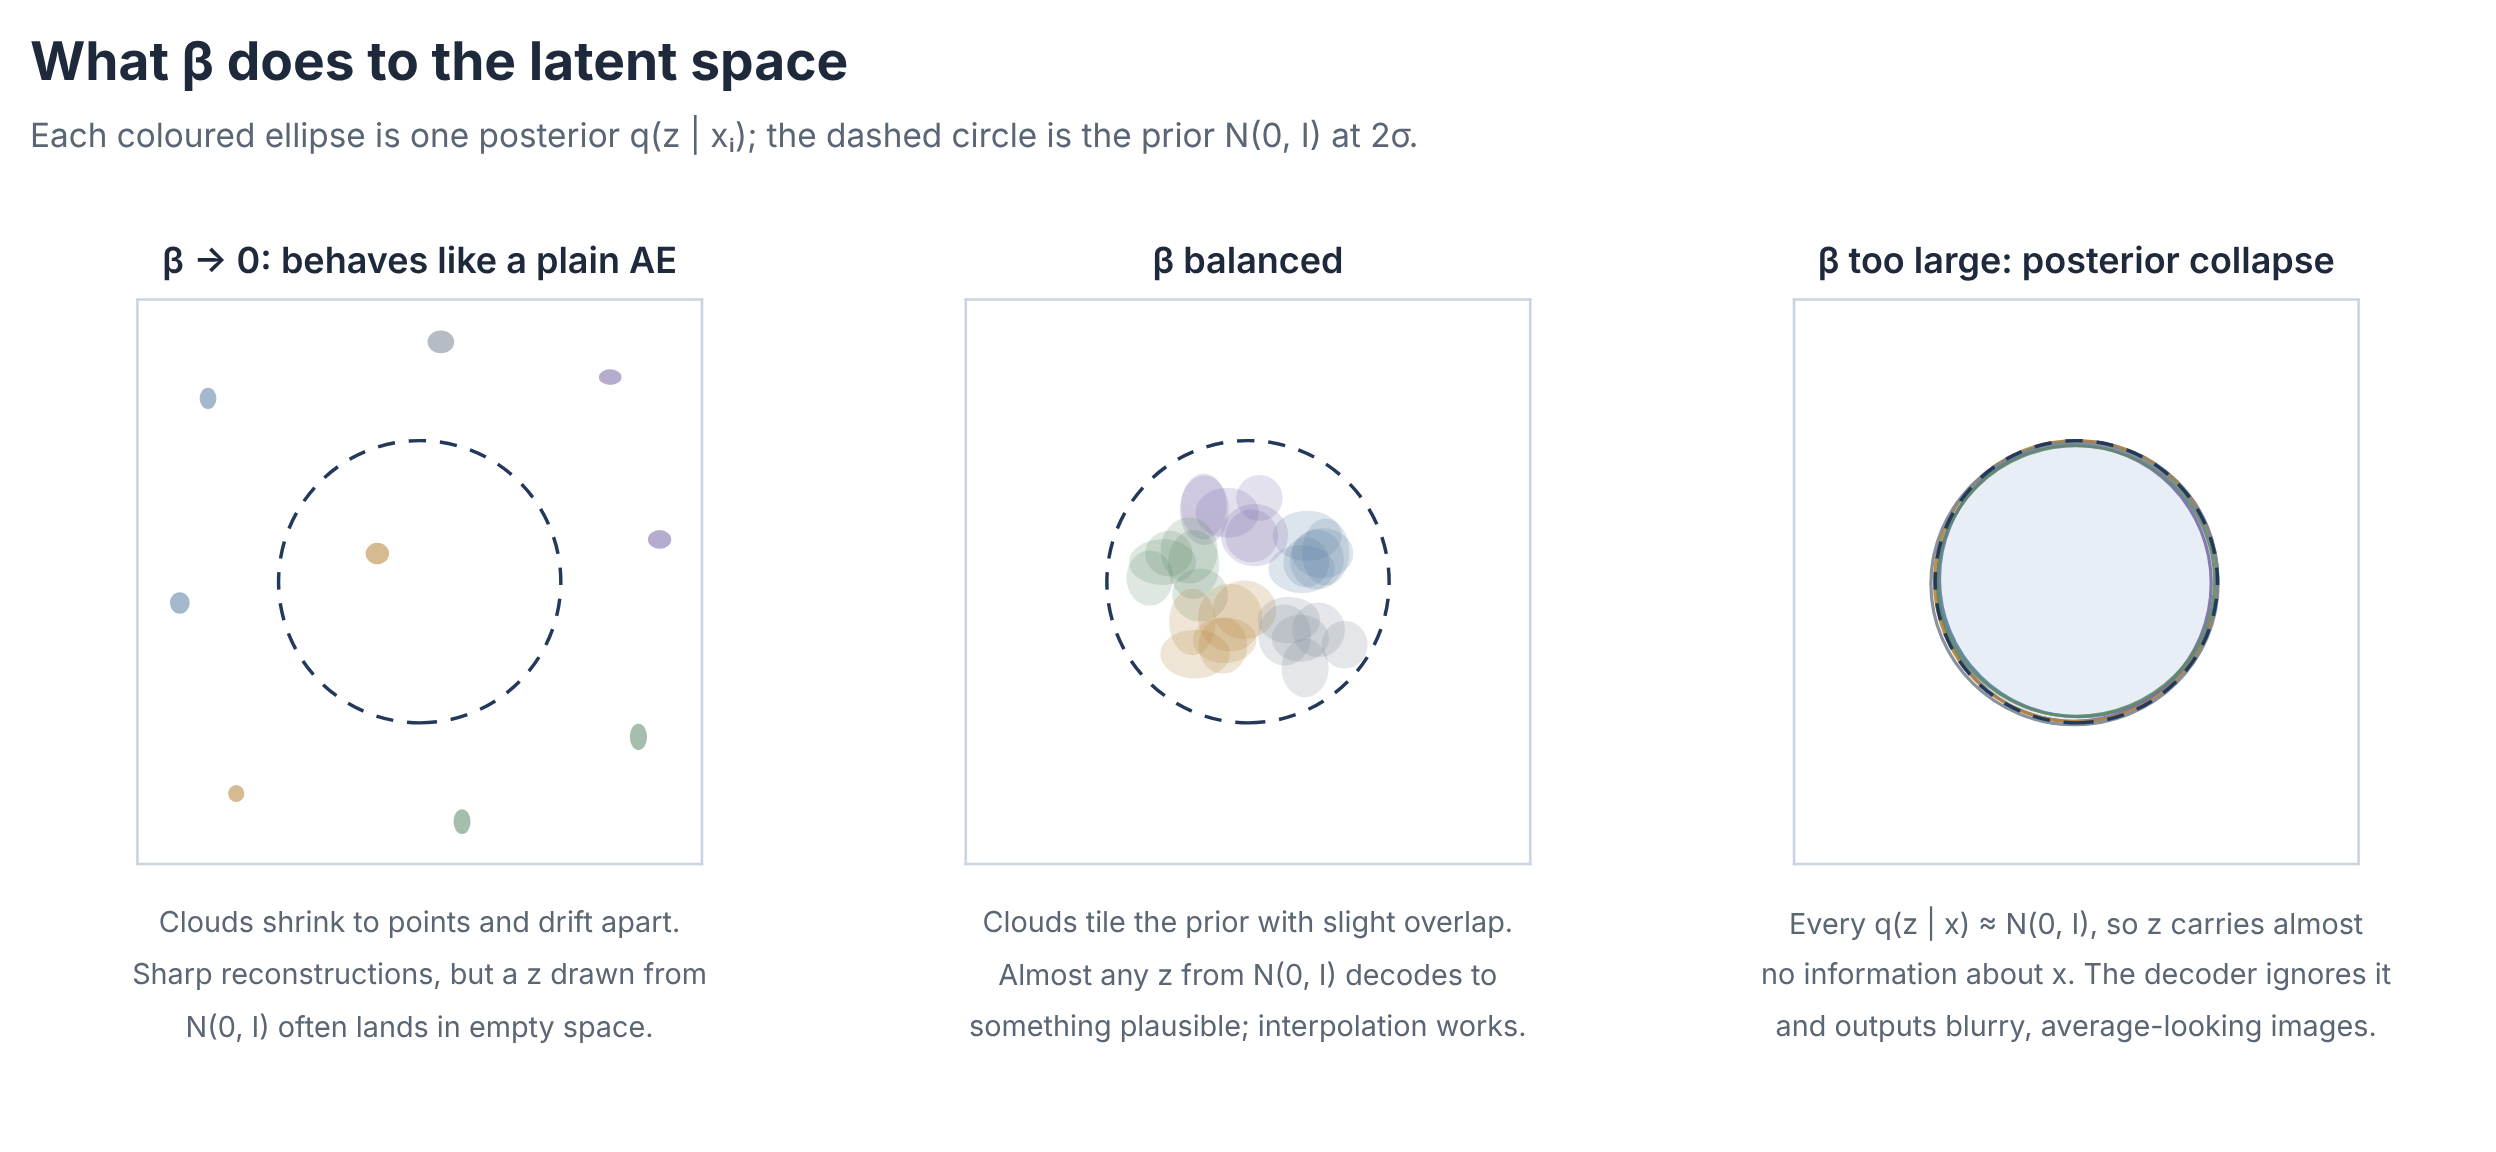
- が小さい場合:再構成項が支配的になります。雲は点へと縮んで互いに離れていき、モデルはどんどん普通のAEのように振る舞うようになります。再構成は鮮明ですが、 から引いた はしばしば何もない空間に落ち、生成結果は一貫性がなかったり崩れていたりします。 では がゼロへと縮むのを止めるものがないので、実質的には少しノイズの入ったAEになります。
- が大きい場合:KL項が支配的になり、すべての雲が事前分布の上に崩れ落ちます。これは 事後分布の崩壊(posterior collapse) と呼ばれます。 は入力についての情報をほとんど持たなくなり、デコーダはそれを無視するように学習し、再構成も生成もぼやけた平均的な見た目になります。
- のバランスが取れている場合:雲がわずかに重なり合いながら事前分布を敷き詰めます。 から引いたほぼどんな もそれらしい画像にデコードされ、2つのコードの間を移動すると滑らかに変化します。
学習初期の崩壊を避けるためによく使われる手法に KLアニーリング があります。 を0付近から始めて最初の数エポックで徐々に引き上げることで、KL項がコードを締めつけ始める前に、エンコーダが有用なコードを学習できるようにするものです(Bowman et al., 2016)。
サンプリング:zはどこから来るのか
AEとVAEを勉強していたとき、これらのアーキテクチャと、その設計の背後にある考え方を本当に理解するための鍵は、潜在空間がどう構成されているのか、そしてそれぞれの場合に z がどう得られるのかを理解することだと気づきました。
オートエンコーダについての記事で触れたように、AEのコードは潜在空間のどこにでも現れ得るクラスタを形成します。一方VAEでは、各入力はガウス分布の雲に対応づけられ、すべての雲が事前分布へと引き寄せられます:
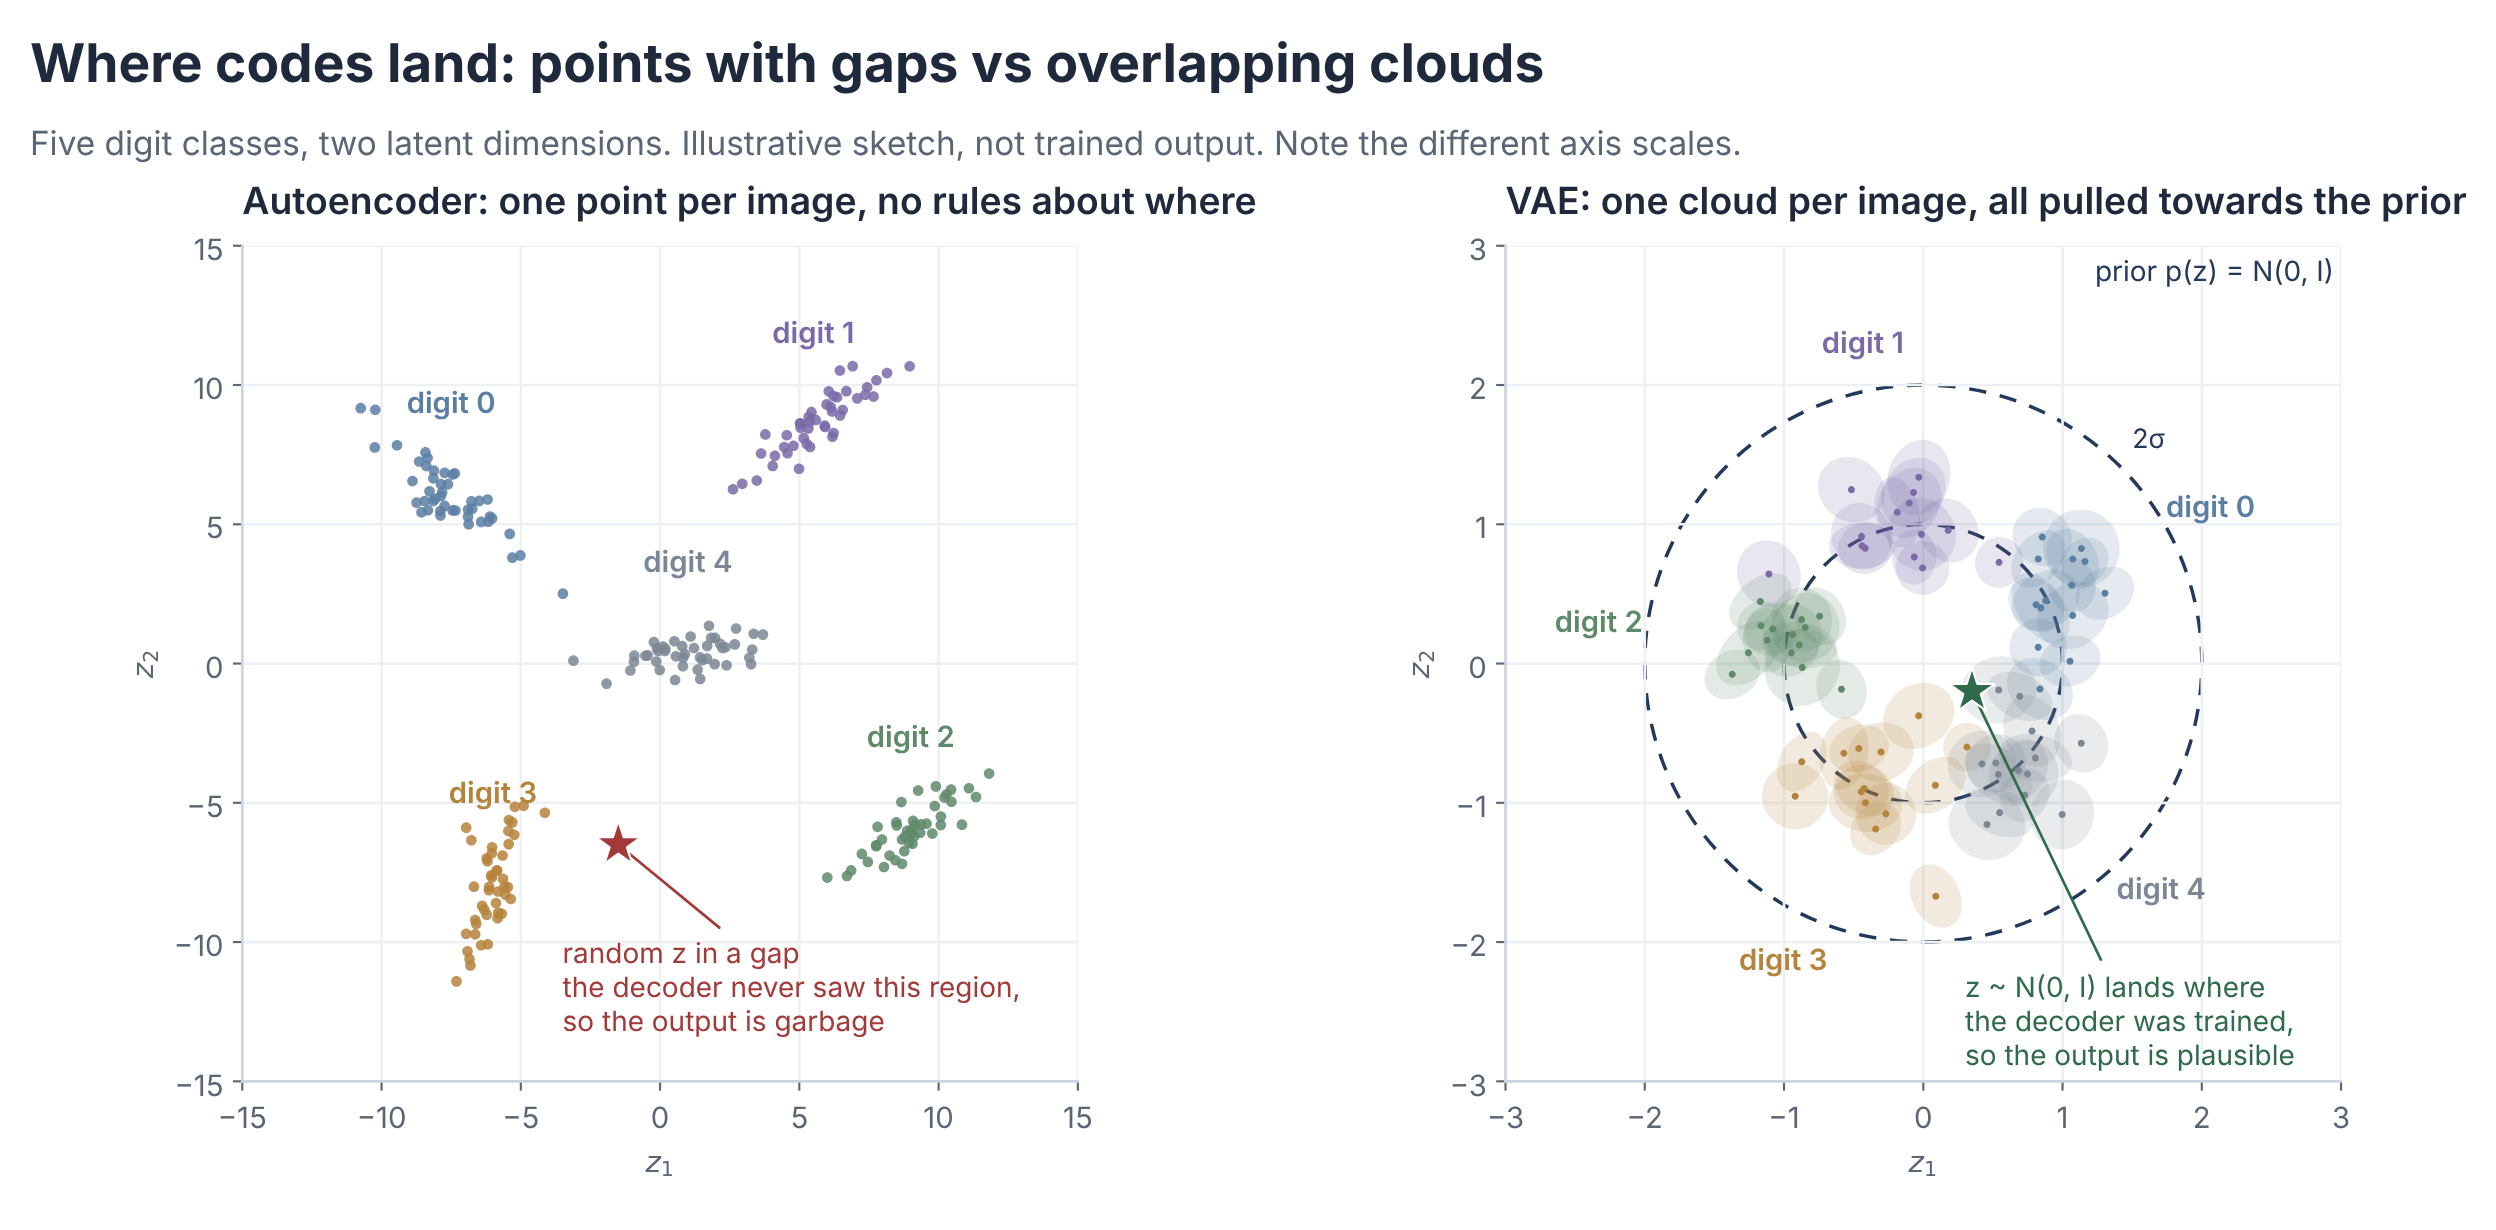
AEにはサンプリングがまったくありません。エンコーダは決定的で、出力したコードがそのままデコーダに入ります。新しい何かを生成したければ、自分でコードを選び、それが隙間に落ちないことを祈るしかありません。
VAEではもっと面白くなります。何をしようとしているかによって、z の得方が変わるからです:
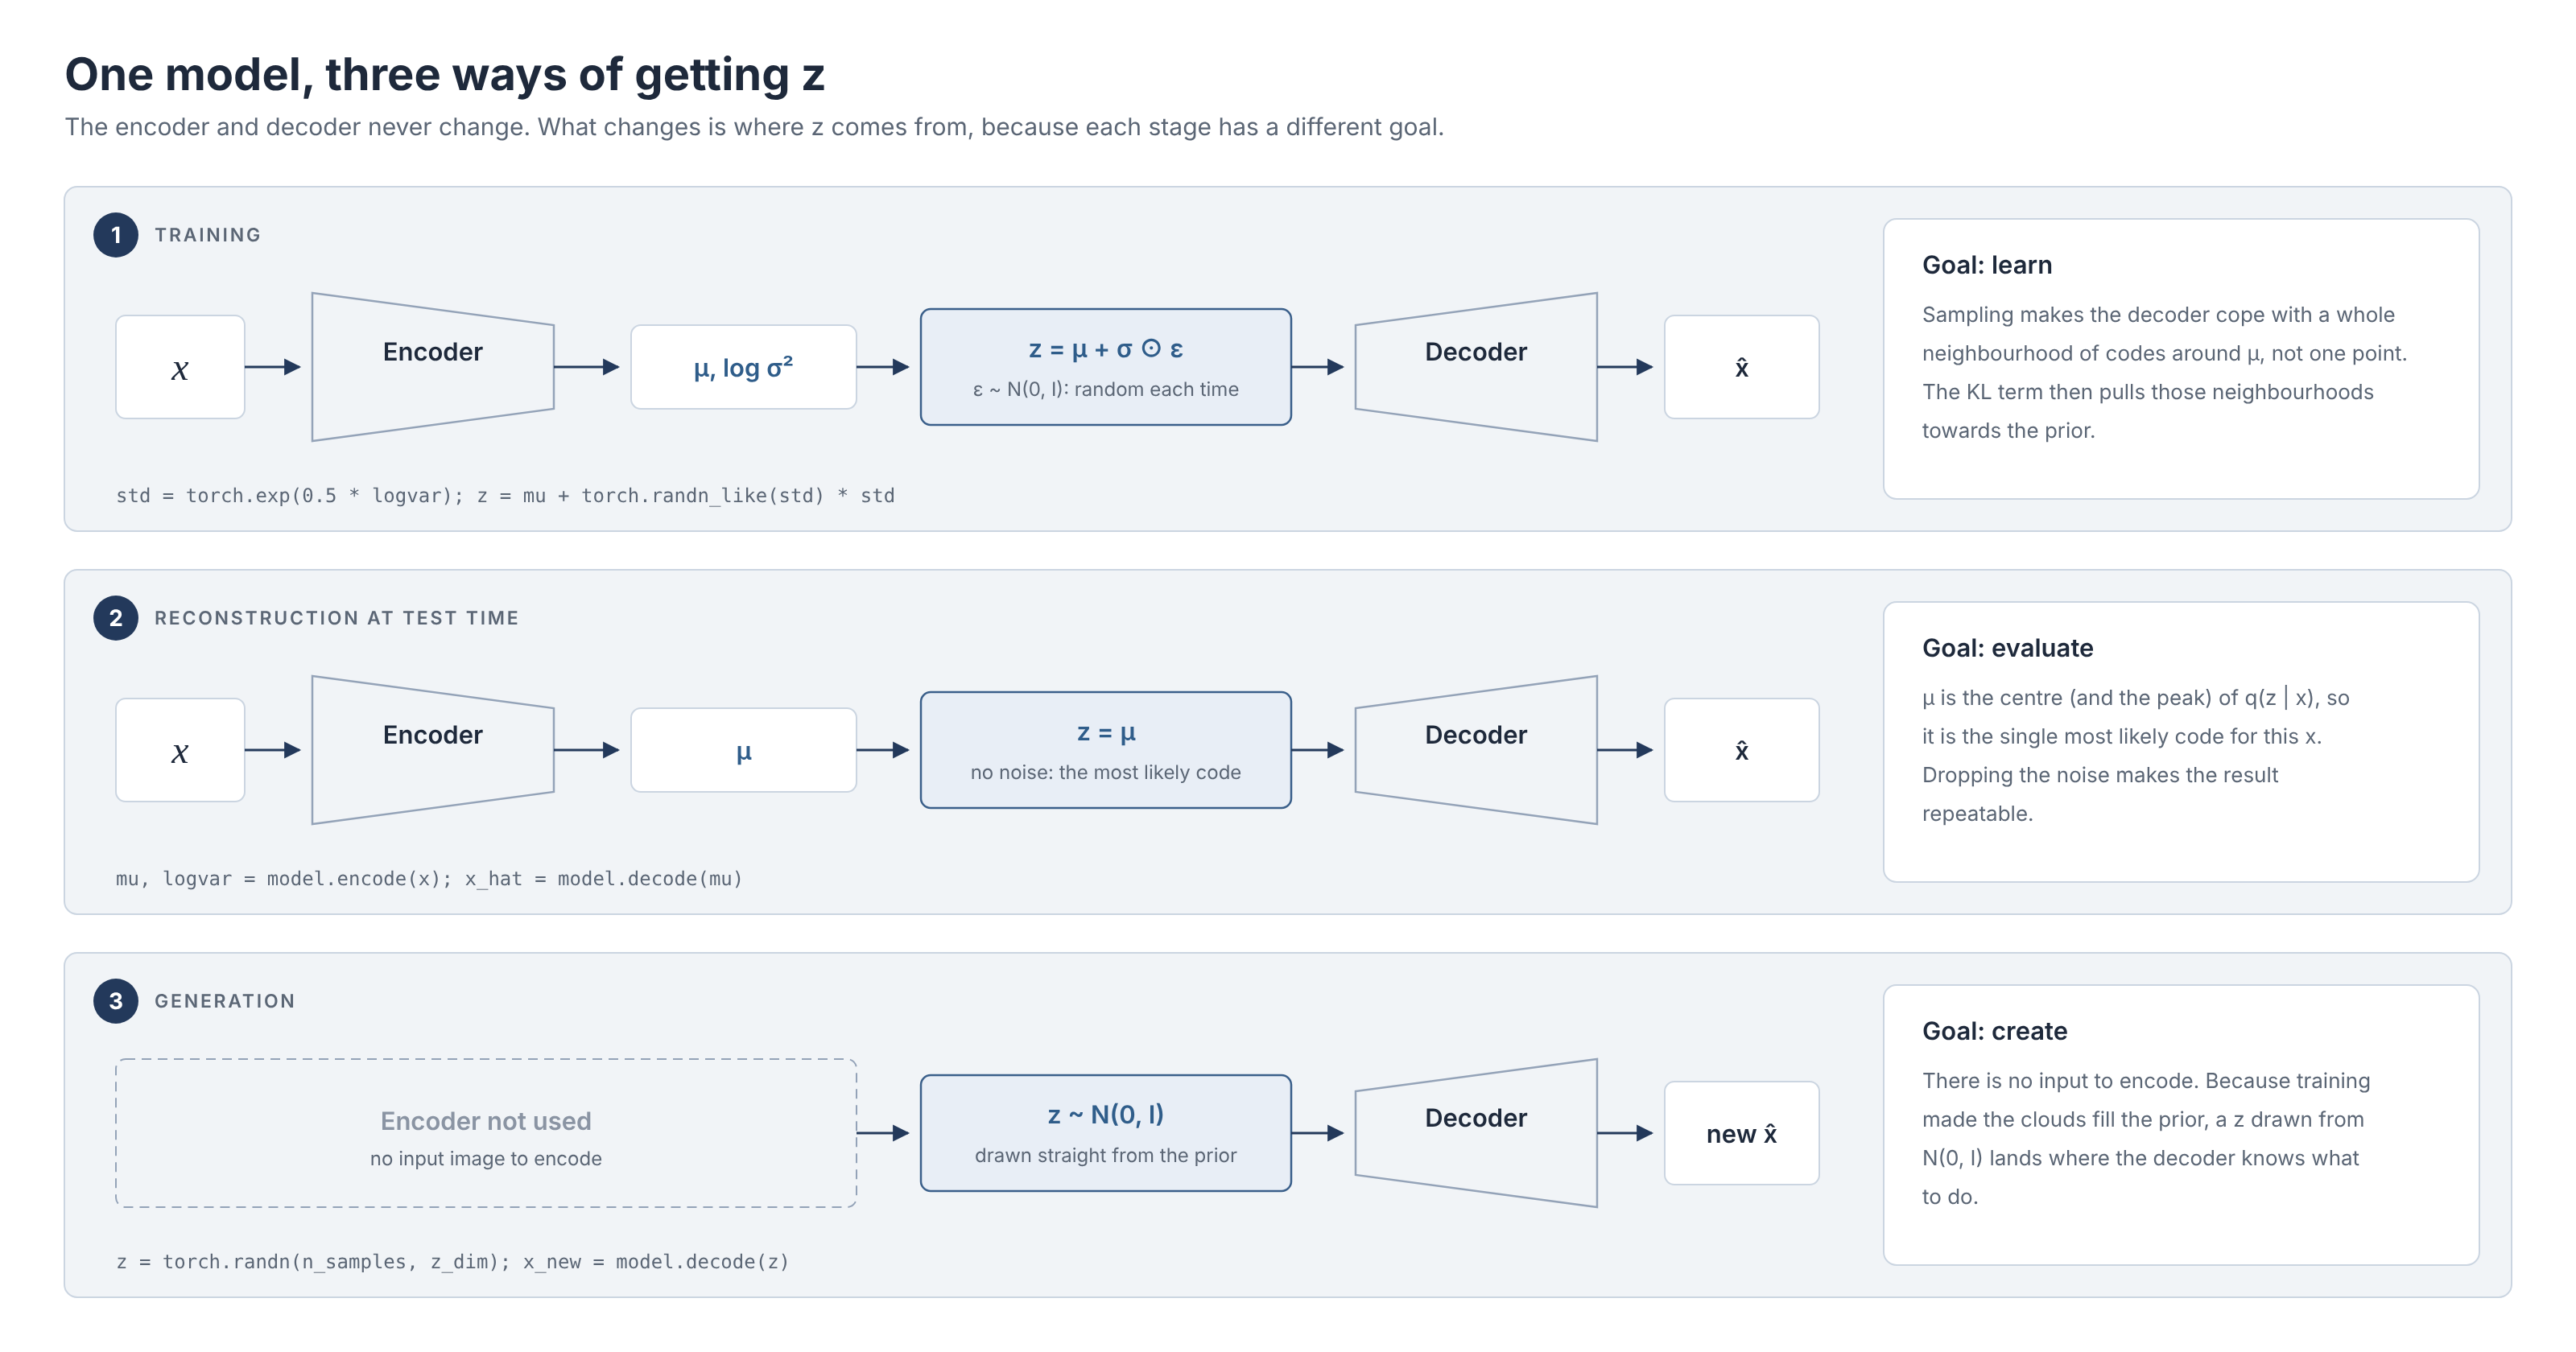
学習 での目的は学ぶことなので、エンコーダがその入力に対して出力した と を使い、 からランダムにサンプルを引きます。これには3つの理由があります:
- デコーダに点ではなく領域を教えるため。 同じ画像でも見るたびに少しずつ異なる
zが得られるので、デコーダは の周辺全体を、その画像に似たものへと対応づけなければなりません。その結果、近いコードは似た画像にデコードされるようになります。これこそが潜在空間を滑らかにしているものです。 - に意味を持たせるため。 常に をデコードしていたら、分散はKL項にしか現れず、KL項は何のコストもなく分散を1へと押しやるので、雲には何の意味もなくなってしまいます。サンプリングをすれば、 が大きいほどコードにノイズが乗って再構成が悪くなるので、再構成項とKL項は、各雲の幅をどれくらいにするかを巡って折り合いをつけなければならなくなります。
- 再構成項を推定するため。 厳密に言えば、損失が求めているのは雲の中のすべての にわたる再構成誤差の 平均 です。あり得るすべての を評価することはできないので、学習ステップごとにランダムなサンプルを1つ取ります。1回ごとの推定はノイズを含みますが、何千ステップにもわたれば平均化されます。
ただし、サンプリングをそのまま行うと誤差逆伝播が使えなくなります。ランダムに引いた値は や についての勾配を持たないからです。再パラメータ化トリック は、ノイズを別に引いてから、それをずらして拡大縮小することでこれを回避します:
std = torch.exp(0.5 * logvar)
eps = torch.randn_like(std)   # ε ~ N(0, I), no learnable parameters
z = mu + eps * std            # z is now a differentiable function of mu and std
ランダム性はすべて eps の中にあるので、勾配は mu と std を通ってエンコーダまで流れることができます。
再構成 での目的は評価であって、最適化ではありません。エンコーダが出力する はガウス分布の中心でもあり頂点でもあるので、入力画像にとって最も確からしいコードです。それをそのままデコードに使えばよく、そうすることで結果に再現性も生まれます。
生成 での目的は、評価でも最適化でもありません。学習済みのモデルから新しい何かを 得たい のであって、エンコードする入力画像はありません。わかっているのは、学習によって集約事後分布が事前分布 へと押しやられたということです。したがって、事前分布から引いた は、デコーダが扱い方を知っている領域に落ちるはずです。だからこそ事前分布からサンプリングするのです。それらしいものは得られますが、何が 得られるかを選ぶことはできません。
ユースケース
AEの潜在空間からランダムに引いた は、ほとんどの場合デコーダが学習中に一度も見たことのない場所に落ちる(しかも次元が高くなるほど空白は広がる)ため、従来のAEは生成タスクには向いていません。
VAEの潜在空間はより整理されていて滑らかなので、次のような用途にずっと適しています:
- 生成:事前分布から新しいサンプルを引く。
- 補間と潜在空間での演算:あるコードから別のコードへと移動したり、「笑顔」のような方向を顔に加えたりする。
- 異常検知:うまく再構成できない入力や、コードが事前分布から遠く離れた位置に落ちる入力は、分布外である可能性が高い。
- より大きなモデルのための圧縮:Stable Diffusionのような潜在拡散モデルは、VAE型のオートエンコーダ(KL項はごく弱いもの)を使って画像をコンパクトな潜在空間に圧縮し、拡散モデルはその空間の中で動作します(Rombach et al., 2022)。
VAEにも弱点があります。VAEのサンプルはGANや拡散モデルのものよりぼやけやすく、VAE-GANのようなハイブリッドが存在するのはそのためです。
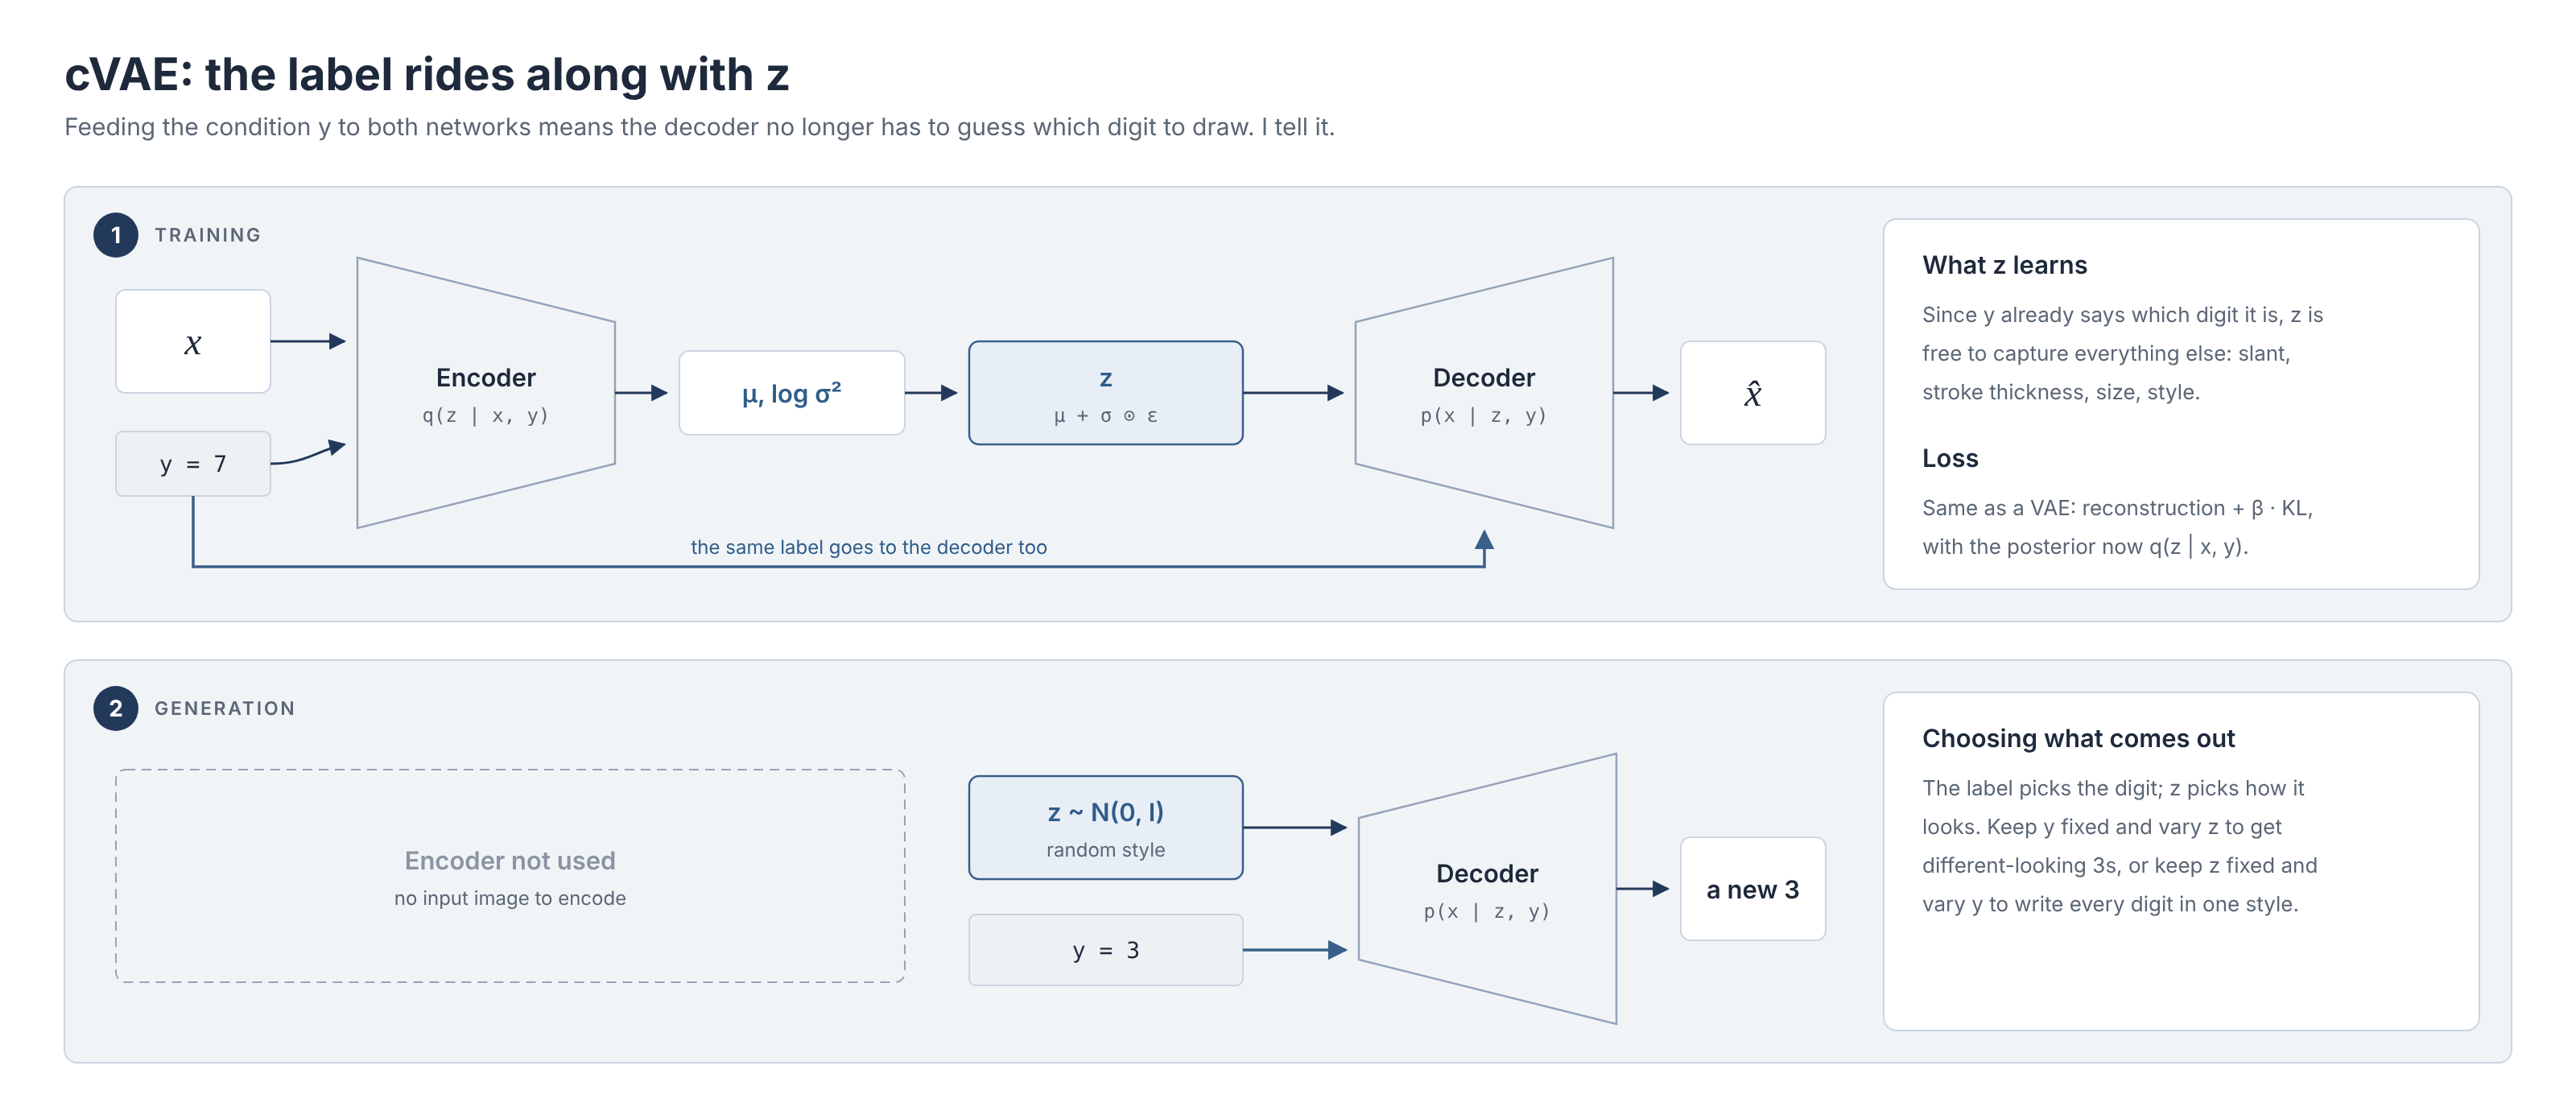
特定の 出力を生成するのに特に役立つ一般的な派生形が、条件付きVAE(cVAE) です(Sohn et al., 2015)。学習時には、条件(例えば数字のラベル)をエンコーダとデコーダの両方に与えます。どの 数字を描くかはラベルがすでにデコーダに伝えているので、z はそれ以外のすべて、つまり傾きや線の太さ、書き方の癖を自由に表現できます。生成時には、サンプリングした z を欲しいラベルと一緒に渡すので、ランダムに引いた値からデコーダがたまたま生み出したものではなく、求めた ものが得られます:
まとめ
AEからVAEへの飛躍は、書面上は小さく見えます。ボトルネックの出力が1つから2つになり、損失に項が1つ増えるだけです。しかし、それによって潜在空間の あり方 が変わります。間に何もない点の散らばりの代わりに、既知の分布を埋め尽くす重なり合った雲が得られ、それこそが圧縮器を生成器へと変えるのです。
要点をいくつかにまとめるなら、次のようになります:
- エンコーダは入力ごとに、点ではなく分布(、)を出力する。
- KL項はすべての分布を事前分布へと引き寄せ、再構成項はそれらが情報を持ち続けるようにする。そのバランスを決めるのが 。
zは、学習ではサンプリングし(領域を学ぶため)、再構成では とし(評価するため)、生成では事前分布から引く(新しく作るため)。- cVAEは両側にラベルを加えるので、何を 生成するかを選べる。
損失の背後にある数学については、ELBOについての別の記事で解説する予定です。次は、ここまでの内容を実践に移し、MNISTでcVAEを学習させてみたいと思います。
参考資料
- Kingma & Welling (2013), Auto-Encoding Variational Bayes:VAEの原論文。
- Kingma & Welling (2019), An Introduction to Variational Autoencoders:同じ著者による、より長く丁寧な解説。
- Doersch (2016), Tutorial on Variational Autoencoders:前提知識をあまり必要としない、直感重視のチュートリアル。
- Higgins et al. (2017), β-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework.
- Lilian Weng, From Autoencoder to Beta-VAE:オートエンコーダの系統全体を簡潔にまとめた概説。