
- ALBとは何か、なぜ便利なのか
- 3つの設定レイヤーと3つの問い
- ターゲットタイプ
- ターゲットを実際に管理しているのは誰か
- ヘルスチェック:トラフィックを受け取るターゲットを決める
- Strobe Assistantでの構成
- 学んだこと
- まとめ
- 参考資料
クラウドコンピューティングの課題でStrobe Assistantのパイプラインを構築したとき、想定以上に重要な役割を担うことになったAWSの構成要素が2つありました。Application Load Balancer(ALB) と、その ターゲットグループ です。それまで私はロードバランサーをブラックボックスとして扱っていました。トラフィックが入って、トラフィックが出ていく、それだけのものです。しかし、そのうち1つがWebSocketを使う3つのコンテナ化されたサービスにALBをつなぎ込むうちに、各構成要素が実際に何をしているのかを掘り下げる必要に迫られました。本稿は、取りかかる前に読んでおきたかった内容をまとめたものです。
本稿はStrobe Assistantシリーズのパート1です。パート2ではECSがタスク、サービス、ターゲットグループをどう結びつけているのかを、パート3ではそのすべての背後にあるACP + MCPパイプラインを解説しています。
ALBとは何か、なぜ便利なのか
Application Load Balancerは、AWS Elastic Load Balancing(ELB)が提供するロードバランサーの種類の1つです。OSI参照モデルのレイヤー7で動作するため、HTTPとHTTPSを理解できます。そのおかげで、レイヤー4のロードバランサー(AWSのNetwork Load Balancerなど)のようにIPアドレスとポートだけでなく、URLのパス、ホスト名、ヘッダー、クエリ文字列、HTTPメソッドに基づいてリクエストをルーティングできます。TLSの終端も行い、WebSocketとHTTP/2にも対応しています。
とはいえ、アプリの前段にALBを置くより本質的な理由は、実際にリクエストを処理するもの、つまりコンテナやEC2インスタンス、Lambda関数が安定していないことにあります。スケールイン・スケールアウトし、クラッシュすれば置き換えられ、デプロイのたびに新しいIPアドレスで立ち上がります。クライアントに必要なのは 動かない単一のアドレス です。ALBはそのアドレスを提供し、その背後に誰がいるのかを裏で把握し続けてくれます。
3つの設定レイヤーと3つの問い
ALBは3つのレイヤーで設定され、それぞれが1つの問いに答えている、と考えると理解しやすくなります:
- リスナー:どこで待ち受けるか? プロトコルとポート(例:HTTPS:443)、そしてHTTPSの場合はTLS証明書。
- ルール:どのリクエストをどこへ送るか? リクエストに対する条件(パス、ホスト、ヘッダー、メソッド、クエリ文字列、送信元IP)と、条件に一致したときに実行するアクション。
- ターゲットグループ:誰が処理し、それは生きているか? ターゲットの集合、ターゲットに到達するためのポートとプロトコル、そしてヘルスチェック。
これらはネットワークのレイヤーではなく、設定 のレイヤーです。ALB全体としてはレイヤー7に位置します。要するに、ALBは受け取ったトラフィックをリスナーのルールと照らし合わせ、(ほとんどの場合)適切なターゲットグループへ転送します。
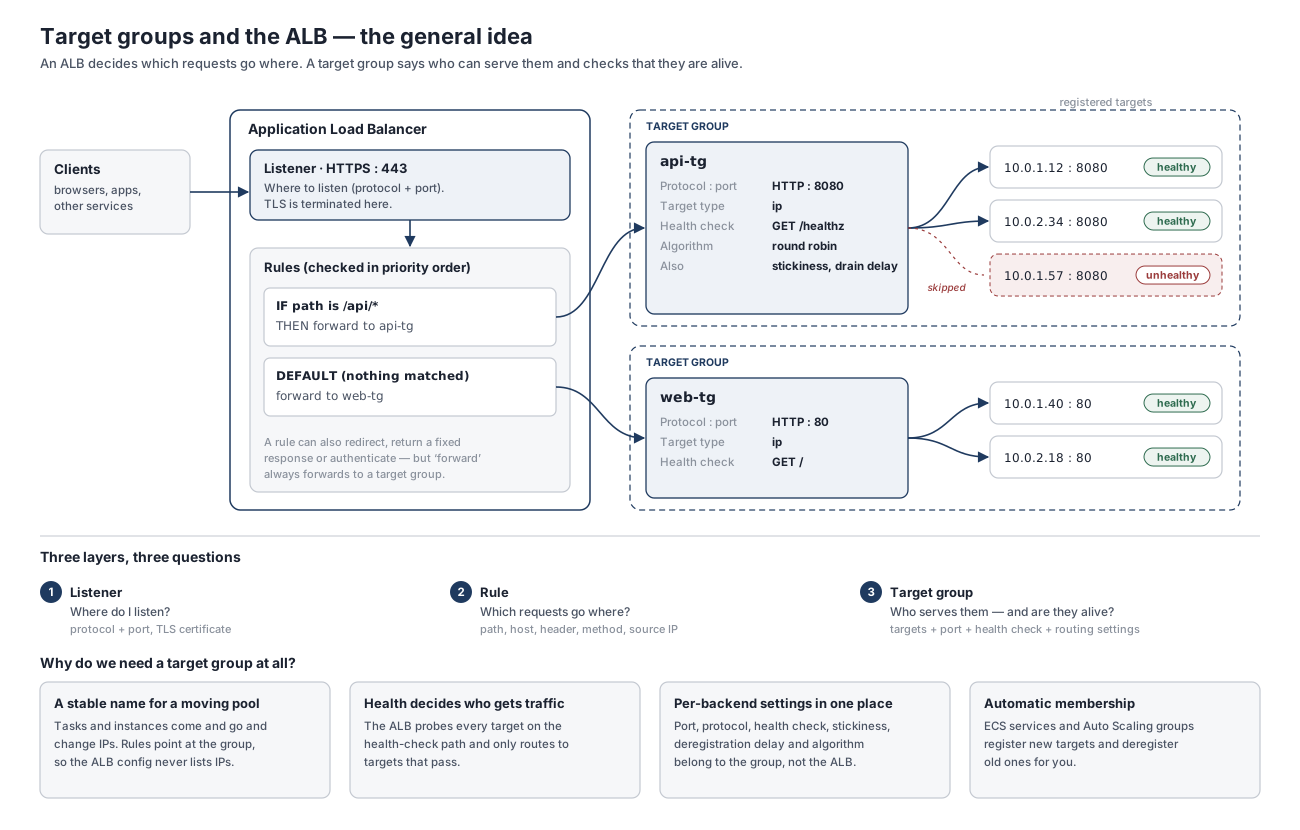
上の例では、ALBはポート443で待ち受け、/api/* 配下のリクエストを api-tg に送り、それ以外はすべてデフォルトルールによって web-tg に流します。その後、各ターゲットグループがリクエストを正常なターゲットのいずれかに渡します。
リスナー
リスナーはALBの玄関口で、指定されたプロトコルとポートで接続を受け付けます。ALBは複数のリスナーを持つことができ、HTTPS:443へリダイレクトするだけのHTTP:80リスナーを置くのがよくあるパターンです。HTTPSリスナーには証明書を設定します。通常はAWS Certificate Manager(ACM)の証明書を使い、TLSはALBで終端されます。そこからターゲットまでのトラフィックは、VPC内では平文のHTTPで流すこともできます(ターゲットグループがHTTPSを使う場合は再暗号化されます)。
リスナールール
各リスナーは、順序付けられたルールのリストを持っています。リクエストが届くと、ALBはルールを 優先度の順、つまり番号の小さいものから大きいものへ 評価し、すべての条件に一致した最初のルールが採用されます。また、どのリスナーにも条件を持たない デフォルトルール があり、これは常に最後に評価され、ほかのルールに一致しなかったものをすべて受け止めます。
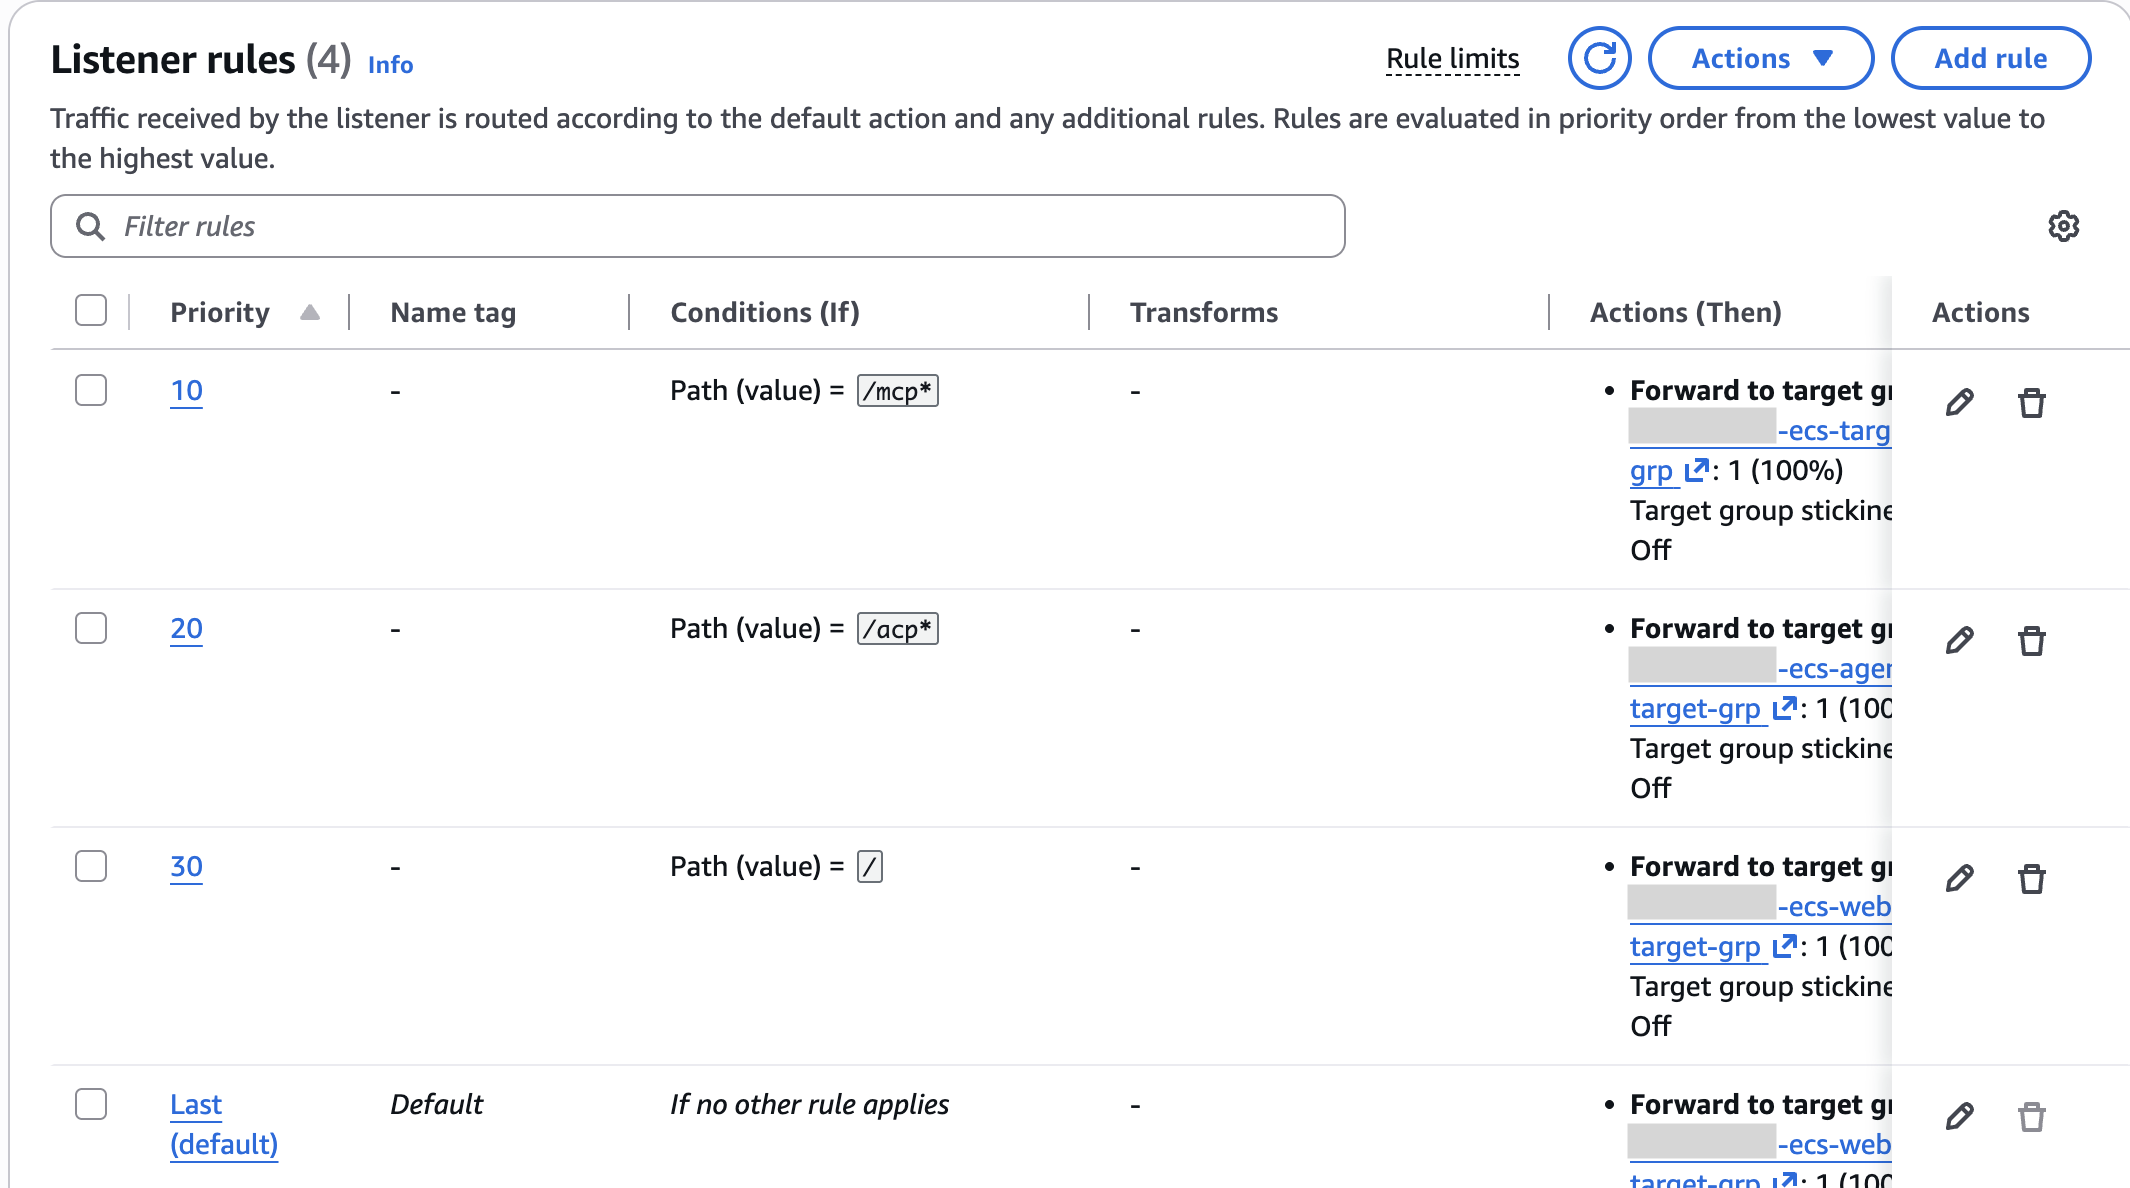
ルールのアクションとして最も多いのは ターゲットグループへの転送 ですが、リクエストを リダイレクト したり(例:HTTP → HTTPS)、固定レスポンス を返したり(メンテナンスページに便利です)、転送の前にAmazon CognitoやOIDCプロバイダーでユーザーを 認証 したりすることもできます。
パス条件については、2つの点でつまずきました。1つ目は、パスパターンは 大文字と小文字を区別 し、クエリ文字列ではなくパスだけと照合されることです。2つ目は、パス条件は リクエストを書き換えない ことです。/api/* のルールは /api/users をそのまま /api/users としてターゲットに転送するため、その背後のサービス側でプレフィックスを扱う必要があります。
ターゲットグループ
ターゲットグループは、プロトコルとポート、ヘルスチェック、ルーティングの挙動といった同じ設定を共有するターゲットに名前を付けたプールです。ルールが指すのは常にターゲットグループであり、個々のサーバーではありません。この間接参照があるからこそ、ALBの設定に誰も手を触れることなく、その下のサーバーを入れ替えられるのです。
ターゲットグループは、見落としがちなルーティング設定もいくつか持っています。ロードバランシングアルゴリズム(デフォルトはラウンドロビン)、登録解除の遅延(離脱するターゲットが処理中のリクエストを処理し続ける時間で、デフォルトは300秒)、スロースタート、そして スティッキーセッション(クライアントを同じターゲットにとどめるCookie)です。
ターゲットタイプ
ターゲットグループを作成するときには ターゲットタイプ を選びます。これは後から変更できません。ALBがサポートしているのは次の3つです:
| ターゲットタイプ | 登録するもの | 主な用途 |
|---|---|---|
instance | EC2インスタンスID | EC2のフリート(多くの場合Auto Scalingグループで管理) |
ip | プライベートIPアドレス(とポート) | 独自のネットワークインターフェースを持つコンテナ(Fargate上のECSタスクなど) |
lambda | 1つのLambda関数 | サーバーレスのHTTPハンドラー |
Strobe Assistantでは、すべてのターゲットグループが ip タイプを使っているため、各ターゲットは単なる task-IP:port です。なぜ instance ではなく ip なのでしょうか。Fargateはタスクを awsvpc ネットワークモードで実行し、各タスクがそれぞれ独自のElastic Network InterfaceとプライベートIPアドレスを持ちます。登録できるEC2インスタンスが存在しないため、AWSはこうしたサービスに ip ターゲットタイプを要求します。(タスクとは何かについてはパート2で説明しています。)
ターゲットを実際に管理しているのは誰か
最初に最も混乱したのがこの部分なので、正確に述べておく価値があります。ターゲットグループはリストであって、管理者ではありません。 何かを起動したり、停止したり、置き換えたりすることは一切ありません。
ECSの構成では、管理者は ECSサービス です。ECSサービスはタスクを起動・停止し、新しいタスクが起動するとその IP:port をターゲットグループに登録し、タスクが停止すると登録を解除します。ターゲットのリストを手作業で編集することはありません。ECS以外では、EC2のAuto Scalingグループが同じ役割を果たすか、自分でターゲットを登録します。
ただし、この関係は双方向でもあります。ECSはターゲットグループのヘルスチェックも監視しており、タスクがヘルスチェックに失敗すると、そのタスクを停止して代わりのタスクを起動します。つまり、ターゲットグループはターゲットを管理してはいないものの、その健全性の判定はECSサービスが行動を起こすシグナルの1つになっているのです。
ヘルスチェック:トラフィックを受け取るターゲットを決める
ロードバランサーは、ターゲットグループに定義されたヘルスチェックの設定に従って、登録されたすべてのターゲットに定期的にリクエストを送ります。新しいリクエストを受け取るのは healthy(正常)状態のターゲットだけです。instance と ip ターゲットのデフォルト値は次のとおりです:
| 設定 | デフォルト |
|---|---|
| パス | / |
| 間隔 | 30秒 |
| タイムアウト | 5秒 |
| 正常のしきい値 | 5回連続で成功 |
| 非正常のしきい値 | 2回連続で失敗 |
| 成功コード | 200 |
ターゲットは、そのライフサイクルの中で少数の状態を移り変わります:
- initial:登録された直後で、最初のヘルスチェックが進行中のため、まだトラフィックは受け取りません。
- healthy:ヘルスチェックに合格しており、トラフィックを受け取ります。
- unhealthy:非正常のしきい値の回数だけ連続でチェックに失敗しており、新しいトラフィックは受け取りません。
- draining:登録解除の途中で、新しいリクエストは受け取りませんが、処理中のリクエストは登録解除の遅延が切れるまで完了させることができます。
下の図の最初のバージョンで私が間違えていた細かな点があります。新しく登録された ターゲットは、1回 ヘルスチェックに合格するだけでhealthyになります。正常のしきい値が適用されるのは、unhealthy状態から回復しようとしているターゲットです。
次の図は、1つのFargateタスクがターゲットグループの中でたどるライフサイクルを示しています:
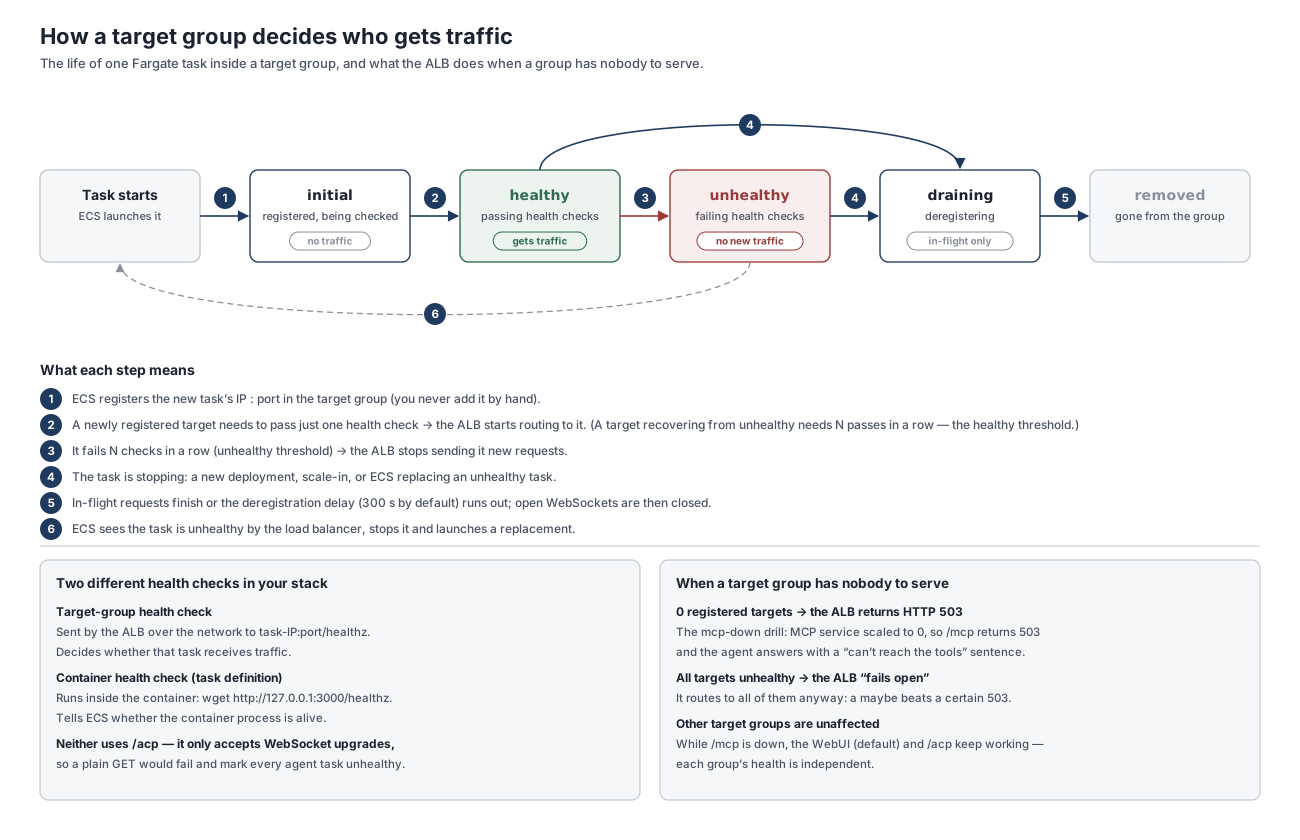
知っておくべきエッジケースが2つあります。いずれ遭遇するエラーコードの理由を説明してくれるからです:
- 登録されたターゲットがない → HTTP 503。 ルールの背後にあるターゲットグループが空の場合、ALBには転送先がないため
503 Service Unavailableを返します。 - すべてのターゲットがunhealthy → ALBはフェイルオープンする。 直感に反しますが、グループ内のすべてのターゲットがunhealthyの場合、ALBはそれでも全ターゲットにルーティングします。確実にエラーになるよりは、もしかしたら 成功するほうがましだという考え方です。ヘルスチェックが守ってくれるのは 一部の 不良ターゲットからであり、完全に壊れたサービスからではありません。
また、健全性はターゲットグループごとに管理されるため、1つのグループがダウンしてもほかのグループには影響しません。
Strobe Assistantでの構成
Strobe Assistantは3つのサービスで構成されており、それぞれがFargate上の独立したECSサービスとして動いています:
- WebUI:nginxが配信する静的ファイル
- エージェント(TypeScript):ブラウザとWebSocket上のAgent Client Protocol(ACP)で通信し、Bedrockのツール呼び出しループを実行する
- MCPサーバー(FastMCP):ツールを公開し、S3 Vectors、DynamoDB、StrobeのAPIにアクセスする唯一のコンポーネント
3つすべてがインターネット向けの1つのALBの背後にあり、ポート443の単一のHTTPSリスナーと次のルールを持っています:
| ルール | 条件 | 転送先 | ターゲットポート |
|---|---|---|---|
| パスルール | パスが /acp* | エージェントのターゲットグループ | 3000 |
| パスルール | パスが /mcp* | MCPサーバーのターゲットグループ | 8080 |
| デフォルト | それ以外すべて(/、/index.html、/assets/*) | WebUIのターゲットグループ | 80 |
2つのパスパターンは重ならないため、互いの優先度は問題になりません。それ以外のものはすべてデフォルトルールが受け止めます。Route 53のエイリアスレコードが独自ドメインをALBに向け、リスナーに設定したACM証明書がTLSを終端します。これによって、HTTPSのページから wss:// が使えるようになっています。
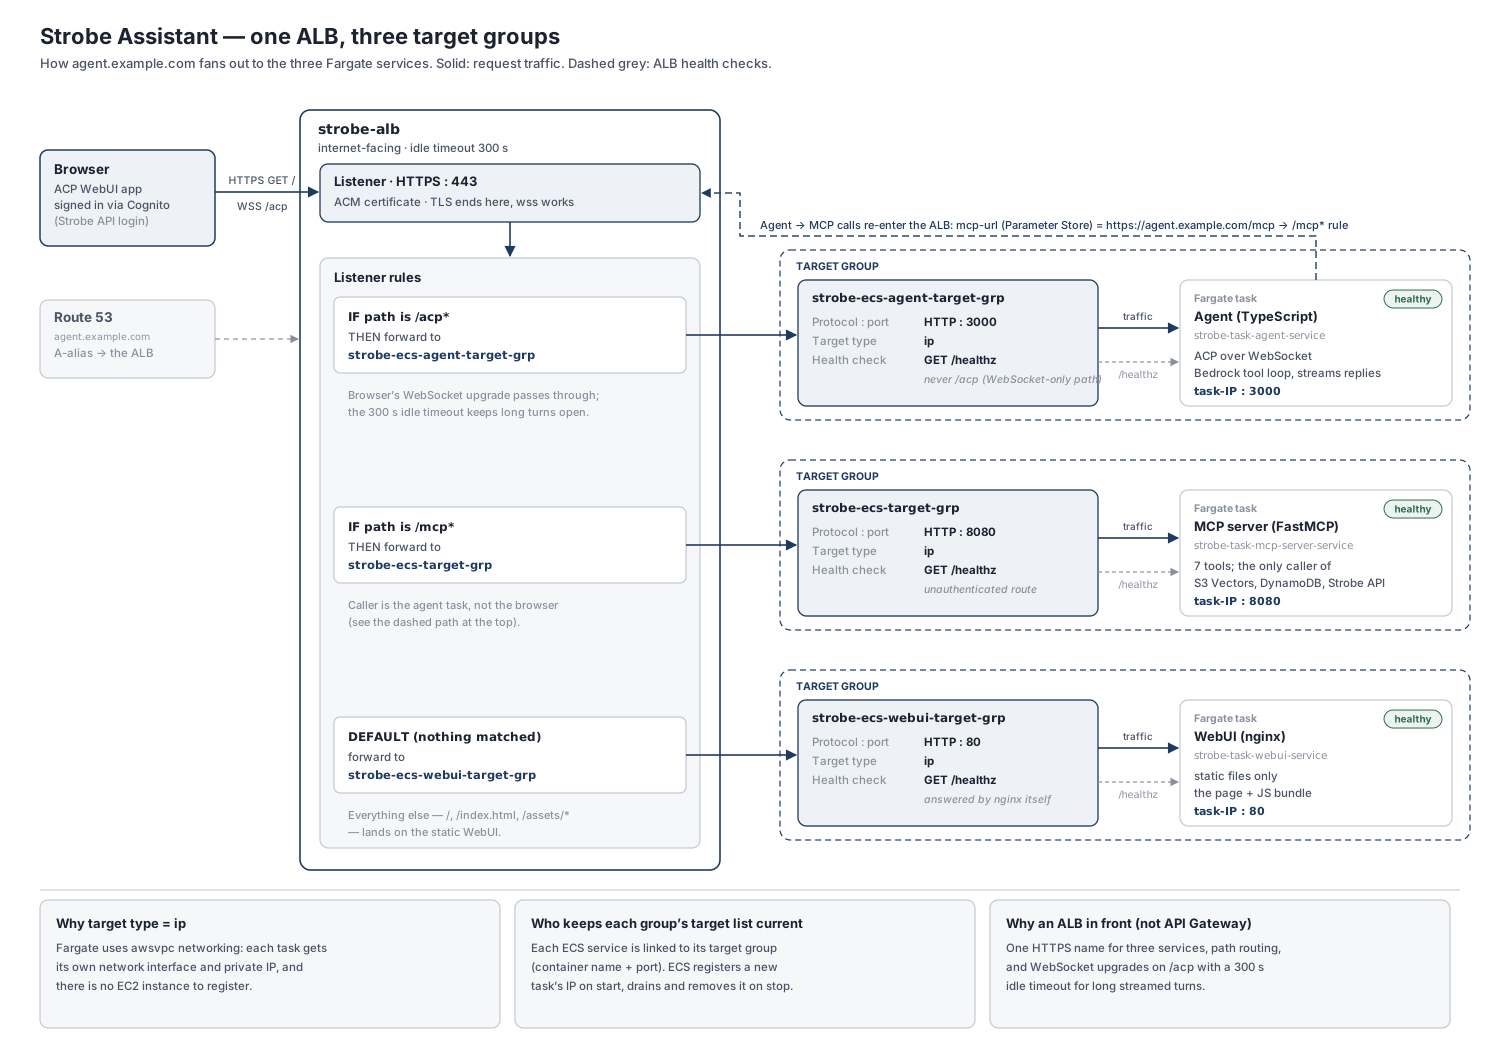
設計上の判断のうち、いくつか触れておきたいものがあります:
- API GatewayではなくALBを選んだ理由。 API GatewayのHTTP APIはWebSocketのアップグレードをプロキシできず、別のWebSocket APIはルートベースのため、ACPのJSON-RPCメッセージをそれに合わせて組み替える必要がありました。ALBはWebSocketをネイティブにプロキシでき、3つのサービスすべてに対して1つのHTTPSの名前を提供してくれます。
- アイドルタイムアウトを60秒から300秒に引き上げ。 ALBは、アイドルタイムアウトの間データのやり取りがない接続を閉じます。エージェントのやり取りはツールの実行中に無通信になることがあるため、タイムアウトを引き上げ、さらにエージェントが30秒ごとにpingを送ってWebSocketを維持するようにしました。
- ヘルスチェックは
/healthzに送り、/acpや/mcpには決して送らない。/acpはWebSocketのアップグレードしか受け付けず、/mcpはトークンを必要とするため、そこへの単純なGETは失敗し、すべてのタスクがunhealthyと判定されてしまいます。そうなると、ECSは正常なタスクを停止しては置き換え続けることになります。そこで各サービスは、軽量で認証不要な/healthzを公開しています。WebUIの場合はnginxが直接応答します。 - エージェントはALBを経由してMCPサーバーを呼び出す。 Parameter Storeに保存しているMCPのURLは公開アドレスの
https://…/mcpなので、エージェントからMCPへの呼び出しはロードバランサーに再び入り、/mcp*ルールに一致します。シンプルで同じTLSの玄関口を再利用できますが、その代わりにホップが1つ増えます。より大規模な環境では、ECS Service Connectや内部ALBのほうがすっきりした選択肢になるでしょう。 - 障害時の経路をテストする。 MCPサービスのタスク数をゼロにするとそのターゲットグループが空になり、WebUIと
/acpが動き続ける一方で、/mcpは503を返します。エージェントはクラッシュするのではなく、それを「ツールに到達できません」という応答に変えます。各ターゲットグループの健全性が独立していることを示す良い例です。
学んだこと
もう一度最初から始めるとしたら、自分に次のことを伝えたいと思います:
- ヘルスチェックのパスは意図的に選ぶ。 軽量で認証不要であるべきで、WebSocketやストリーミングのエンドポイントであってはいけません。
- デプロイを速くするためにヘルスチェックを調整する。 デフォルト値のままだと、unhealthyになったターゲットが再びトラフィックを受け取るには、5 × 30秒 = 2.5分間チェックに合格し続ける必要があります。AWSのECS向けガイダンスでは、起動の速いサービスには間隔5秒、しきい値2程度が推奨されています。これをECSサービスのヘルスチェック猶予期間と組み合わせれば、起動の遅いタスクが準備できる前に停止されることを防げます。
- ワイルドカードに注意する。
/acp*は/acpや/acp/anythingに一致しますが、/acpxにも一致します。ここでは問題ありませんが、/api/*と/api*は同じルールではありません。 - ALBからのアクセスだけを許可する。 ALBのセキュリティグループはインターネットに対して443を開放しています。パブリックサブネットにあってパブリックIPを持つタスクは、そのままでは直接アクセスできてしまうため、タスクのセキュリティグループはALBのセキュリティグループからのコンテナポートへのアクセスだけを受け付けるべきです(ネットワーキングとVPCを参照)。
- メモリ上のセッションはスケーリングを制限する。 エージェントはセッションの状態をメモリ上に保持しているため、エージェントのタスクを複数動かすには、ターゲットグループのスティッキーセッションか、DynamoDBのような外部のセッションストアが必要になります。
まとめ
各構成要素の関係が腑に落ちてみると、ALBはきれいな役割分担になっていました。リスナーはどこで待ち受けるかを決め、ルールは各リクエストの行き先を決め、ターゲットグループは誰がリクエストを処理でき、それが生きているかを把握し、ECSサービスがそのリストを最新の状態に保ちます。パート2では、この最後の部分に焦点を当て、ECSがタスク、サービス、ターゲットグループをどう結びつけているのかを見ていきます。
参考資料
- What is an Application Load Balancer?:ロードバランサー、リスナー、ルール、ターゲットグループに関するAWSの概要。
- Target groups for your Application Load Balancers:ターゲットタイプ、ルーティングアルゴリズム、登録解除の遅延、スロースタート、スティッキーセッション。
- Health checks for Application Load Balancer target groups:デフォルト設定、ターゲットの健全性の状態、フェイルオープンの挙動。
- Listener rules for your Application Load Balancer:ルールの優先度、アクション、条件。
- Use an Application Load Balancer for Amazon ECS:
awsvpcのタスクにipターゲットタイプが必要な理由と、ECSがタスクを登録する仕組み。 - Optimize load balancer health check parameters for Amazon ECS:デプロイを速くするための実践的な調整のアドバイス。