
- 設計図:コンテナイメージとタスク定義
- 管理者:ECSサービス
- 実行中のコピー:Fargate上のタスク
- 引き渡し:タスクがターゲットになるまで
- それぞれの役割
- Strobeの3つのサービスを並べて見る
- まとめ
- 参考資料
Strobe Assistantの3つのサービス(WebUI、エージェント、MCPサーバー)は、それぞれがFargate上の独立したECSサービスとして動いています。パート1では、ALBとそのターゲットグループをロードバランサーの側から見ました。本稿ではその反対側、つまりECSがコンテナイメージをどのように実行中のタスクに変えるのか、そしてそのタスクがどのようにしてALBのトラフィックの送り先となるターゲットになるのかを見ていきます。
本稿はStrobe Assistantシリーズのパート2です。続くパート3では、これらすべての上で動くACP + MCPパイプラインを解説しています。
最初は用語に混乱しました。コンテナイメージ、タスク定義、タスク、コンテナ、サービス、クラスター、ターゲットグループは、どれも同じものを指していてもおかしくないように聞こえますし、AWSのコンソールもその境界をわかりやすく示してはくれません。そこで用語を書き出し、1つずつAWSのドキュメントで調べ、互いの関係を説明できるようになるまでコンソールで実際に触ってみました。結果的に、それがデプロイ全体の仕組みを理解する鍵になりました。下の図はその成果で、エージェントを例にしています:
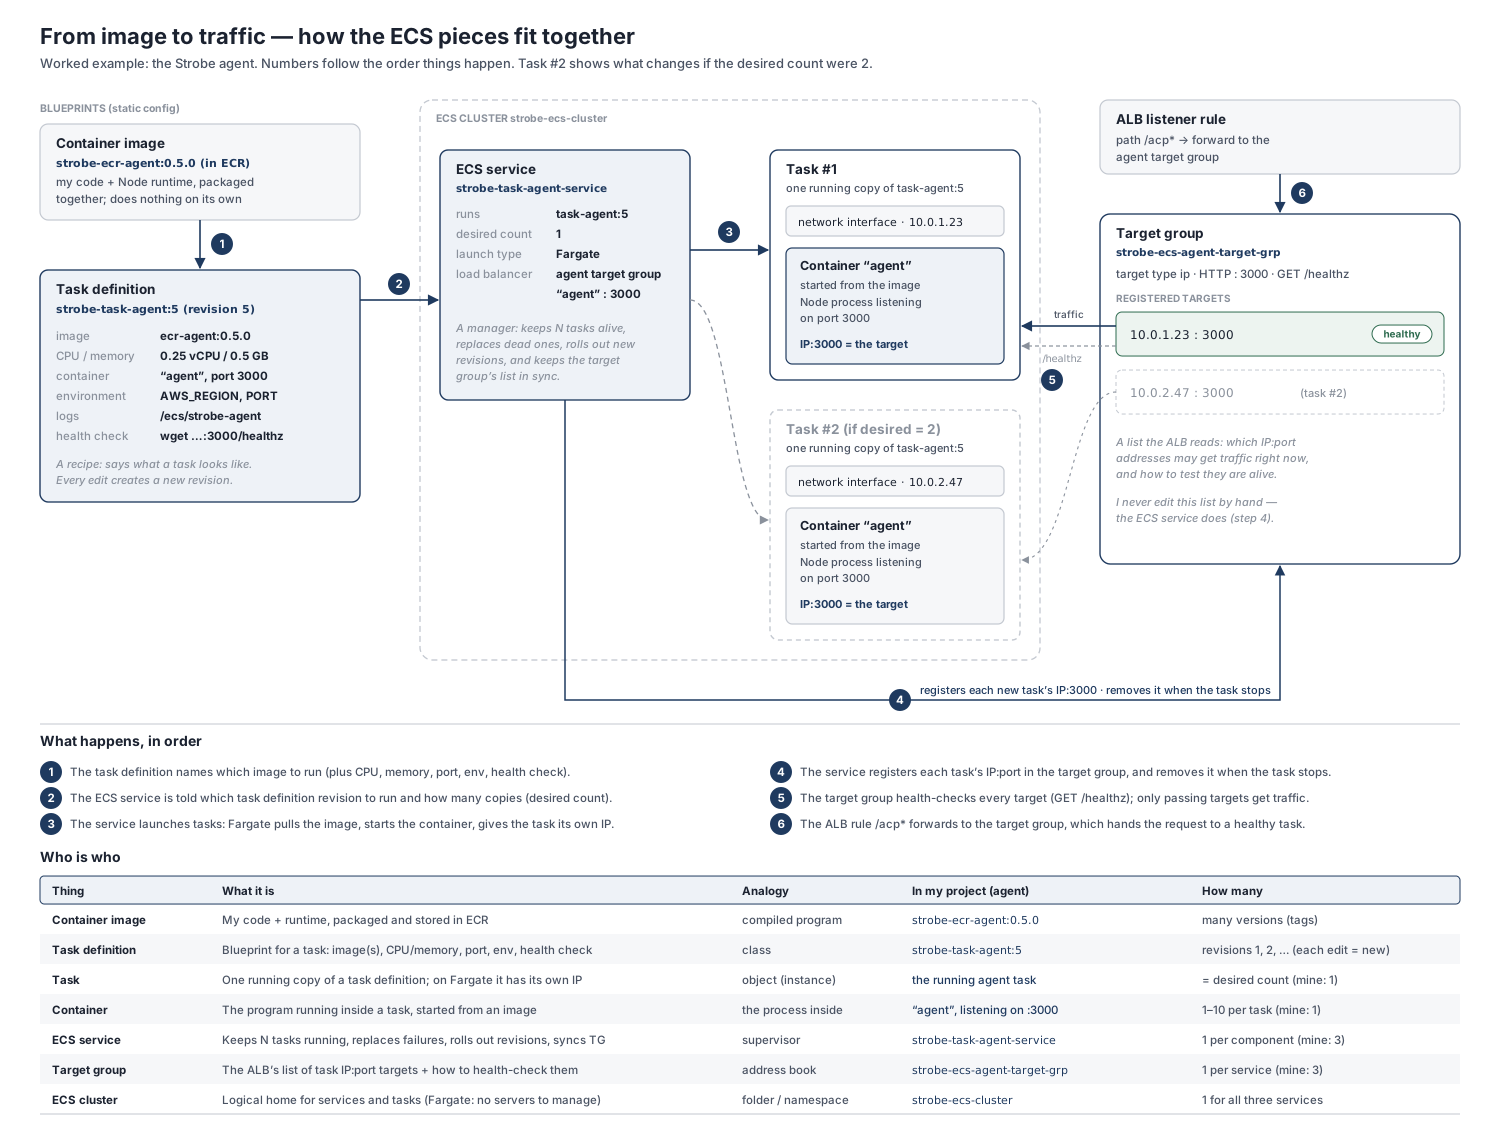
図の番号は、処理が起こる順序に沿っています。本稿の残りでは、それらを4つのグループに分けて順に見ていきます。設計図、管理者、実行中のコピー、そしてALBへの引き渡しです。
設計図:コンテナイメージとタスク定義
すべては コンテナイメージ から始まります。私のコード、そのランタイム、依存関係をひとまとめにパッケージ化し、バージョンタグを付けてAmazon ECRに保存したものです(エージェントの場合は ecr-agent:0.5.0)。イメージはそれ自体では何もしません。実行もしなければ、リクエストを待ち受けることもなく、コンピューティングのコストもかかりません。あくまで起動の出発点にすぎないのです。
タスク定義 は、実行中のタスクがどうあるべきかを記したレシピです。どのイメージを使うか、CPUとメモリをどれだけ確保するか、各コンテナがどのポートで待ち受けるか、環境変数、ログの出力先、そして任意のコンテナヘルスチェックを定義します。1つのタスク定義には最大10個のコンテナを記述できますが、私のタスク定義はどれもコンテナが1つだけです。
私にとって最も助けになったのは、タスク定義が イミュータブル(不変) だという点でした。編集するたびに新しい リビジョン(task-agent:1、task-agent:2、…)が作られ、サービスは常に特定の1つのリビジョンを指します。つまり「新しいバージョンをデプロイする」とは、実際には2つのステップを意味します。新しいイメージをプッシュし、そのイメージを参照するリビジョンを登録して、サービスにそのリビジョンを使うよう指示することです。
管理者:ECSサービス
ECSサービス は、すべてが動き出す場所です。長時間稼働し続ける管理者で、3つの重要な設定を持っています:
- どのタスク定義リビジョンを、いくつ実行するか(必要なタスク数、desired count)。 タスクがクラッシュしたり、停止したり、ヘルスチェックに失敗したりすると、サービススケジューラが代わりのタスクを起動して、必要なタスク数に戻します。サービスに新しいリビジョンを指定すると、新しいタスクを起動して古いタスクを退役させることで、変更を順次展開していきます。私はどのサービスも必要なタスク数を1にしていました。課題にはそれで十分ですし、そもそもエージェントはACPのセッションをメモリ上に保持しているので、2つ目のエージェントタスクを動かすには、先にスティッキーセッションか外部のセッションストアが必要になります(パート3を参照)。
- タスクをどこで実行するか(起動タイプ)。 私はサーバーレスの選択肢である Fargate を選びました。プロビジョニングやパッチ適用、サイズ調整が必要なEC2インスタンスはなく、各タスクが確保するCPUとメモリの分だけ料金を払えば済みます。ただし、自分のメモを1つ訂正しておきます。私はFargateが「自動的にスケールする」と書いていました。少なくとも、負荷に応じてタスクを追加するという意味では、そうではありません。Fargateはサービスが求めるタスクのための計算資源を確保してくれますが、タスクの 数 を変えるのは、必要なタスク数、あるいは設定していればService Auto Scalingの役割です。
- どのロードバランサーのターゲットグループを使うか。 コンテナ名とポートからターゲットグループへの対応づけとして設定します(エージェントの場合は、ポート3000のコンテナ
agent→ エージェントのターゲットグループ)。このたった1行の設定こそが、ECSとALBを結びつけているものです。そもそもなぜサービスをALBの背後に置くのかについては、パート3で取り上げています。
サービスを収める クラスター は、名前から受ける印象ほど面白いものではありません。Fargateの場合、クラスターは単なる論理的なグループ、つまりサービスとタスクのための名前空間です。トラフィックがクラスターを「通過」することはありません。
実行中のコピー:Fargate上のタスク
タスク はタスク定義リビジョンの実行中のコピー1つであり、コンテナ はその中で動いている、イメージから起動されたプロセスです。タスク定義をクラスと考えるなら、タスクはオブジェクトにあたります。いくつでも作ることができ、それぞれが独立して生成され、動き、終了します。
Fargateのタスクはawsvpc ネットワークモードを使うので、小さなVMと同じように、各タスクが独自のElastic Network Interface(ENI)とプライベートIPアドレスを持ちます。ここから2つのことが導かれます。第一に、ALBが宛先にする必要があるのはホストマシンではなくタスクそのものであり、だからこそターゲットグループは ip ターゲットタイプを使っています(パート1を参照)。第二に、タスクは 起動するたびに新しいIPを得ます。ECSの外側にあるものが手作業でそれを追跡し続けることはできません。まさにこの問題を解決するのが、次のステップです。
引き渡し:タスクがターゲットになるまで
私が何度も立ち返った疑問は、ECSはタスクを作成してからそのタスクのターゲットを登録するのか、だとしたらどんな順序なのか、というものでした。答えはイエスで、その順序はかなり整然としています。驚いたのは、ALBとECSサービスが互いを直接参照することは一度もないという点です。リスナールールは「/acp* をエージェントのターゲットグループに送る」と言い、サービスは「自分のタスクをエージェントのターゲットグループに入れる」と言います。ターゲットグループが両者の接点 なのです:
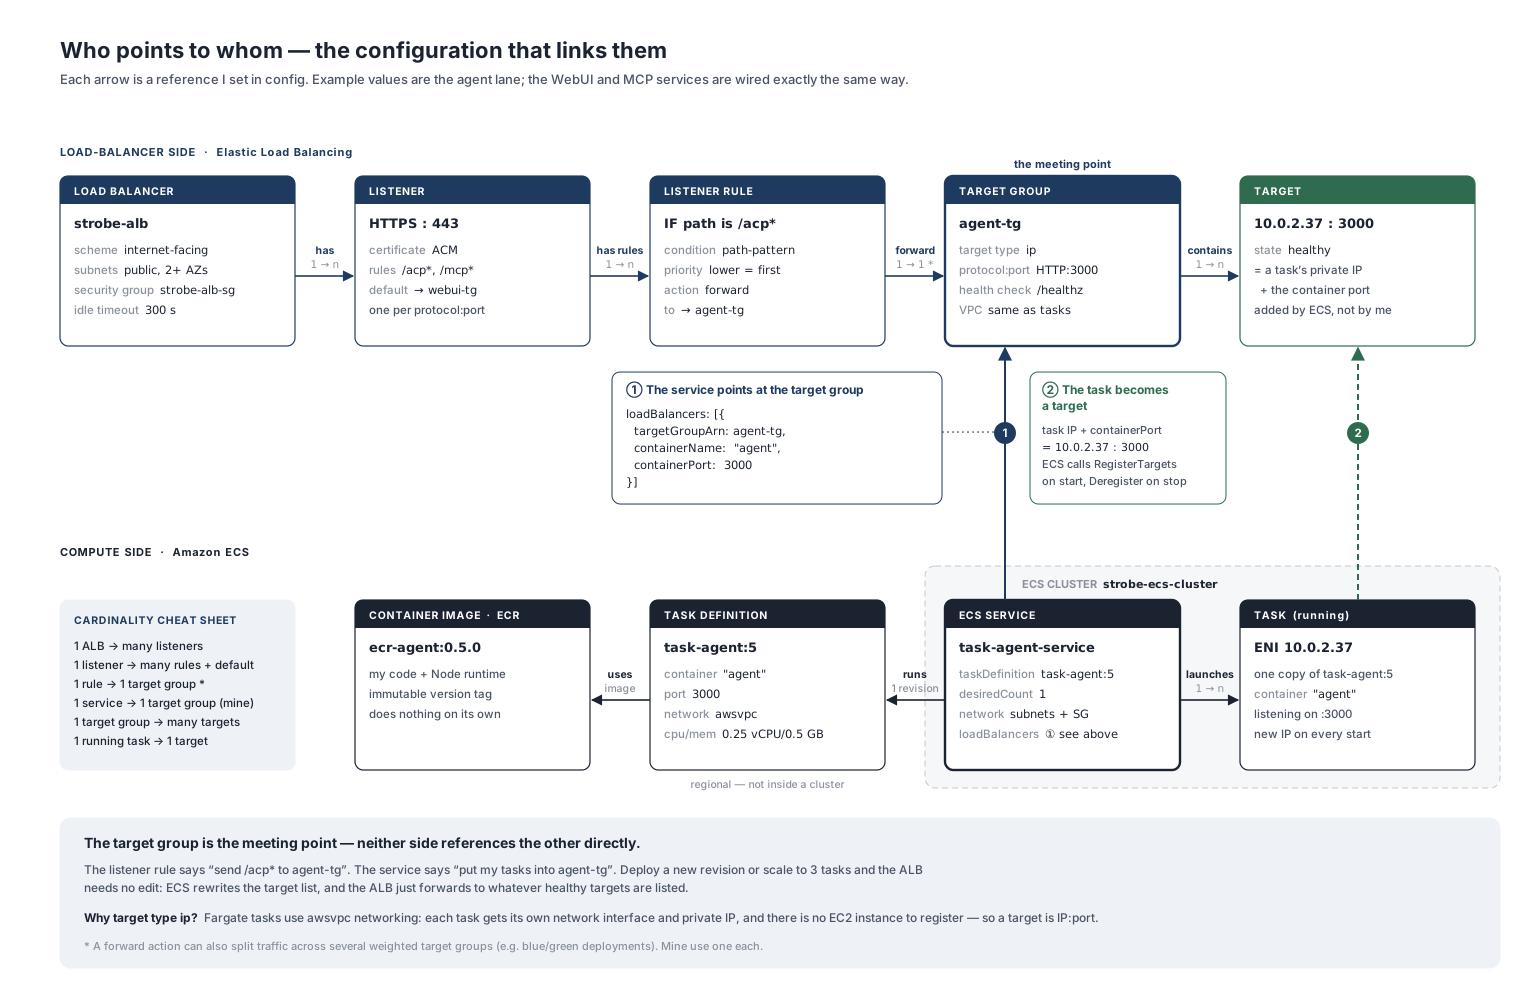
1つのタスクをライフサイクルに沿って追いかけると、流れは次のようになります:
- 起動。 サービスが、タスクが必要だと判断します(必要なタスク数を満たすため、失敗したタスクを置き換えるため、または新しいリビジョンを展開するため)。FargateがENIとプライベートIPをプロビジョニングし、イメージをプルしてコンテナを起動します。
- 登録。 タスクがまだ アクティベート中 の間に、ECSはサービスにリンクされたロールを使って、そのタスクの
IP:portをターゲットグループに登録します。私がこのリストを自分で編集することはありません。 - ヘルスチェック。 新しいターゲットは
initial状態から始まります。ALBは/healthzに対してヘルスチェックを行い、それに合格して初めてターゲットはhealthyになり、トラフィックを受け取り始めます。サービスにヘルスチェック猶予期間を設定しておけば、起動の遅いコンテナがまだ立ち上がっている間に、ECSが失敗したチェックに反応してしまうのを防げます。 - 処理。 リスナールールが条件に一致するリクエストをターゲットグループに転送し、ターゲットグループが正常なターゲットを1つ選びます。
- 退役。 タスクが停止されるとき(スケールイン、新しいデプロイ、またはヘルスチェックの失敗による)、ECSはまずターゲットの登録を解除します。ターゲットは
draining状態になり、新しいリクエストは受け取らないものの処理中のリクエストは完了させることができ、その後でようやくコンテナが停止されます。
ここでは、健全性は双方向のシグナルになっています。実はチェックは2つあります。タスク定義にあり、ECSがコンテナ内部で実行する コンテナヘルスチェック と、ALBがネットワーク越しに実行する ターゲットグループのヘルスチェック です。Strobeでは、どちらも /healthz にアクセスします。どちらかが失敗すると、サービススケジューラがタスクを置き換え、それに伴って古いターゲットの登録が解除され、新しいターゲットが登録されます。つまり、ターゲットグループは何も管理していませんが、その判定はECSが行動を起こすシグナルの1つになっているのです。
こうした仕組みのおかげで、ALBにまったく手を触れることなく、新しいリビジョンをデプロイしたり、サービスをスケールアップ・スケールダウンしたりできます。ECSがターゲットのリストを最新の状態に保ち、ALBはそこに載っている正常なターゲットに転送するだけです。
それぞれの役割
流れが腑に落ちてからは、たとえの表を作ると用語が定着しやすくなりました:
| もの | たとえ | Strobeでは(エージェント) |
|---|---|---|
| コンテナイメージ | コンパイル済みのプログラム | ECR内の ecr-agent:0.5.0 |
| タスク定義 | クラス(番号付きのリビジョンを持つ) | task-agent:5 |
| タスク | オブジェクト(インスタンス) | 独自のプライベートIPを持つ、実行中のエージェントタスク |
| コンテナ | オブジェクトの中のプロセス | ポート3000で待ち受ける agent |
| ECSサービス | 監督者 | エージェントタスクを1つ動かし続け、ターゲットグループと同期させる |
| ターゲットグループ | アドレス帳 | エージェントの正常な IP:3000 ターゲットのリスト |
| クラスター | フォルダーまたは名前空間 | 3つのサービスすべてで1つのクラスター |
Strobeの3つのサービスを並べて見る
WebUIとMCPサーバーも、エージェントとまったく同じ方法でつながっています。違うのはイメージ、ポート、ターゲットグループだけです:
| サービス | 実行するもの | コンテナポート | ALBのルール |
|---|---|---|---|
| WebUI | ビルド済みの静的UIを配信するnginx | 80 | デフォルト(それ以外すべて) |
| エージェント | Node.jsのACPサーバーとBedrockのツールループ | 3000 | /acp* |
| MCPサーバー | PythonのFastMCPツールサーバー | 8080 | /mcp* |
それぞれが独自のタスク定義(infra/taskdef-*.json に保存)、必要なタスク数が1の独自のECSサービス、そして独自のターゲットグループを持ち、すべてが1つのALBの背後にある1つのクラスターに収まっています:
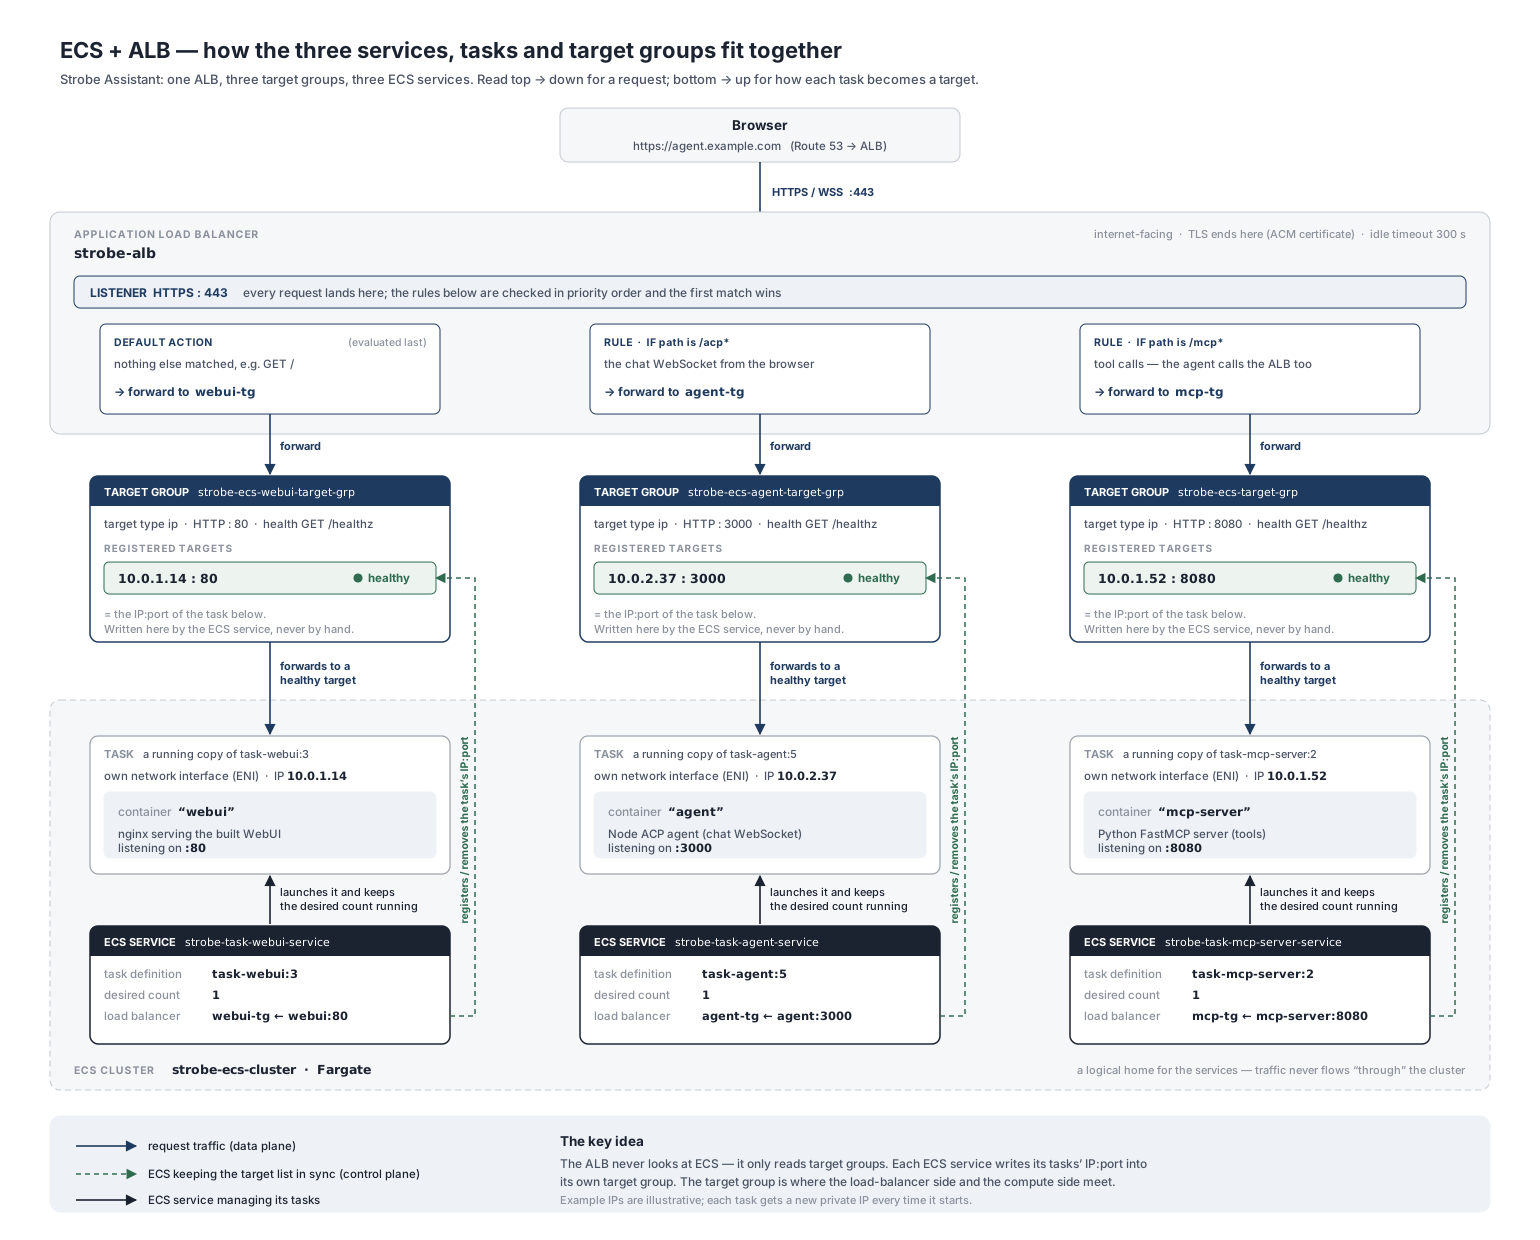
3つのサービスが共有しているのはALBとクラスターだけなので、1つを再デプロイしたり、スケールしたり、停止したりしても、ほかのサービスには影響しません。障害時の挙動をテストするときには、この性質に頼りました。MCPサービスをゼロにスケールするとそのターゲットグループは空になり、WebUIとエージェントは動き続けたまま、/mcp は503を返します。
まとめ
ECSが腑に落ちたきっかけは、何を実行するか、それを動かし続けること、そこへルーティングすること を切り分けて考えたことでした。イメージとタスク定義は静的な設計図、サービスは適切な数のタスクを生かし続ける管理者、タスクは使い捨ての実行中のコピー、そしてターゲットグループはECSとALBが出会う場所です。ターゲットのリストを最新に保っているのが、私でもALBでもなくサービスだとわかってからは、アーキテクチャの残りの部分もずっと考えやすくなりました。
パート3では一段上のレベルに移り、これらのタスクの中で実際に何が動いているのか、つまりチャットUI、エージェント、ツールをつなぐACP + MCPパイプラインを見ていきます。
参考資料
- What is Amazon Elastic Container Service?:ECSの概念の概要。
- Amazon ECS task definitions:タスク定義に含まれるものと、リビジョンの仕組み。
- Amazon ECS services:必要なタスク数、サービススケジューラ、正常でないタスクが置き換えられる仕組み。
- Amazon ECS task lifecycle:タスクの状態と、ターゲットの登録・登録解除が起こるタイミング。
- Amazon ECS task networking for Fargate:各タスクが独自のENIとプライベートIPを持つ理由。
- Use an Application Load Balancer for Amazon ECS:ECSがタスクをターゲットグループに登録する仕組み。
- Determine Amazon ECS task health using container health checks:コンテナヘルスチェックと、それがタスクの健全性をどう判定するか。
- Deploy Amazon ECS services by replacing tasks:ローリングアップデートで古いタスクが新しいタスクに置き換わる仕組み。