
- パイプラインを一段落で
- 原因はファイルサイズではなく、ピクセル数の上限だった
- そもそも、なぜ気づけたのか
- 失敗を黙って削除してしまう設定
- 3秒のタイムアウト
- 上限はクォータ
- 今ならどう変えるか、そしてほかへの応用
Strobe Assistantの検索評価のために写真を登録していたとき、取り込みパイプラインのデッドレターキュー(DLQ)を確認しました。中には18件のメッセージがあり、そのすべてが私のスマートフォンで撮った写真でした。
Strobe Assistantは、ユーザー自身の写真ライブラリを対象にしたチャットエージェントです(システム全体はプロジェクトの概要にまとめています)。写真を検索できるようにするには、アップロード後にその写真を埋め込み、分類する必要があり、その処理は非同期のパイプラインで行われます。本稿はそのパイプラインについての記事です。何がうまくいかなかったのか、なぜそれに気づけたのか、そして失敗が見えるか、黙って失われるかを分ける設定の細部について書きます。
パイプラインを一段落で
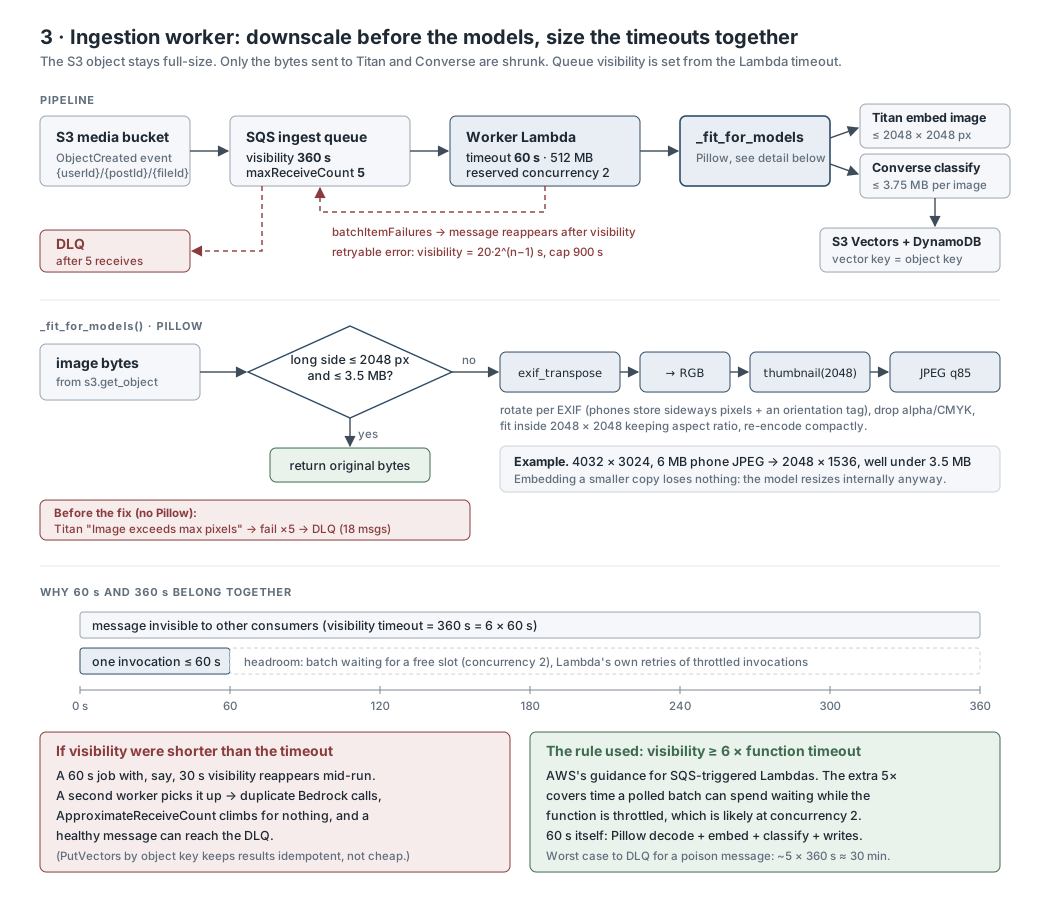
写真は署名付きURLを使ってブラウザからS3へ直接送られるため、アップロードはすぐに完了します。その後、S3がObjectCreatedイベントをSQSキューに発行し、投稿Lambdaも、誰かが投稿やコメントを書くたびに同じキューへテキストのジョブを追加します。ワーカーのLambdaは、メッセージを最大10件ずつのバッチで受け取ります。写真ごとに、Titan Multimodalで埋め込みを、Gemma 3でキャプションとラベルを生成し、S3 VectorsとDynamoDBに書き込みます。失敗し続けるメッセージは間隔を広げながら再試行され、5回試してもだめなら、SQSがそれをDLQへ移します。
原因はファイルサイズではなく、ピクセル数の上限だった
答えはワーカーのログにありました。ValidationException: Image exceeds max pixels allowedです。Titan Multimodalが受け付ける画像は最大2,048 × 2,048ピクセルで、BedrockのConverse APIは1枚の画像を3.75 MBまでに制限しています。4,000 × 3,000のスマートフォン写真は、ファイルサイズに関係なく1つ目の上限に引っかかります。つまり私は、見るべきでない数字を見ていたのです。どの写真も5回失敗し、試行の合間にバックオフしたうえで、DLQへ移っていました。
テストではこの問題に一度も当たりませんでした。元のStrobeアプリを作っていたときに使ったテストデータは、ウェブ上の小さな画像だったからです。実際のデータでしか表に出ない制約の、よい例だと思います。
修正では、保存するものではなく、モデルに渡すものを小さくしました。ワーカーは、どちらのモデルを呼ぶ前にも画像を確認します。長辺が2,048ピクセルを超えるか、ファイルが3.5 MBを超える場合は、EXIFの向きを適用し(スマートフォンは画素を横向きのまま保存し、回転のタグを付けています)、RGBに変換し、2,048 × 2,048に収まるよう縮小して、JPEGとして再エンコードします。S3上の元の画像には手を付けません。縮小したコピーを埋め込んでも、実用上は何も失われません。モデルはどのみち内部で入力を縮小するからです。
そもそも、なぜ気づけたのか
非同期の設計は、どれも必ずどこかで処理をバッファリングしています。問題は、そのバッファを誰が持っているかです。
- アップロードのリクエスト内で処理する場合: バッファはユーザーです。ユーザーは写真1枚ごとにモデルの呼び出し2回分を待たされ、失敗すれば画面にエラーが出ます。
- S3が直接Lambdaを呼び出す場合: バッファはLambdaが、中身を確認できない内部キューとして持っています。関数のエラーは2回再試行され、スロットリングされた呼び出しは最大6時間再試行されます。その後、イベントは失敗時の送信先が設定されていればそこへ送られ、設定されていなければ破棄されます。
- S3からSQS、そしてLambdaへ流す場合: バッファは私が持ちます。再試行の回数とバックオフを自分で決められ、滞留しているメッセージの数や最も古いメッセージの経過時間を確認でき、失敗したものはDLQで待機するので、中身を調べてから再投入(リドライブ)できます。
S3がワーカーを直接呼び出す構成だったら、あの18枚は2回再試行されたあと、失敗時の送信先も設定されていないまま破棄されていたはずです。私がそれに気づくのはずっと後、検索でスマートフォンの写真がまったく見つからないときだったでしょう。キューがあったおかげで、写真はDLQに残っていました。受信回数もログのエラーもそろっていて、修正をデプロイしたらいつでもリドライブできる状態でした。
キューが役に立つ理由はもう1つあります。取り込みの本当の上限はLambdaではなく、Bedrockのクォータです。写真1枚につきモデルの呼び出しが2回あり、それがアカウント全体で共有される1分あたりのリクエスト数の上限にぶつかります。そしてアップロードはバースト的に発生します。誰かがアルバムを丸ごと1分で共有することもあります。
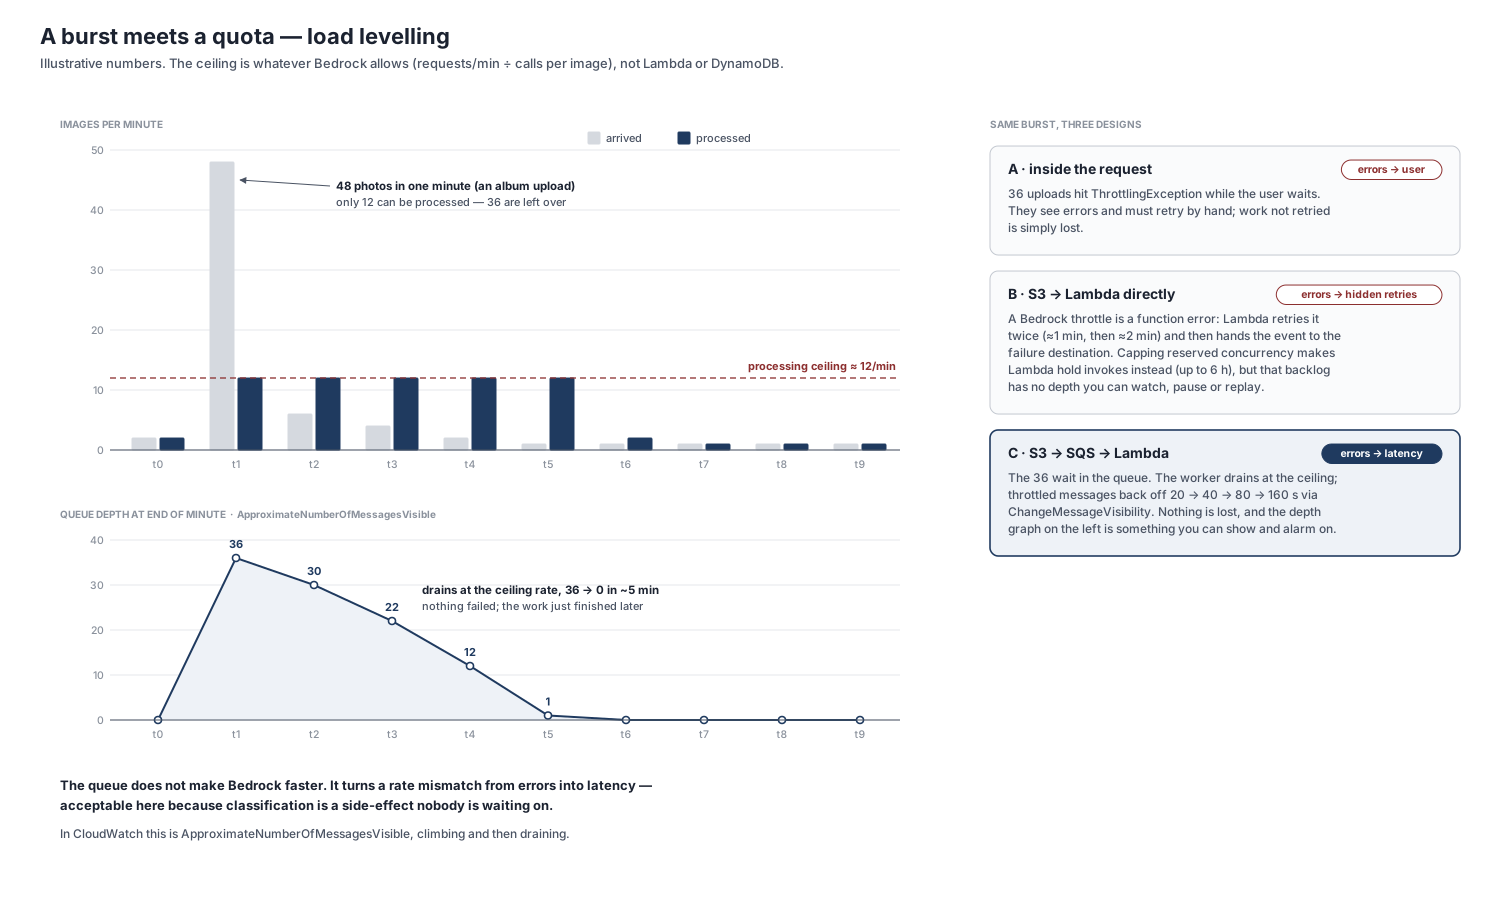
このトレードオフが許されるのは、分類の完了を待っている人がいないからです。この経路では遅延は目標ではなく、取りこぼさないことが目標です。
キューにはコストもあります。構成要素が増えます(キュー、DLQ、キューポリシー、イベントソースマッピング)。結果はアップロードのレスポンスではなく数秒後に届きますし、タイムアウトは互いに合わせて調整しなければなりません。またSQSはメッセージを少なくとも1回配信するので、すべての書き込みを冪等にする必要があります。ベクトルのキーは写真のS3キーなので、再配信されたメッセージは結果を重複させず、以前の結果を上書きするだけです。量が少なく安定していて、下流に共有のクォータもない場合なら、S3からLambdaを直接呼ぶほうがシンプルで、私もそうします。
失敗を黙って削除してしまう設定
ワーカーはバッチ内の各メッセージをそれぞれ個別のtryで処理するので、1枚の不正な写真が残りの9件を巻き込むことはありません。失敗したメッセージのIDを返し、Lambdaのポーラーがそれ以外を削除します。ただしこれが機能するのは、イベントソースマッピングでReportBatchItemFailuresが有効になっている場合だけです。
落とし穴は、これが無効なときに起きることです。その場合ポーラーは戻り値を無視します。そして私のハンドラーはすべての例外を捕捉しているので、どの呼び出しも成功に見え、ポーラーは失敗したメッセージも含めてバッチ全体を削除します。 何も再試行されず、DLQにも届きません。ワーカー自身のdocstringには逆のこと、つまりLambdaが「バッチ全体を再試行する」と書かれていました。それが正しいのは、ハンドラーが例外を投げた場合だけです。
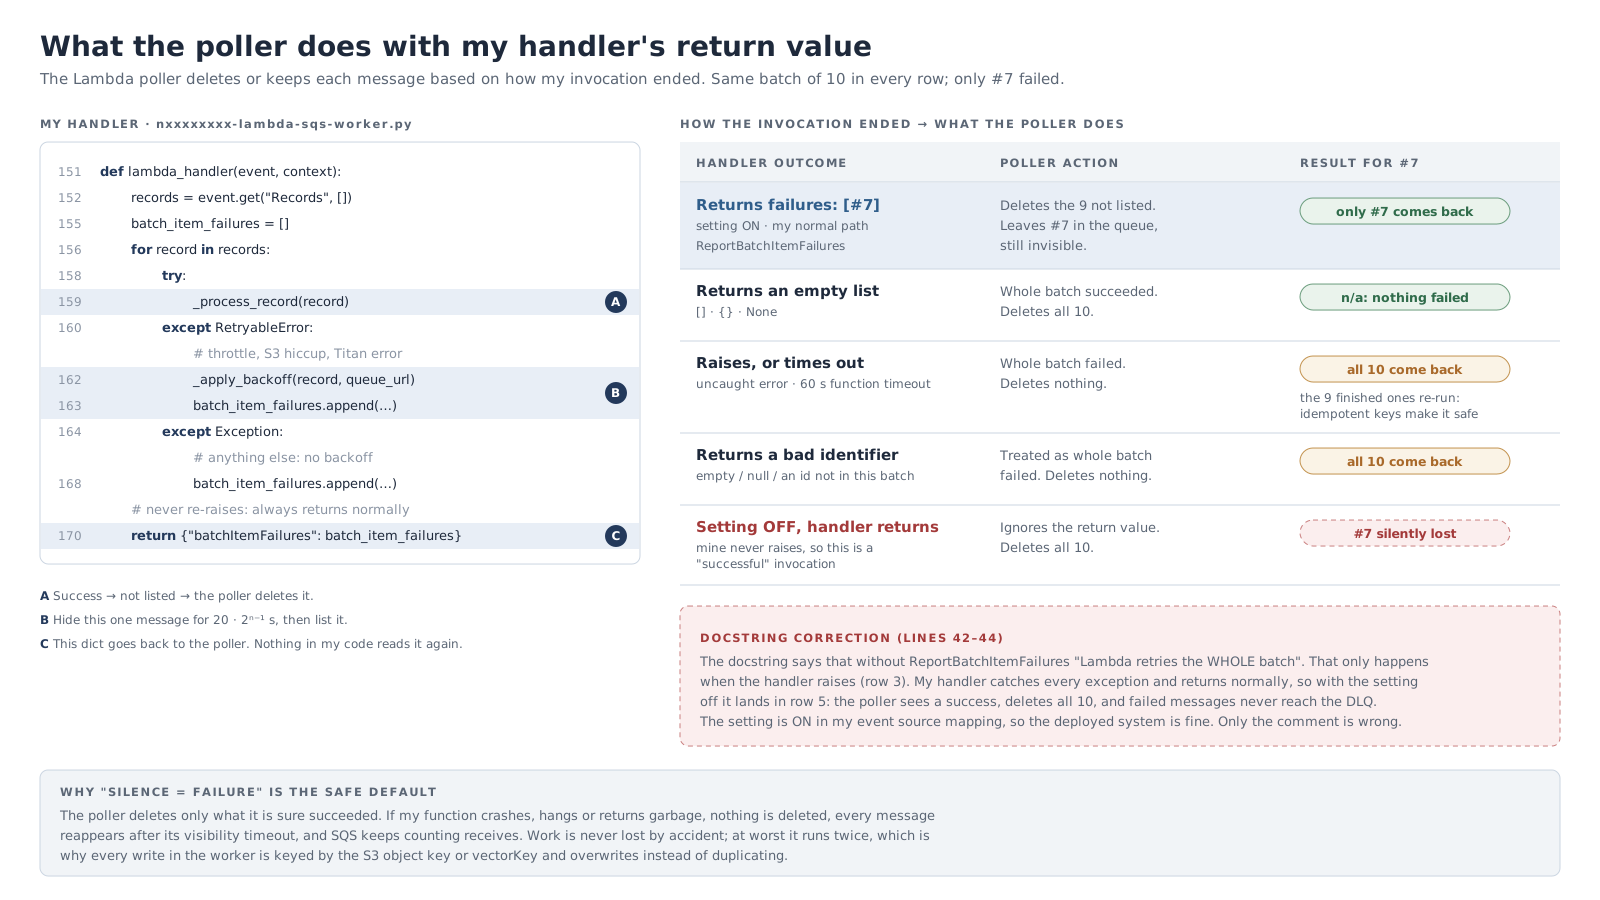
設定は有効になっており、デプロイ時のチェックでも確認していたので、システムは問題なく、間違っていたのはコメントだけでした。ここから得た教訓は、この約束事のうちハンドラーは半分にすぎない、ということです。残りの半分は設定のフラグで、それを間違えてもエラーは出ません。
3秒のタイムアウト
それ以前には、さらに静かな失敗もありました。ワーカーはLambdaのデフォルトである3秒のタイムアウトで動き始めましたが、ダウンロード、縮小、モデルの呼び出しを含むバッチは、それよりはるかに長くかかります。タイムアウトはバッチ全体の失敗として扱われるため、処理が終わっていたものも含めて、すべてのメッセージがもう一度試されることになりました。私のコードはエラーを何も記録しませんでした。記録する機会すらなかったからです。
タイムアウトを60秒に延ばし、キューの可視性タイムアウトを360秒に設定しました。AWSは関数タイムアウトの少なくとも6倍を推奨しており、こうしておけば、メッセージを処理中の呼び出しが終わる前にそのメッセージが再び現れることはありません。代償は失敗の遅さです。決して成功しないメッセージは、DLQに届くまでに約30分(360秒の試行を5回)かかります。
上限はクォータ
ワーカーがBedrockに負荷をかけすぎないよう、予約された同時実行数を2に設定しました。2つのワーカーがそれぞれ写真1枚につき数回モデルを呼んでも、クォータの範囲に収まります。スロットリングされたメッセージは個別にバックオフします。SQSにはメッセージ単位のバックオフがないため、ワーカーが各メッセージの可視性を20秒、40秒、80秒と、最大900秒まで延ばし直します。
あとでLambdaがSQSをポーリングする仕組みをさらに調べて、落とし穴を見つけました。ポーラーは予約された同時実行数を知りません。ワーカーに渡せないバッチを受信してしまうことがあり、そのメッセージは可視性タイムアウト後に戻ってきますが、受信回数はしっかり数えられます。長いバーストの間に、ワーカーが一度も見ないまま正常なメッセージがDLQに入ってしまう可能性があるのです。AWSはまさにこのケースのために、イベントソースマッピングに最大同時実行数の設定を追加しています。つまり私のDLQには、まったく異なる2種類のものが入りうるということです。決して成功しないメッセージと、スロットリングが収まるのを待ちきれなかっただけのメッセージです。
今ならどう変えるか、そしてほかへの応用
- 同時実行数の上限を、関数だけでなくイベントソースマッピングにも設定する。 ポーラーがワーカーの処理能力以上のメッセージを取らないようにします。
- スループットを、手で決めた数値ではなくクォータに連動させる。
- DLQの深さと最も古いメッセージの経過時間にアラームを設定する。 どちらも確認できる指標でしたが、私は手作業で見ていました。
- バックフィルを管理されたジョブにする。 過去の写真の再処理は、使い捨てのスクリプトでした。
- 最初から本物の入力でテストする。 テストセットにスマートフォンの写真が1枚あれば、何かがDLQに届く前にピクセル数の上限に気づけたはずです。
クライアントワークでの文書パイプラインも同じ形をしています。スキャンしたPDFや帳票をスマートフォンで撮った写真は、どんなテストセットよりも雑然としていて、モデルのAPIには本番で初めて出会う制限があります。そうしたパイプラインも同じように作るつもりです。バッファは自分で持ち、失敗が目に見えて再実行できる場所で待つようにする。そして、あらゆる約束事の設定側の半分を、コードと同じくらい注意深く確認することです。