
検索評価の一番の結果は「負け」でした。2つのインデックスを検索して結果を統合する構成、つまり私自身が推していた設計の平均逆順位(MRR)は0.89でした。画像インデックス単体は0.92で、対応のある比較の信頼区間は、その差がノイズではないことを示していました。
本稿では、その数字が結局何を意味していたのか、評価からほかに何がわかったのか、そして25問という規模をどこまで信用できるのかを書きます。これはStrobe Assistantプロジェクトの一部で、Strobe Assistantはユーザー自身の写真と投稿を対象にしたチャットエージェントです。システム全体はプロジェクトの概要にまとめています。
なぜインデックスが2つあるのか
写真の埋め込みにはAmazon Titan Multimodal Embeddings G1を使っています。画像と短いテキストを同じベクトル空間に置くモデルなので、「麺」という言葉で麺の写真が見つかります。一方、投稿やコメントはテキストで、投稿は5,000文字まで書けます。Titan Multimodalのテキスト入力は256トークン(英語で約1,000文字)が上限で、英語専用であり、テキストを他のテキストではなく画像と対応づけるよう学習されています。
そこでテキストは、Titan Text Embeddings V2で埋め込んだ2つ目のインデックスに入れています。こちらは100以上の言語で8,192トークンまで扱えます。検索では質問を2回埋め込み、両方のインデックスに並行して問い合わせ、2つの結果リストを統合します。代わりの案は、すべてを1つのマルチモーダルなインデックスに入れることでした。そのほうがシンプルですが、長い投稿は約1,000文字で黙って切り捨てられ、日本語の投稿は弱いベクトルにしかなりません。
ここで1つ、正直に書いておくべき穴があります。評価に使った投稿はどれも140文字未満だったので、評価は256トークンの上限にまったく近づいていません。評価が示しているのは、テキストのインデックスに意味があるということです。テキストのインデックスに別のモデルが必要だったことは示していません。その主張は、測定ではなく、ドキュメントに書かれた制約に基づいています。
RRFと、それが実際にしていたこと
2つのインデックスは異なるモデルの距離を返すので、そのまま比べることはできません。一方の空間での0.4と、もう一方での0.4は同じ意味ではないのです。Reciprocal Rank Fusion(RRF)は順位だけを使うことで、この問題を回避します。各項目は、それが現れるリストごとに1/(k + rank)の得点を得て、それを合計します。kは通常60です。RRFの強みは一致を評価することで、両方のリストで上位に来た項目は、片方のリストで1位だった項目に勝ちます。
保存した結果を読んでいくと、Strobeではその一致が一度も起きていないことに気づきました。画像のベクトルは写真の保存キーで、テキストのベクトルは投稿やコメントのIDで識別されるため、同じ項目が両方のリストに現れることはありえません。そのため、統合後の得点はどれも項が1つだけになります。画像の1位とテキストの1位が同点、画像の2位とテキストの2位が同点、という具合に並び、安定ソートによって画像のリストが先に来ます。統合後のリストは単に画像、テキスト、画像、テキスト……と交互に並ぶだけで、kは順序に何の影響も与えません。
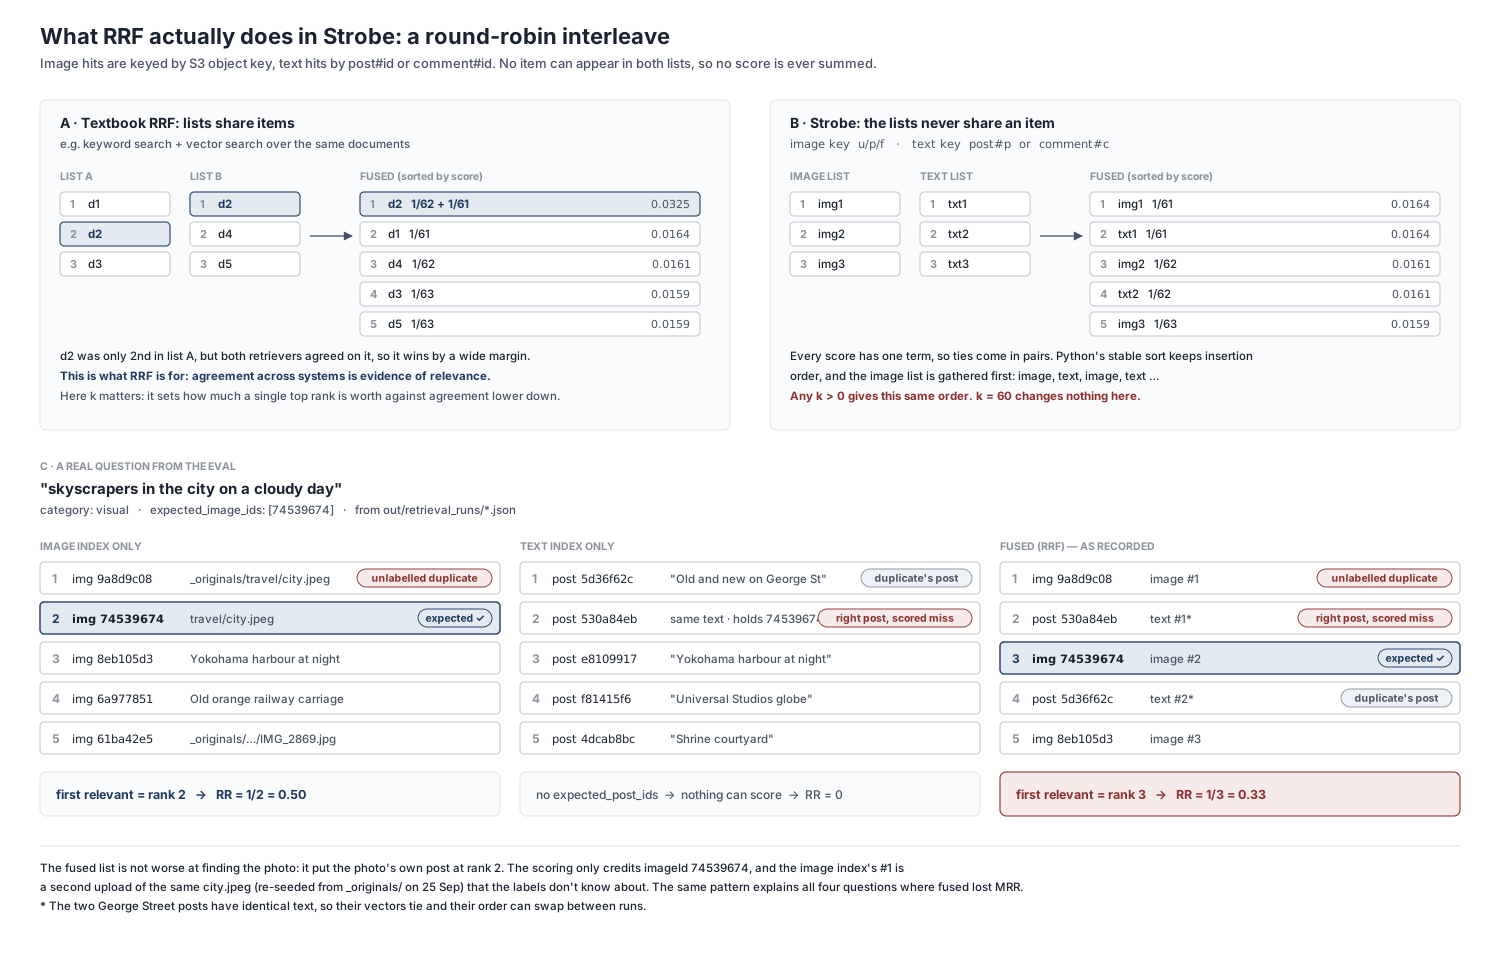
それでも、エージェントが両方の種類の根拠を必ず目にできるという点で、設計としては妥当です。ただ、私が説明していた内容とは違いますし、後で触れる結果の理由にもなっています。結果を5件返すとき、統合された構成は常に写真3件とテキスト2件を返すのです。
結果
コーパスは、4つのテーマ(食べ物、旅行、スポーツ、ペット)に分かれた私自身の写真49枚とその投稿、そして6つのカテゴリーにわたる25問の質問です。正解は、視覚モデルが書いたキャプションではなく、各写真が入っていたフォルダーから決めました。モデルが自分の作業を採点することにならないようにするためです。各構成について、recall@5(正解の写真のうちいくつが上位5件に入ったか)とMRR(最初の正解が何位だったか)を、質問単位のブートストラップによる95%区間とともに測りました。
| 構成 | recall@5 [95% CI] | MRR [95% CI] |
|---|---|---|
| 画像インデックスのみ | 0.75 [0.65–0.85] | 0.92 [0.84–0.98] |
| テキストインデックスのみ | 0.08 [0.02–0.16] | 0.16 [0.04–0.32] |
| 統合(RRF) | 0.77 [0.65–0.88] | 0.89 [0.79–0.97] |
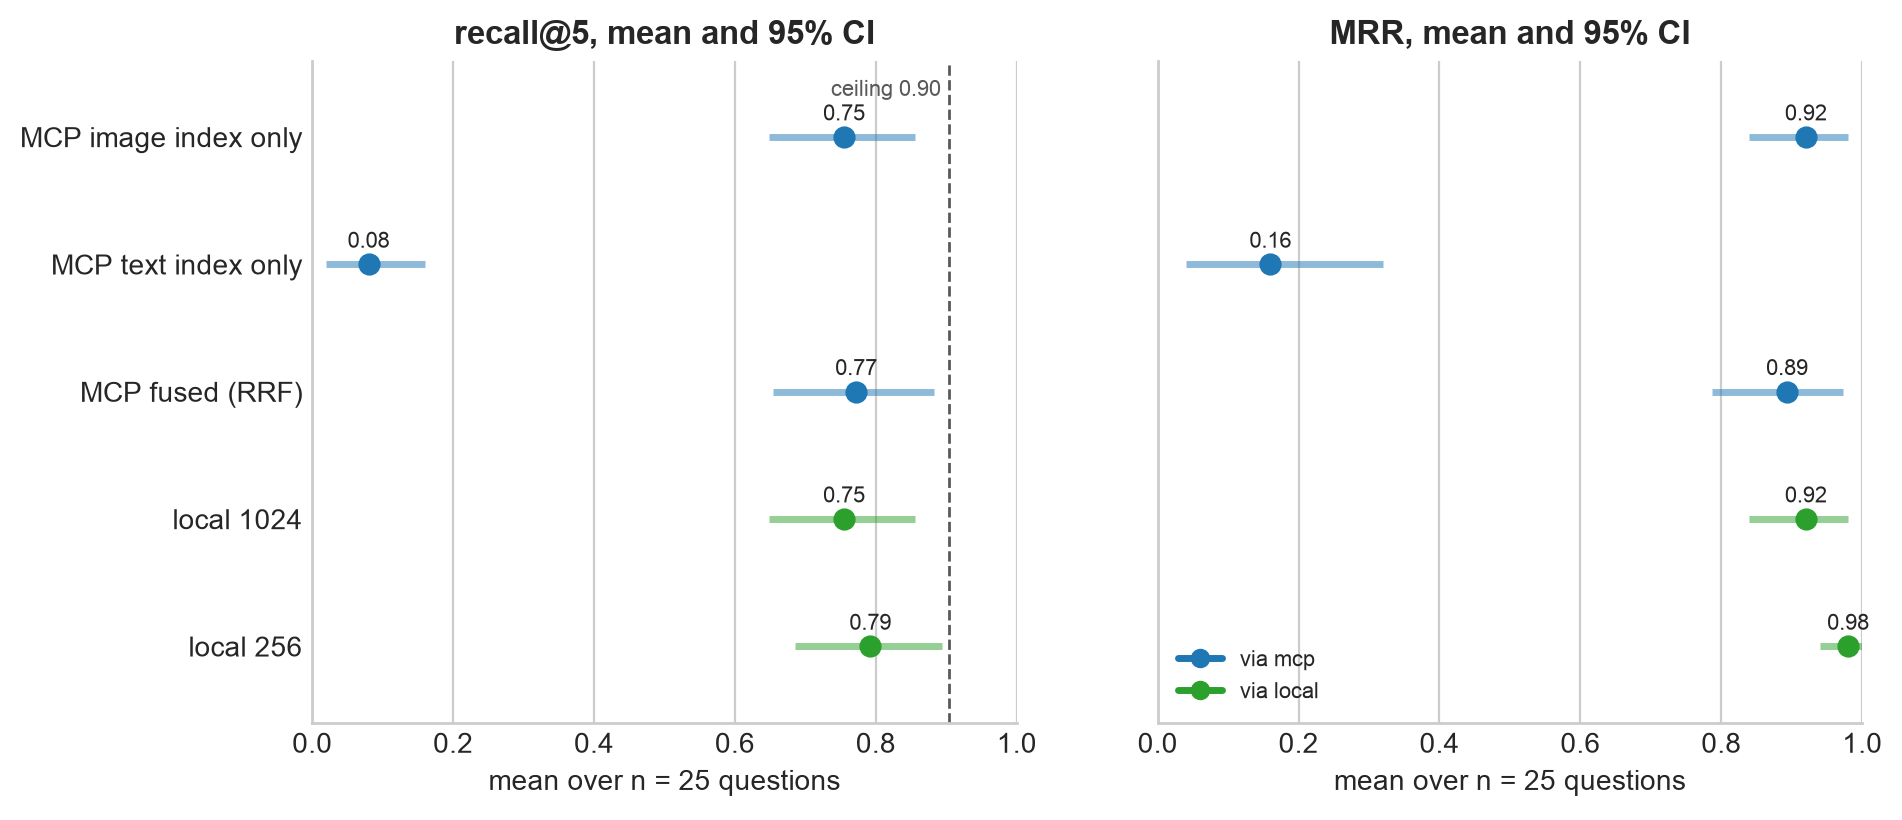
区間は大きく重なっていますが、区間が重なっているからといって「差がない」わけではありません。どの構成も同じ25問に答えているので、正しい比較は質問ごとの比較です。そこで、質問ごとの差をブートストラップしました:
- 全体のrecall@5: 統合から画像のみを引いた差は+0.02、CIは[−0.07, +0.11]。ノイズの範囲内です。
- テキストに関する質問のrecall@5: +0.37、CIは[+0.17, +0.50]。明確に良く、まさにテキストインデックスの役目どおりです。
- MRR: −0.03、CIは[−0.05, −0.01]。明確に悪化しています。
−0.03の正体
MRRは最初の正解の1/rankを平均したものなので、1位を失うとその質問では0.5を失いますが、2位から3位に下がっても失うのは約0.17です。保存した結果を1問ずつ確認しました。25問のうち21問では何も変わっていませんでした。残りの4問では、最初の正解が2位から3位に下がっていて、4 × (1/2 − 1/3) ÷ 25 = 0.027となります。−0.03はこれですべてです。
もっと興味深いのは、なぜその4問がそもそも2位から始まっていたのかです。どの場合も、画像インデックスの1位は正解の写真の2枚目のコピーでした。コーパスを登録し直したときに49枚のうち10枚が二重にアップロードされていて、私のラベルには1枚目しか載っていなかったのです。そのため画像インデックスは複製を1位にし、それは正解として数えられませんでした。統合ではテキストの1位が2位に入り(交互配置のため)、ラベル付きの写真は3位に押し下げられます。4問のうち2問では、そのテキストの1位は正解の写真そのものを含む投稿でしたが、それもラベル上は正解扱いになっていませんでした。
保存した上位5件のリストを、複製も正解として数えて採点し直すと、どちらの構成もMRRは1.00になり、差は消えます。これは採点し直しであって再実行ではないので、結果として引用する前に、コーパスを直して再実行したいと考えています。
対応のある区間は、きちんと役目を果たしていました。差は本物でした。ただ、区間には原因まではわかりません。原因はこの場合、統合ではなくラベルの性質でした。それを示したのは、外れた結果を読むことだけでした。
256次元か、1,024次元か
ベクトルを小さくしても問題ないかも試しました。埋め込みのローカルコピーに対して完全なコサイン類似度で順位付けすると、256次元はrecall@5が0.79、MRRが0.98で、デフォルトの1,024次元の0.75と0.92を上回りました。一見すると、小さいほうが良さそうに見えます。
対応のある比較の答えは違います。MRRの差は−0.06でCIは[−0.14, 0.00]、recall@5の差は−0.04でCIは[−0.09, 0.00]。どちらもノイズの範囲内です。正直な結論は、4分の1のサイズでも測定可能な差は見つからなかったということであって、256次元のほうが良いということではありません。副次的な結果として、1,024次元での完全検索は、S3 Vectorsの近似検索とまったく同じ数値になりました。この規模では、インデックスによる損失はないということです。
私は1,024次元のままにしました。この規模では、節約は見た目より小さいからです。S3 Vectorsは書き込み1回あたり最低128 KBとして課金するので、1 KBのベクトルも4 KBのベクトルも書き込みの費用は同じで、小さくなるのはストレージとクエリのデータ量だけです。実際の規模になったら、思い込みではなくこの比較を出発点にして、改めて検討するつもりです。
n = 25で言えること、言えないこと
25問あれば、1つのカテゴリーでの大きな効果(テキストの質問で+0.37)を見ることも、全体の差が小さいと言うこともできます。しかし、1問や4問しかないカテゴリー同士を比べるには足りません。
一番わかりやすい例が、唯一の日本語の質問「京都のお寺の写真」です。Titan Multimodalは英語専用だとドキュメントに書かれていて、私はこの質問を外れて当然のものとして印を付けていました。ところが実際には、正解の写真3枚がすべて上位5件に入りました。n = 1なので、これは発見ではなく逸話にすぎません。それでも、ドキュメントに書かれた制約と測定した制約は別物だということを思い出させてくれます。
また、この質問セットは簡単です。はっきり異なる4つのテーマと49枚の写真なので、0.9を超える得点は予想どおりです。私はこれらの数字を、同じ質問で構成を比べるために使い、検索品質についての絶対的な主張には決して使いません。
次に測りたいこと
- ラベルを直してから再実行する。 複製にラベルを付けるか取り除くかして、MRRが帳簿ではなく検索そのものを測るようにします。
- 投稿の単位で統合する。 画像のヒットを、統合する前にその写真が属する投稿に対応づければ、写真とその投稿のテキストが互いを補強できます。それこそがRRFの目的です。
- 日本語をきちんと測る。 日本語の投稿に対する日本語の質問セットを作り、要となる事実が最初の1,000文字より後ろにある長い投稿も含めます。テキストのインデックスに別のモデルが必要だったかどうかは、それで確かめられます。
- 分類の品質を測る。 視覚モデルのキャプションとラベルは、正解と照らして採点したことがありません。ラベル付きの検証用画像を100枚ほど用意すれば、上位1件と上位3件のラベルの正確さを測り、キャプションはルーブリックで採点できます。
日本語の技術マニュアルを扱うクライアントワーク(「再現率100%」は何も語っていなかった)にも、同じ習慣を持ち込みました。数字を信じる前に、それが何を測っているのかを決め、そして外れた結果を読むことです。