
IFN680 Advanced Machine Learning and Applicationsは、私が今学期QUTで履修している科目の1つです。CNNからTransformer、オートエンコーダ、変分オートエンコーダ(VAE)へと速いペースで進み、初めて触れたときにはすぐに腑に落ちない概念も多くありました。そのため、AIを自宅の家庭教師にして、この科目に週およそ16時間、丸2日ほどを費やしています。
速く学べるようになったのは、変化の一部にすぎません。より大きな変化は、学ぶことがずっと楽しくなったことです。この記事では、AIとともに学ぶ今のやり方を1年前の学び方と比べて振り返り、違いがとりわけはっきり表れた2つのトピックを紹介し、その過程で落ち着いたツールキットについて説明します。要するに、AIのおかげで複雑な考え方が理解しやすくなり、さらに各ツールを最大限に活かす方法を工夫したことで、学習体験全体がより充実したものになりました。
1年前:ついていくのに必死だった
1年前、私はIFN680の前提科目であるIFN580 Machine Learningを履修しました。内容はIFN680より取り組みやすいものでしたが、理解するのに時間と労力がかかり、毎週の講義とチュートリアルのペースについていくのに苦労しました。
当時、AIは今のような学習インフラではありませんでした。モデルの性能は今より低く、大学も今ほどAIの利用に前向きではありませんでした。IFN580にかかった時間を考えると、AIがなければIFN680には週16時間をはるかに超える時間が必要だったはずです。
今学期:学習インフラの一部としてのAI
IFN680では、すぐには腑に落ちない高度な機械学習の概念や手法が登場しました。AIを学習に取り入れたことで、それらをずっと早く理解できるようになりました。その違いの大部分は、次の3つによるものです。
図が複雑な考え方を小さく分解してくれた。 Claudeが生成した図はすっきりとしていて直感的でした。良い図は、数式だらけの一段落を一目で把握できるものに変えてくれます。そして細部を詰めていく間も、何度もその図に立ち返ることができます。
説明が自分のコードから始まった。 一般的な回答ではなく、チュートリアルのノートブックや自分のコードの特定の行をClaudeに示して、それが何をしていて、なぜそうなっているのかを尋ねることができました。たとえば、Transformerのチュートリアルで入力埋め込みにmath.sqrt(d_model)を掛けているのはなぜか、といった質問です。今まさに見ているコードに基づく説明は、誰に向けたわけでもない説明よりずっとわかりやすいものです。自分のコードだけでは足りないときは、ほかのコード例が穴を埋めてくれました。
途中で新しい概念にも出会えた。 説明の中で、まだ知らなかった関連する考え方が登場することがよくありました。そのため、1つ質問するたびに、その質問の範囲を少し超えて知識が広がりました。
2つの例
CNN:受容野が広がっていく様子を見る
畳み込みニューラルネットワーク(CNN)のニューロンの受容野とは、元の入力画像のうち、そのニューロンの値に影響を与えうる領域のことです。3×3の畳み込みが1つだけなら、見えるのは3×3のパッチだけです。その上に3×3の畳み込みをもう1つ重ねると、それが見る9つの値はそれぞれ3×3のパッチから計算されたものなので、2層目のニューロンは入力の5×5の領域に依存することになります。ストライドが1なら、層が1つ増えるごとに2ピクセルずつ広がります。
数式で書くととなり、正しくはあっても抽象的です。3つのグリッドとして描けば、一目瞭然です。
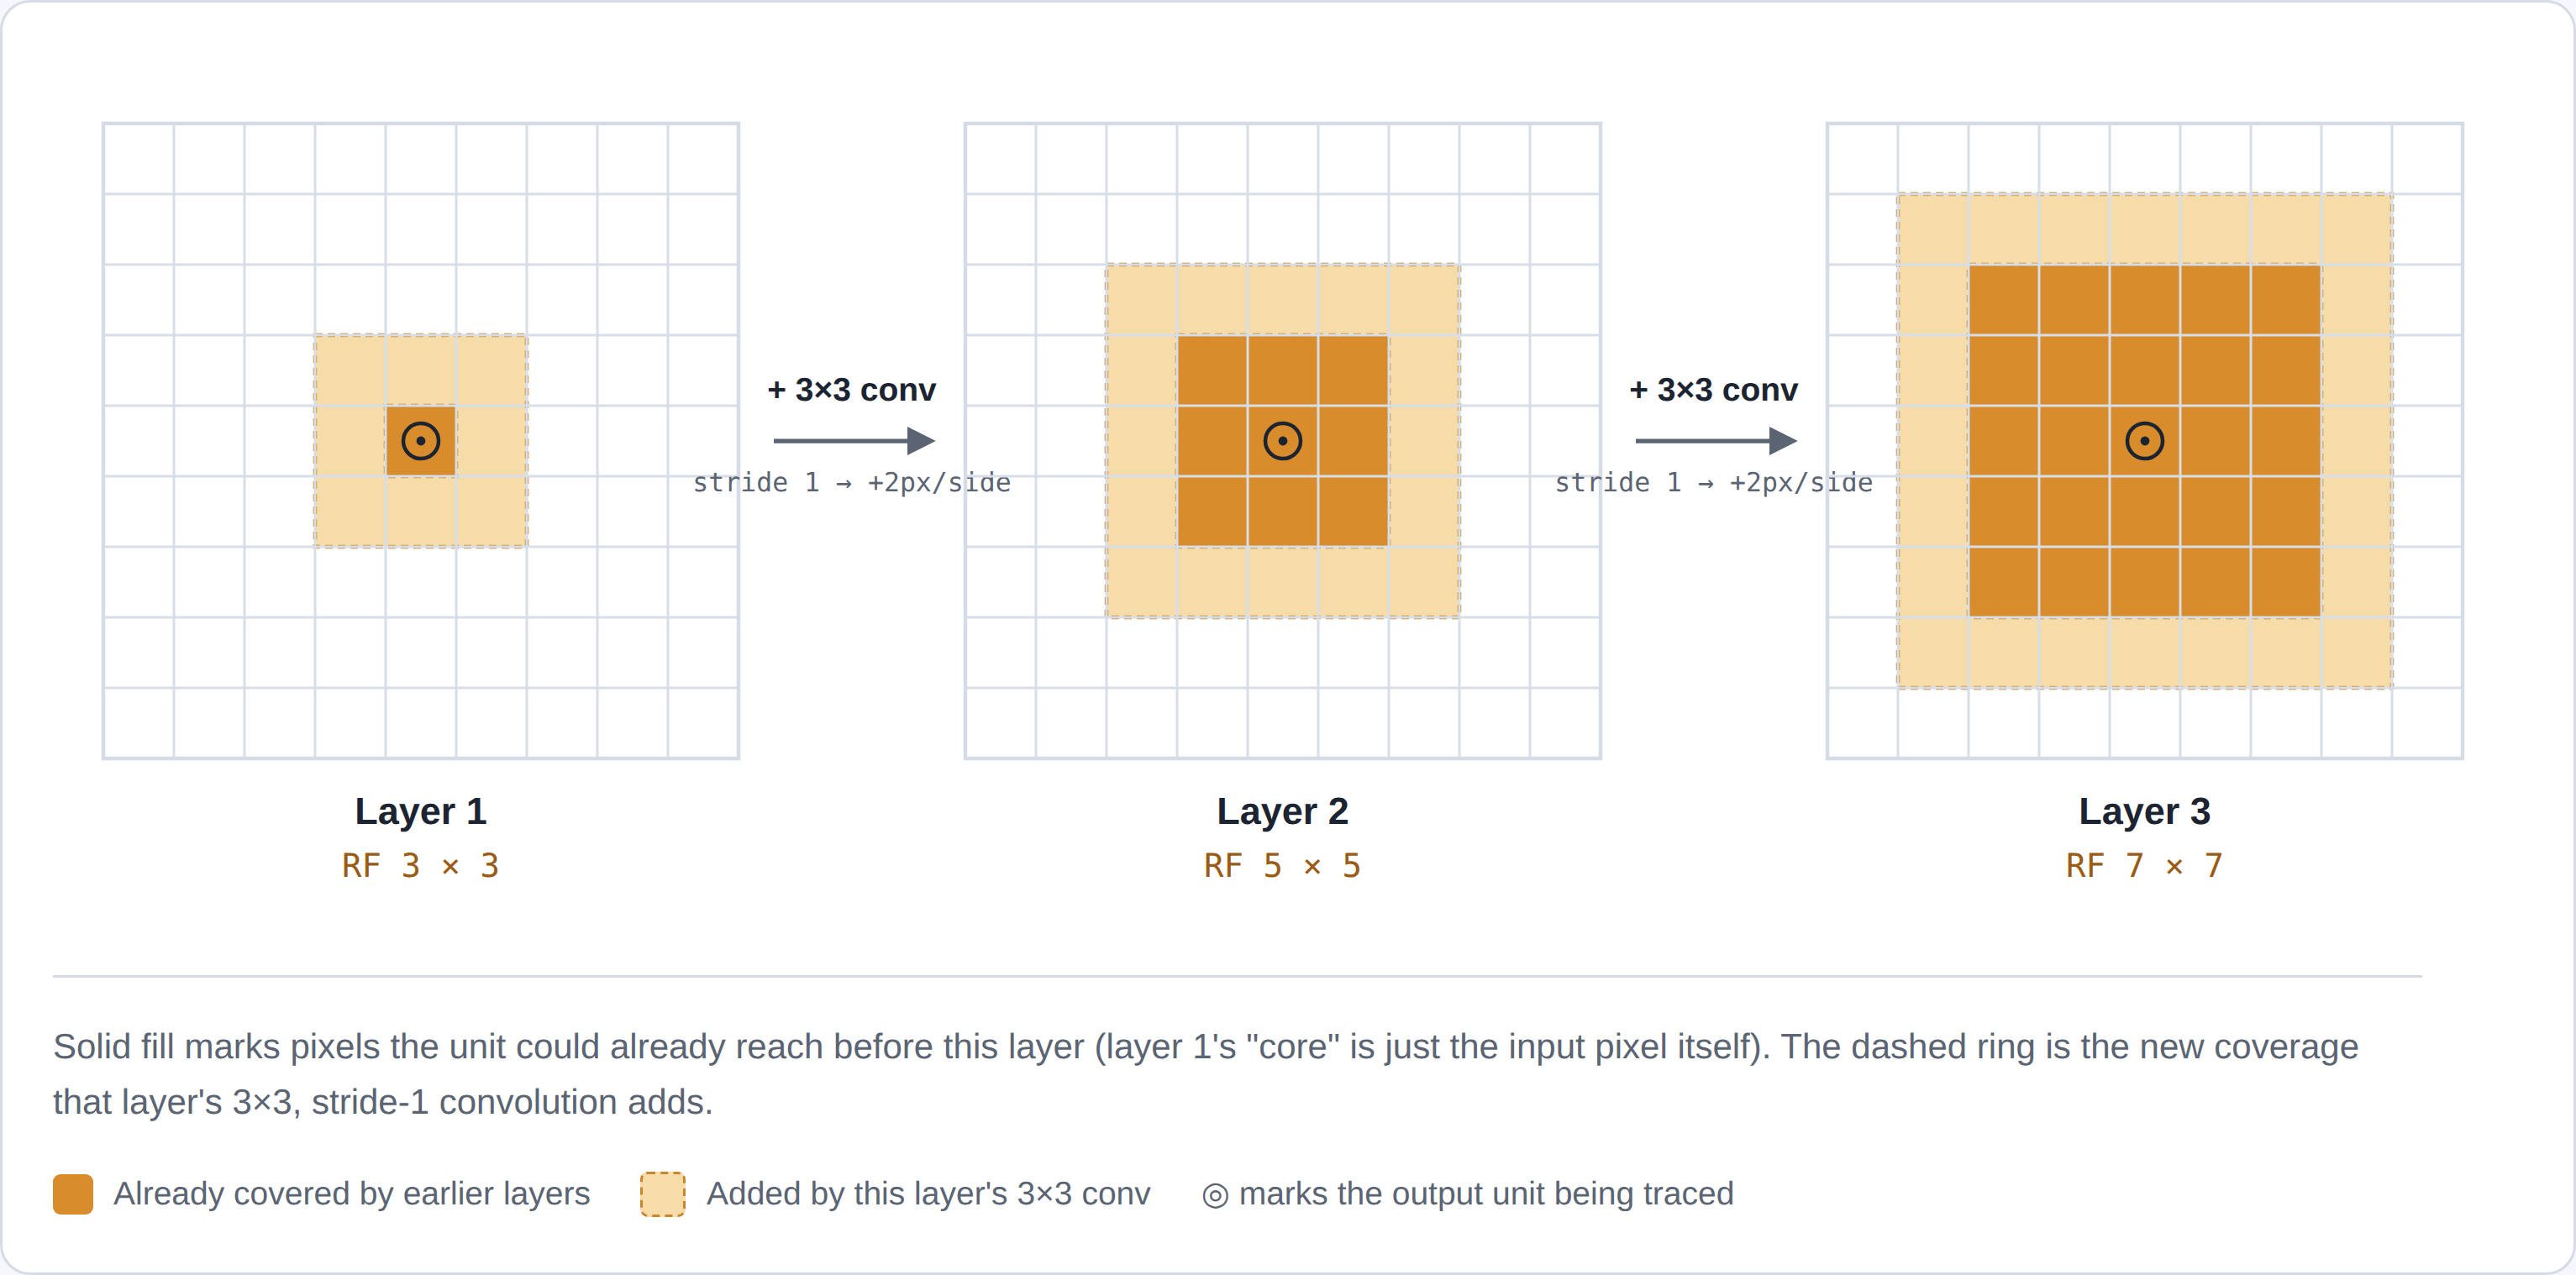
この図が頭に入っていれば、次の疑問にもずっと答えやすくなります。なぜCNNは1つの大きなカーネルを使わずに層を深くするのでしょうか。3×3の層を3つ重ねると、7×7のカーネル1つと同じ7×7の範囲を見渡せますが、重みは入力チャネルあたり49ではなく27で済み、さらに間に非線形性が2つ加わります。これについてはCNNシリーズ(英語)で詳しく書いています。
オートエンコーダとVAE:点と雲
2つ目の例は、オートエンコーダ(AE)とVAEの違いです。どちらも入力を小さな潜在コードに圧縮し、それをデコードして元に戻します。違いは潜在空間で何が起こるかにあります。AEは各画像を1つの点に写像しますが、それらの点が散らばって、間に大きな隙間のあるクラスタになるのを防ぐものは何もありません。VAEは各画像を小さなガウス分布の雲に写像し、それらの雲をすべて共通の事前分布へと引き寄せます。そのため、ランダムにサンプリングしたコードは、デコーダが実際に学習した場所に落ちます。
これは正確な説明ですが、本質的には1枚の絵で済むことを、多くの言葉で説明しています。
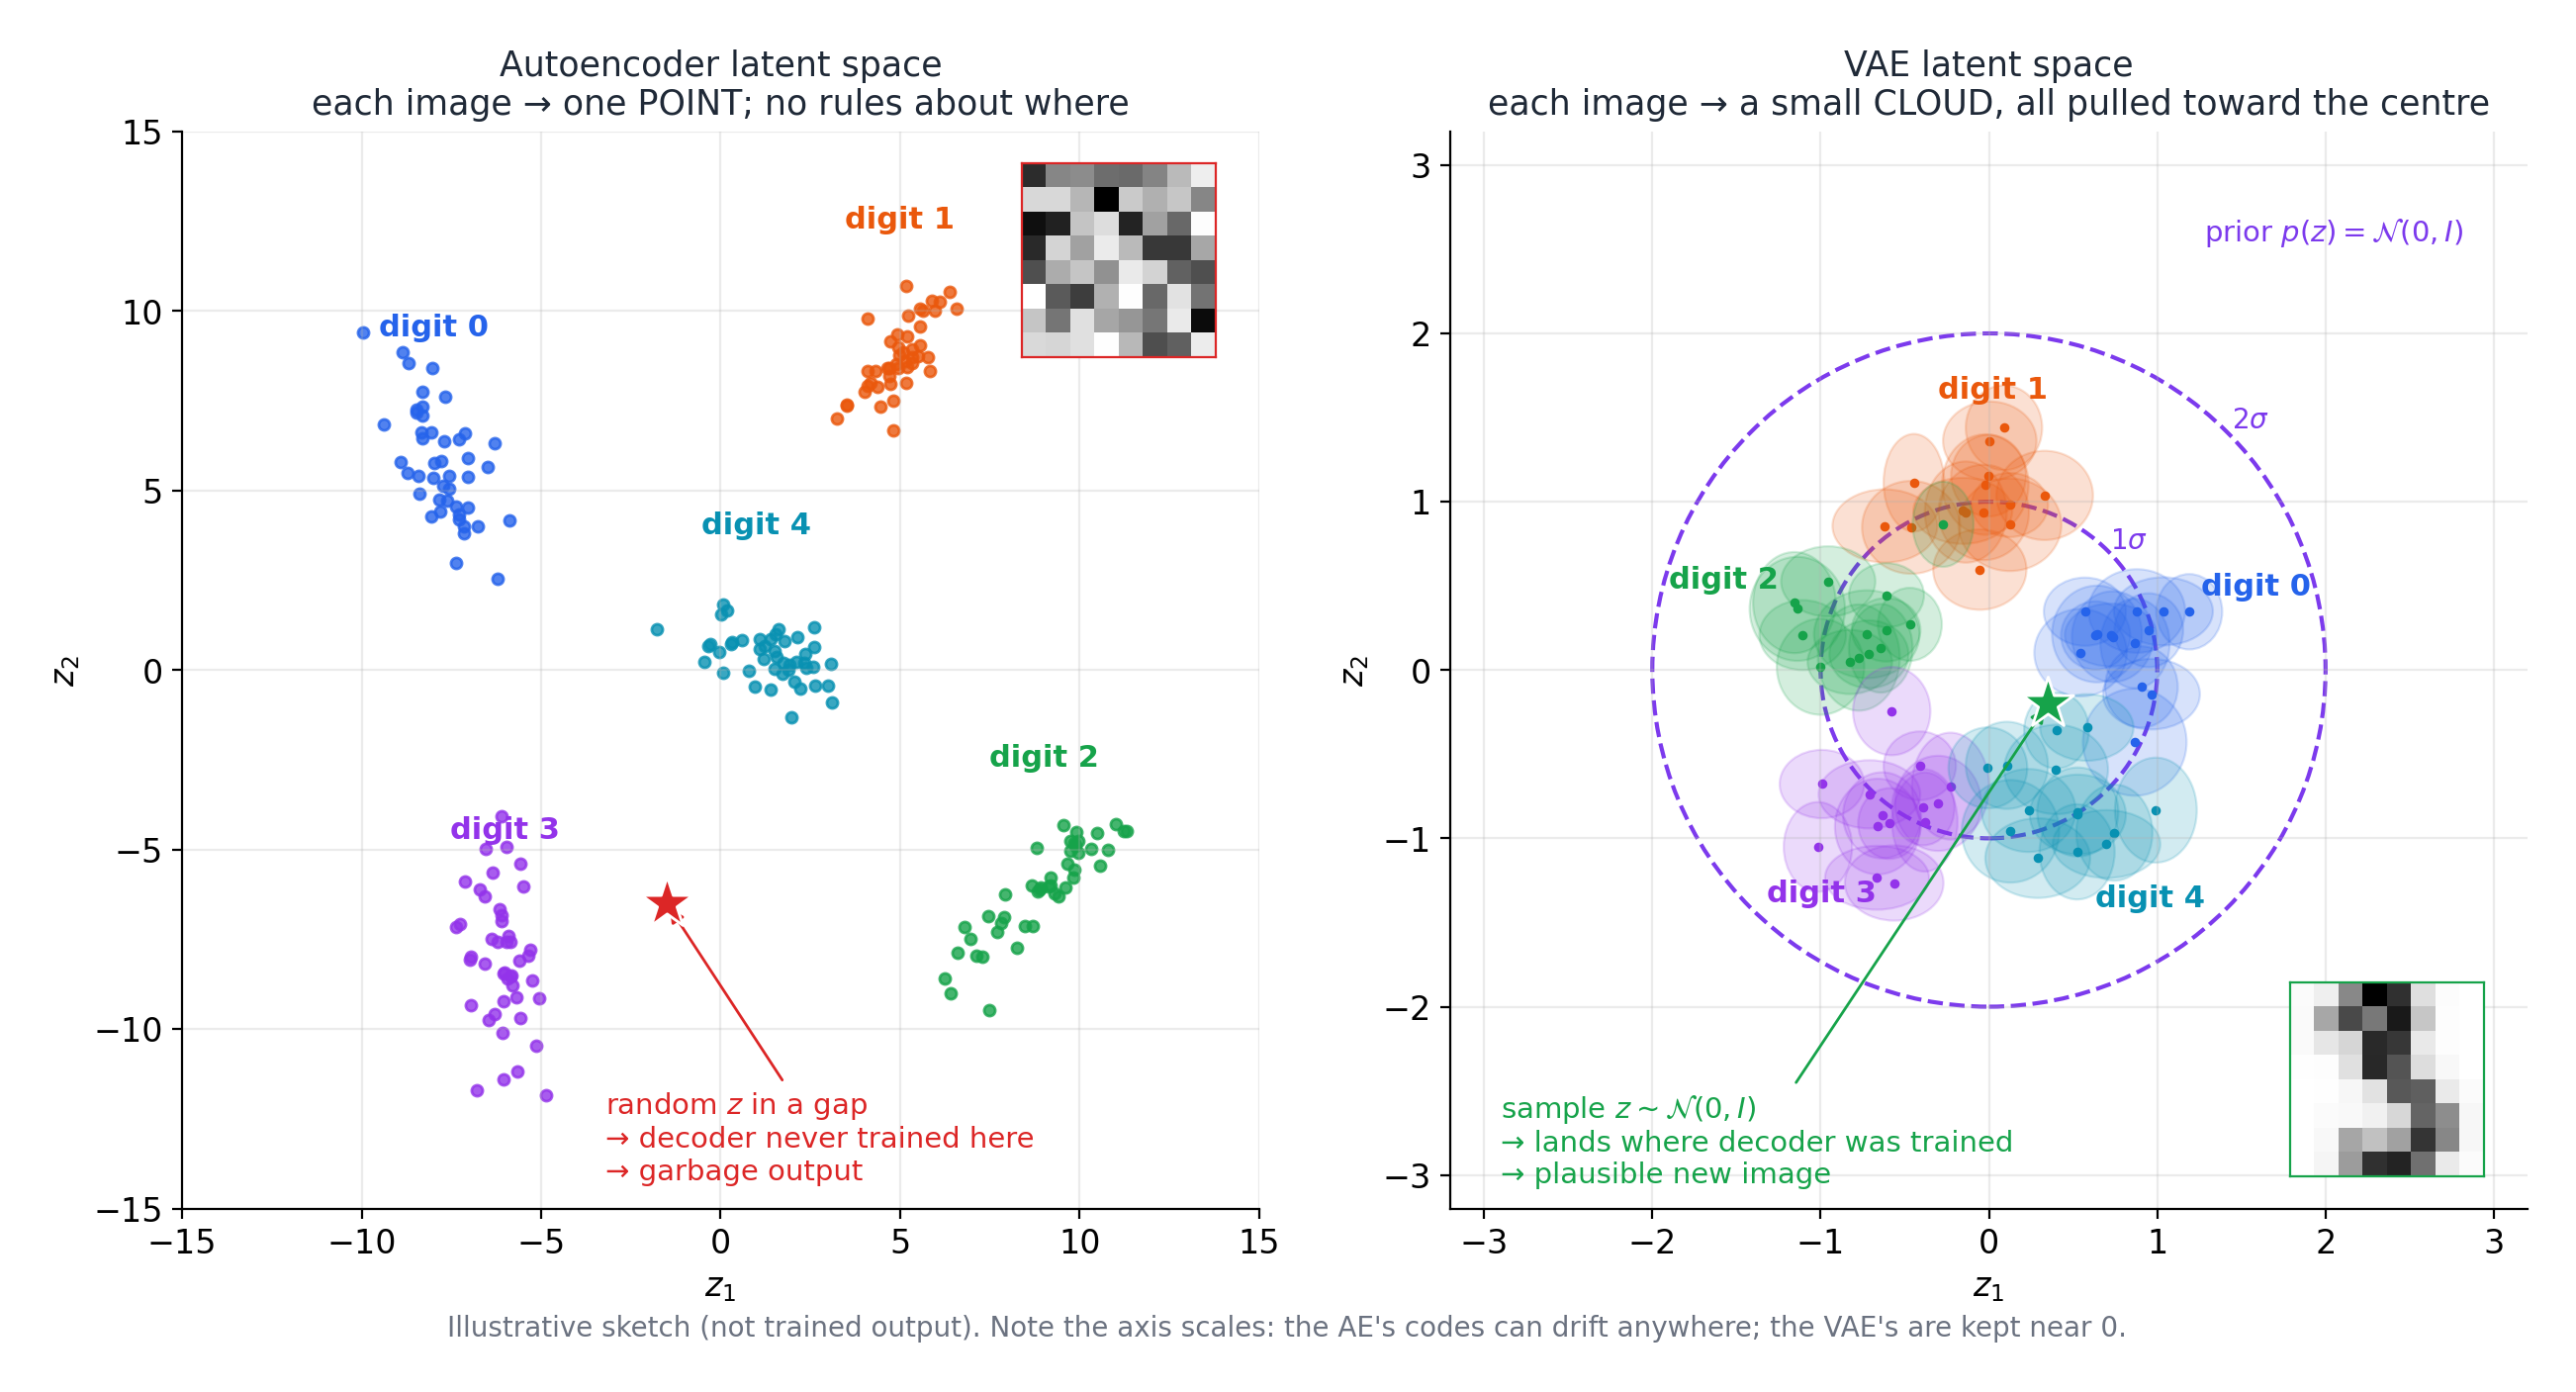
この図を念頭に置くと、コードも読みやすくなります。VAEのエンコーダが1つのベクトルではなく平均と対数分散を出力するのはなぜか、そしてその損失関数が再構成誤差にKL項を加えるのはなぜか、といった点です。これは、私がこの科目のプロジェクトの1つで取り組んだ条件付きVAE(cVAE)の土台にもなっています。どちらのトピックもオートエンコーダシリーズで扱っています。
タスクごとに適したツールを選ぶ
今学期がより充実したものになったもう1つの理由は、それぞれのAIツールを最大限に活用する方法を工夫したことです。どのツールにも使用量の上限があり、動作する環境もそれぞれ限られています。そのおかげで、各ツールの機能や強み、落とし穴を理解し、何も考えずにツールを使うのではなく、使用量を意識的に管理して上限を最大限に活かすようになりました。
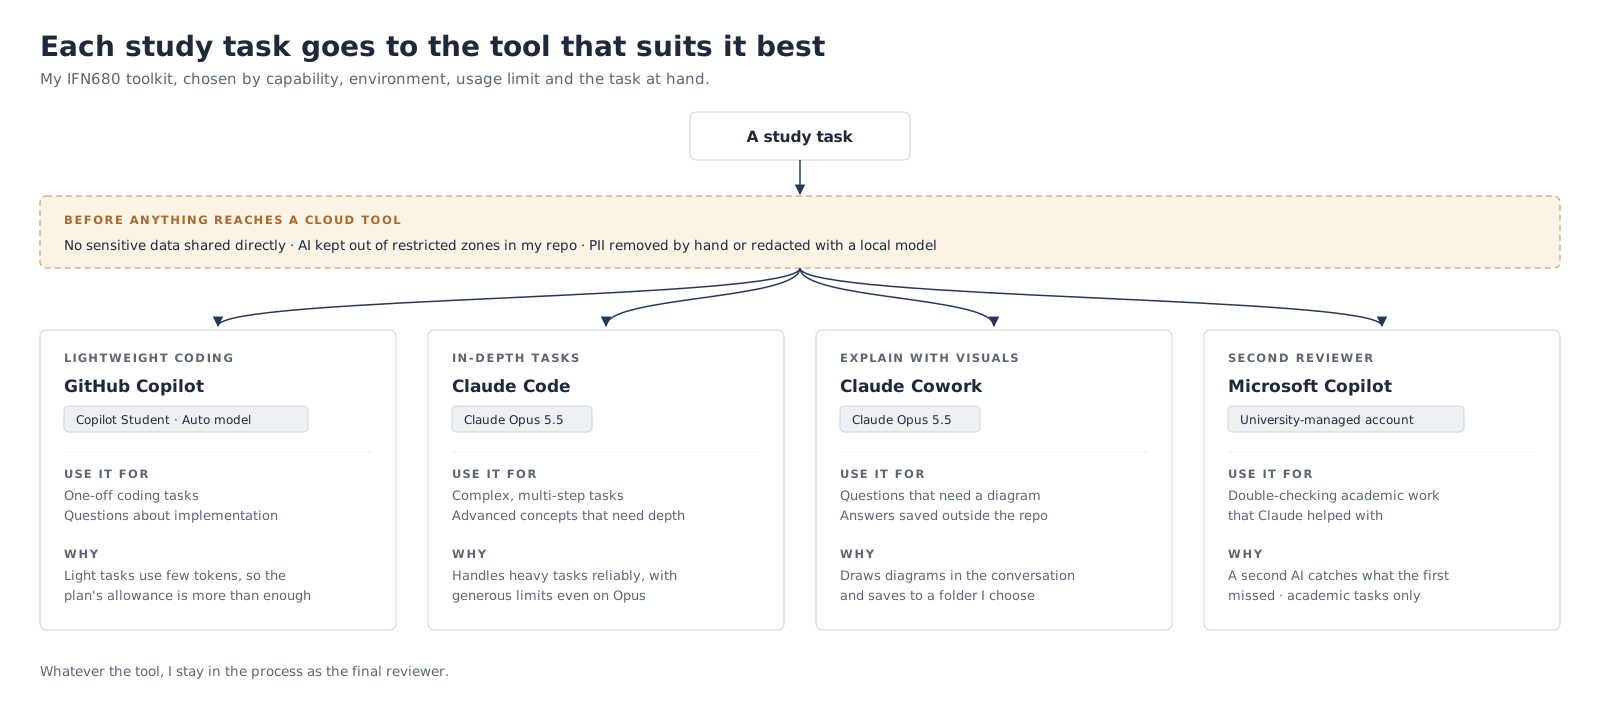
ツールは4つの観点で選んでいます。 何ができるか(複雑なタスク、ビジュアル、深い思考、コーディング)、どこで動くか、使用量の上限、そしてもちろん目の前のタスクの性質です。Claudeはローカルマシンからクラウド、Webブラウザまで、ほぼあらゆる環境で動きます。一方、GitHub Copilotが動くのは主にIDEとGitHub上です。
何よりもまずセキュリティ。 機密データをAIに直接共有することは決してありません。リポジトリの一部は、各ツールの指示ファイルに書いたルールによってAIツールの立ち入りを禁止しています。また、個人情報やその他の識別につながる情報を含むタスクでは、クラウドベースのAIツールに渡す前に、手作業で取り除くか、ローカルモデルで秘匿化しています。
私のツールキット
- GitHub Copilot(Copilot Studentプラン): 単発の軽いコーディングタスクと、実装についての質問。私のプランでCopilotが選ぶモデルはこうしたタスクをうまくこなし、トークンもあまり使わないので、プランの割り当てで十分に足ります。
- Claude Code(Claude Opus 5.5): より複雑な複数ステップのタスクと、詳しく踏み込んだ説明が必要な高度な概念についての質問。
- Claude Cowork(Claude Opus 5.5): 説明に図が必要な質問(Coworkは会話の中で図を描いてくれます)と、リポジトリの外に保存しておきたい回答。
- Microsoft Copilot: 学業のタスクにおける2人目のレビュアー。
なぜすべてをCopilotで済ませないのでしょうか。私のプランのモデルでは重いタスクを安定してこなせず、割り当てもすぐに使い切ってしまうからです。Claudeのプランの上限はOpusを使っていてもより余裕があります。さらに、いくつかの習慣のおかげで、この科目のどのセッションでもClaudeの5時間の上限や週間の上限に一度も達しませんでした。プロンプトキャッシュが切れないようにすること、新しいタスクの前にセッションをクリアすること、タスクの途中で履歴を圧縮すること、複数のタスクを1つのプロンプトにまとめること、そして必要十分なコンテキストだけを共有することです。
Microsoft Copilotはクロスチェック役。 私のアカウントは大学が管理しているため、コンプライアンスと一貫性の観点から、学業のタスクにだけ使っています。たとえば、Claudeの助けを借りて(匿名化した)レポートを見直した後、AIは間違えることもあるので、Microsoft Copilotにも再確認してもらいます。私の経験では、別のAIツールでクロスチェックすることで、ハルシネーションや捏造が大きく減り、アウトプットの質も上がりました。私は常に最終レビュアーとしてプロセスに関わっているので、その違いを実感できます。
このようにタスクを分けるのは、ソフトウェア工学における関心の分離に通じます。 知識を管理し、後から見つけやすくなるという利点もあります。会話履歴はツールごとに、さらに各ツールの中ではセッションごとにまとまっているので、知識のカテゴリーごとにそれぞれの置き場所があります。
まとめ
1年前、私はIFN580のペースについていくのに苦労しました。今学期は内容がより高度になったにもかかわらず、概念をより早く理解できています。それは主に、複雑な考え方を直感的にしてくれる図と、自分のコードから始まる説明のおかげです。
それでも、いちばん心に残るのはスピードではありません。AIを学習インフラの一部として扱うことは、内容だけでなくツールについても学ぶことでした。それぞれが何を得意とし、どこで動き、どうすれば上限をより有効に使えるのか。そのおかげで、勉強は「ついていかなければならないもの」から「楽しめるもの」に変わったのです。